Serie AI-Native · Comparativa de ingeniería de agentes: Prompts · Contexto · Harness · Bucles · Grafos
La ingeniería de contexto es un presupuesto, no una ventana más grande
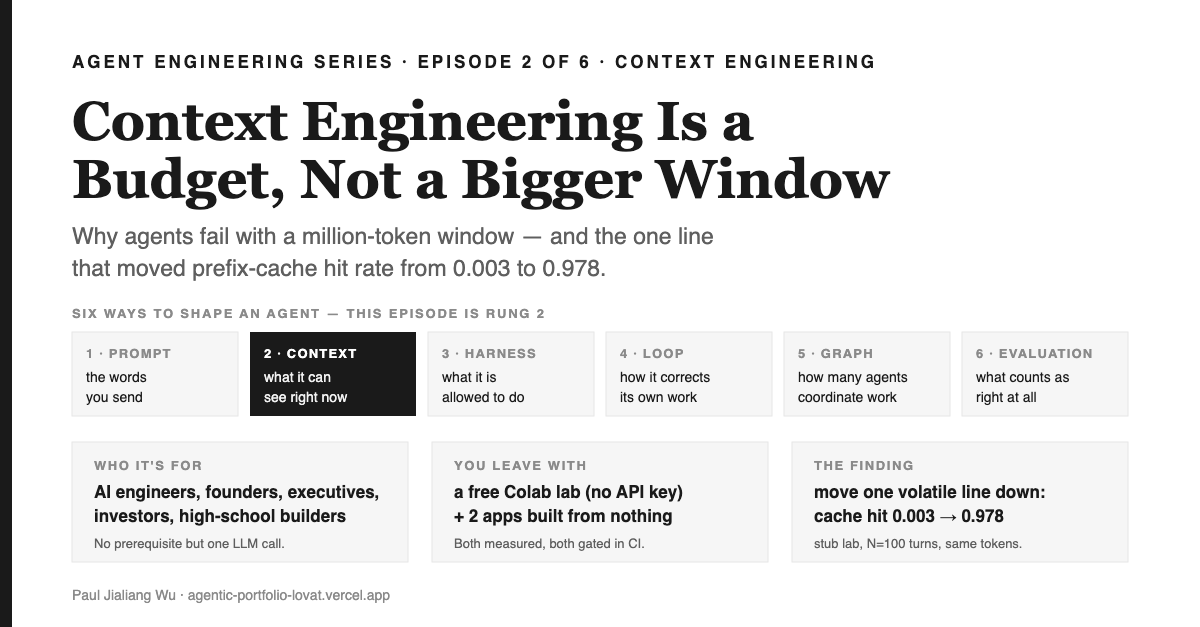
Episodio 2 de 6. Esta serie compara las formas en que se diseñan agentes de IA — ingeniería de prompts, contexto, harness, bucles y grafos, y el sexto peldaño que esta temporada defiende: la ingeniería de evaluación. ¿De dónde viene cada una, qué controla, quién la impulsa y qué principios sobreviven a la medición? Este episodio es el peldaño que la lista habitual de cuatro etiquetas omite: la ingeniería de contexto, y las dos decisiones que una ventana más grande jamás tomará por ti.
Resumen en 1 minuto — lo esencial que te llevas
De qué va esto. Una serie comparativa sobre las formas de diseñar un agente de IA — ingeniería de prompts (las palabras que envías),ingeniería de contexto (lo que el agente puede ver en ese instante), ingeniería de harness (lo que tiene permitido hacer), ingeniería de bucles (cómo corrige su propio trabajo), ingeniería de grafos (cómo se coordinan varios agentes) e ingeniería de evaluación (qué se considera correcto, en última instancia). Este episodio explora la ingeniería de contexto: su historia desde la generación aumentada por recuperación en 2020 hasta 2026, quiénes la impulsan y los principios que sobreviven a la medición.
Por qué importa. Cada mes te llegan dos facturas, y ambas las define la ingeniería de contexto. La primera es dinero: un agente en producción reenvía toda su historia en cada turno, así que si tu prefijo en caché sobrevive o no, eso determina la mayor parte de tu costo de inferencia. La segunda es confianza: un agente que responde usando una política retirada puede sonar seguro y citable, pero está equivocado, y pasa todas las pruebas que tienes. Ninguna de las dos se arregla con una ventana más grande: un estudio liderado por Stanford en 2023 demostró que la precisión depende de dónde está la respuesta en la ventana, y un informe de 2025 sobre 18 modelos mostró que tareas simples se degradan a medida que crece la entrada. Para una persona fundadora, esa es la diferencia entre un demo que cuesta centavos y un producto que cuesta miles. Para una persona ingeniera, son dos cambios que puedes implementar esta misma tarde.
Qué puedes hacer después de leer. Pon un presupuesto de tokens a tu contexto, mide la tasa de aciertos de tu caché de prefijo, mueve todo campo volátil fuera del prefijo y añade una fecha de caducidad a cada hecho en tu almacén de memoria para que la recuperación pueda rechazarlo. Recibes un notebook de Colab gratuito (sin API key) y dos aplicaciones funcionales construidas desde cero: un planificador de comidas familiares donde la fuga de ingredientes caducados baja de 0.750 a 0.000, y un ensamblador de contexto para soporte técnico con una compuerta de CI que hace fallar la compilación si hay desbordamiento de presupuesto, hechos caducados o un prefijo inestable.
Season 7 — la espina de la serie
- Ingeniería de prompts — una especificación, no un hechizo episodio 1
- Ingeniería de contexto — un presupuesto, no una ventana más grande este episodio
- Ingeniería de harness — el envelope, no el agente episodio 3
- Ingeniería de bucles — un árbitro externo, no un reintento episodio 4
- Ingeniería de grafos — una agenda, no un elenco de personajes episodio 5
- Ingeniería de evaluación — la función de verdad, no un leaderboard episodio 6
De qué va este episodio y por qué la ingeniería de contexto es el segundo peldaño
Existen cinco disciplinas nombradas para construir agentes de IA con hitos publicados, y una sexta que esta temporada defiende. Llegaron más o menos en este orden: ingeniería de prompts (2020), ingeniería de bucles (2022), ingeniería de grafos (2023), ingeniería de harness (2024), ingeniería de contexto (2025), con la ingeniería de evaluación siendo antigua como práctica y joven como nombre. La declaración publicada más clara del conjunto es el estudio de Feng et al. (arXiv:2608.21156), que las ordena según lo que cada una te permite controlar, no por antigüedad: prompt → contexto → harness → bucle → grafo. Esta serie las toma una por episodio, en ese orden, y les hace las mismas cuatro preguntas: de dónde viene, qué controlas exactamente, quién la impulsa y qué fallo te hace subir al siguiente peldaño.
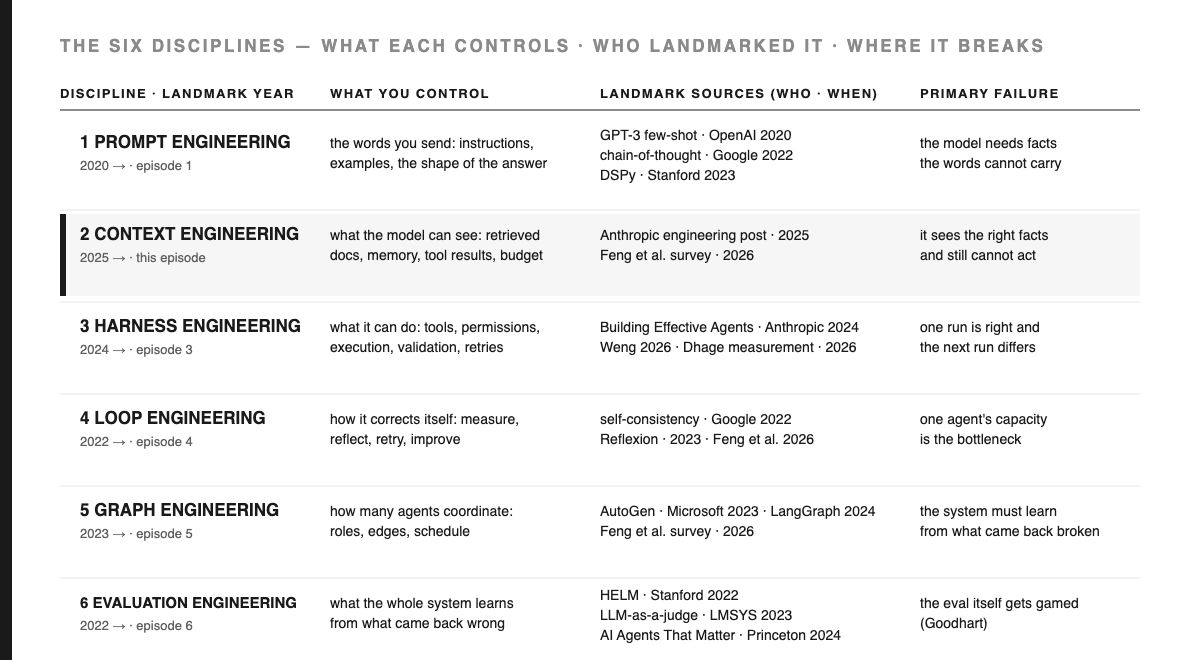
La ingeniería de contexto es el segundo peldaño porque es justo lo que se agota en el primero. El episodio 1 terminó con una tarjeta de receta perfecta que producía dos platillos distintos, y la razón no estaba en la tarjeta. En cuanto tu agente necesita un dato que no estaba en las palabras que enviaste —una política, un precio, la decisión de ayer, el último resultado de una herramienta—, ya no estás editando un prompt. Ahora decides en qué se gasta un recurso escaso.
¿Para quién es esto? Para el ingeniero de IA cuyo agente es impecable en la demo y caro o incorrecto en la tercera semana. Para el fundador que ve cómo la factura de inferencia crece más rápido que el uso. Para el estudiante de preparatoria que quiere entender por qué "solo pega más en el prompt" deja de funcionar. El único requisito: haber llamado a un modelo de lenguaje al menos una vez.
De dónde viene la ingeniería de contexto y quién la impulsa
[DEF] El contexto es todo lo que el modelo puede ver en el momento de responder: el prompt del sistema, las definiciones de herramientas, la conversación hasta ahora, lo que se recuperó, lo que devolvió una herramienta. La ingeniería de contexto es la disciplina de decidir qué entra ahí y qué se queda fuera. Esa es toda la definición. La historia es cómo un truco de recuperación se convirtió en un presupuesto.
| Cuándo | Hito | Quién | Qué cambió |
|---|---|---|---|
| 2020-05 | Retrieval-Augmented Generation (arXiv:2005.11401) | Lewis et al., Facebook AI Research, UCL, NYU | Los hechos salen de los pesos y pasan a la entrada. El modelo lee de un índice en tiempo de generación; lo que "sabe" se vuelve algo que tú ensamblas. |
| 2023-07 | Lost in the Middle (arXiv:2307.03172) | Liu et al., Stanford, Berkeley, Samaya AI | Se mide la ventana y se descubre que no es uniforme: la precisión depende de dónde está la respuesta. La posición se vuelve una variable de ingeniería. |
| 2023-10 | MemGPT (arXiv:2310.08560) | Packer et al., UC Berkeley | Toma prestada la memoria virtual de los sistemas operativos: intercambia hechos dentro y fuera de una ventana pequeña. La ventana se convierte en RAM, no en un archivador. |
| 2025-06 | El término es bautizado y amplificado (simonwillison.net) | Tobi Lütke, Shopify; Andrej Karpathy | Dos publicaciones le pusieron un nombre a la práctica que se quedó, porque "ingeniería de prompts" ya se había convertido, para la mayoría, en sinónimo de escribirle a un chatbot. |
| 2025-07-02 | Ingeniería de contexto (langchain.com/blog) | El equipo de LangChain | Cuatro acciones sobre las que puede intervenir un practicante: escribir, seleccionar, comprimir, aislar. Es la primera taxonomía con una implementación real detrás. |
| 2025-07-14 | Context Rot (research.trychroma.com) | Hong, Troynikov, Huber, Chroma | 18 modelos, tareas mantenidas deliberadamente simples, variando solo la longitud de entrada. La promesa de "ahora tenemos un millón de tokens" se pone a prueba en un experimento controlado. |
| 2025-07-18 | Lecciones de construir Manus (manus.im/blog) | Yichao "Peak" Ji, Manus | La visión de producción: la tasa de aciertos de la KV-cache como la métrica que define tu factura, y la estabilidad del prefijo como el mecanismo que la protege. |
| 2025-09-29 | Ingeniería de contexto efectiva para agentes de IA (anthropic.com/engineering) | Anthropic | Un laboratorio de modelos plantea de forma explícita el enfoque del presupuesto: un recurso finito, un presupuesto de atención y el objetivo de lograr el conjunto de señales útiles más pequeño posible. |
| 2026-08 | La encuesta de la escalera (arXiv:2608.21156v2) | Feng et al. | La ingeniería de contexto aparece como el segundo peldaño de la escalera de paradigmas, definida como la gestión del acceso a la información. |
[DISEÑO]Tres detalles a resaltar. La práctica es cinco años más antigua que el nombre: RAG en 2020 ya era ingeniería de contexto, solo que no sabía cómo llamarse. Los dos posts de 2025 que la bautizaron no fueron papers, sino un CEO y un exdirector de laboratorio en redes sociales, y la etiqueta pegó porque la anterior ya estaba desgastada por el uso. Y los resultados más contundentes aquí son mediciones que contradicen el marketing.mediciones que desmontan el marketing: el mismo año en que los proveedores anunciaron ventanas de un millón de tokens, dos grupos independientes publicaron evidencia de que una ventana más grande no se aprovecha de forma uniforme.
Quién mueve esto hoy. Los laboratorios de modelos escriben la guía y controlan el comportamiento de caché contra el que tú optimizas. Los equipos de producto de agentes — Manus es el ejemplo público más claro — publican los números operativos, porque son quienes pagan la factura a escala. Los proveedores de frameworks convierten las prácticas en valores predeterminados. Las empresas de infraestructura de retrieval financian las mediciones adversariales, lo cual es un arreglo saludable: quienes venden retrieval tienen el mayor incentivo para demostrar que llenar la ventana no es un sustituto. La academia aporta una de las dos mediciones fundamentales — Liu et al., Stanford y Berkeley; el resto viene de la industria, que es el verdadero perfil de este peldaño.
El modelo mental de la serie: la escalera de la cocina
Una imagen sostiene los seis episodios, así que aquí la tienes de nuevo, planteada como herramienta y no como historia. Todo cocinero sube la misma escalera: primero para sí mismo, luego para su familia, después en una cocina de restaurante, luego en una cadena de comida rápida, después en la cadena nacional de suministro que alimenta a varias cadenas — y por encima de todo, el registro de devoluciones. Todo ingeniero de IA escala una igual, de aprendiz escolar a líder de frontera, y cada peldaño de la ingeniería de agentes es una cocina en esa escalera.
El episodio 1 representa la tarjeta de recetas: tú la escribes, un cocinero con el que no puedes hablar prepara el plato, y todo tiene que caber en la tarjeta de antemano.El segundo peldaño es la despensa y la encimera. Ahora cocinas para tu familia, varias veces por semana, en una cocina que se va llenando. La tarjeta sigue importando. Pero entre martes y viernes la despensa se llenó, y la encimera — esa superficie pequeña donde realmente ocurre la acción — es donde se gana o se pierde cada plato.
| Peldaño | Cocina | Quién eres | Qué puedes moldear |
|---|---|---|---|
| 1. prompt | la tarjeta de recetas — cocinas para ti | aprendiz escolar | las instrucciones escritas desde las que trabaja el cocinero |
| 2. contexto | la despensa y la encimera — cocinas para la familia | desarrollador junior | lo que está sobre la encimera y qué tan fresco está mientras se cocina |
| 3. harness | la cocina del restaurante | desarrollador senior | las estaciones, las herramientas al alcance y el pase donde se revisa cada plato |
| 4. bucle | la cadena de comida rápida | líder técnico de IA | probar, medir, corregir y desplegar la solución en todas las sucursales |
| 5. grafo | la cadena nacional de suministro | CTO | muchas cocinas, un solo horario, una sola flota de camiones |
| 6. evaluación | el registro de devoluciones | líder de frontera | lo que todo el sistema alimentario aprende de lo que salió mal |
La despensa es todo lo que tienes: estantes, congelador, el fondo del refrigerador. La encimera es lo que está afuera ahora mismo, al alcance de la mano, mientras cocinas. No son lo mismo, y confundirlas es justo el tema de este episodio. Nadie ha mejorado una cena por tener más frascos. Lo que decide la cena es lo que llega a la encimera — y si algo de eso ya está echado a perder.
Dos ejes, no uno. No es una escalera que subes y dejas atrás: toda cocina tiene las seis capas a la vez. Un cocinero casero tiene una tarjeta, una despensa, una estufa, un gusto, un proveedor y una memoria de lo que salió mal la última vez. Lo que cambia al subir es cuántas capas puedes tocar y con qué rigor ejecutas cada una: primero a ojo, luego midiendo, después con compuertas, y finalmente autocorrigiendo. Una cadena nacional con un diagrama decorativo de la cadena de suministro pero sin política de caducidad es menos madura que una cocina familiar que pone fecha a cada frasco. Así que las disciplinas son capas (lo que controlas); la senioridad es madurez (cómo las ejecutas); y "grafo" no es automáticamente más avanzado que "bucle".
La analogía sirve para ilustrar, no para evidenciar. Cada elemento está anclado a una cosa concreta en el código, en el mapa técnico 1:1 de abajo. Y un objeto del final del Episodio 1 sigue aquí:el frasco que alguien dejó abierto junto a la sal. No le pierdas la pista. Nos va a costar dinero real en unas novecientas palabras.
La escalera no es mía
[DEF] El vocabulario, anclado a su fuente — porque varios nombres compiten por este territorio y la mayoría de las listas lo ponen mal.
La declaración publicada más clara de la escalera es el estudio de Feng et al. (arXiv:2608.21156, revisado 2026-08-26). Define este peldaño en seis palabras:"Context Engineering to manage information access" (Traducción: Ingeniería de contexto para gestionar el acceso a la información) — situada entre la ingeniería de prompts, que saca a relucir lo que el modelo ya puede hacer, y la ingeniería de harness, que organiza lo que el modelo puede alcanzar.
Las definiciones de los practicantes llegaron primero. Tobi Lütke, de Shopify, en junio de 2025, la llamó "the art of providing all the context for the task to be plausibly solvable by the LLM" (Traducción: el arte de proporcionar todo el contexto necesario para que la tarea sea razonablemente resoluble por el LLM); Andrej Karpathy la amplificó días después como "the delicate art and science of filling the context window with just the right information for the next step" (Traducción: el delicado arte y ciencia de llenar la ventana de contexto con la información justa para el siguiente paso). Ambas citas provienen de la nota de Simon Willison del 27-06-2025, que es el artefacto que leí.
[DISEÑO] Observa lo que las tres definiciones comparten y lo que se perdió en el uso popular. Lütke habla de todo el contexto; Karpathy, de la información justa; Feng et al., de gestionar el acceso. Ninguno menciona "más". La disciplina nació como un problema de curaduría y se practica rutinariamente como uno de acumulación, y la distancia entre esas dos interpretaciones es de donde salen la mayoría de las facturas de agentes.
La afirmación, clasificada
[DEF] La ingeniería de contexto es un presupuesto, no un contenedor. Un presupuesto tiene tres propiedades que un contenedor no: es finito, se gasta y en qué lo gastas es una decisión que tomas en cada turno. Además, tiene una organización — porque en este presupuesto, la posición de un token cambia cuánto cuesta y qué tan bien se lee.
[EVIDENCIA] Empecemos por la posición, porque es la parte más antigua y más medida de la afirmación. Liu et al. pusieron la misma información en distintos lugares dentro de la ventana y midieron la precisión:
"performance is often highest when relevant information occurs at the beginning or end of the input context, and significantly degrades when models must access relevant information in the middle of long contexts, even for explicitly long-context models" (Traducción: el rendimiento suele ser mayor cuando la información relevante aparece al principio o al final del contexto de entrada, y se degrada significativamente cuando los modelos deben acceder a información relevante en el medio de contextos largos, incluso en modelos diseñados explícitamente para contextos largos)
— Liu et al., Lost in the Middle, arXiv:2307.03172
La última frase es la que hay que mirar de cerca: incluso en modelos diseñados explícitamente para contextos largos. Una ventana más grande no arregla esto, porque es una cuestión sobre la forma de la atención a lo largo de la ventana, no sobre su tamaño. (El artículo apareció en TACL en 2024; comparé el resumen publicado con el de arXiv y son idénticos palabra por palabra.)
[EVIDENCIA] El informe técnico de Chroma de 2025 clava el mismo cuchillo desde el otro lado. Mientras que Lost in the Middle varió la posición, Chroma varió la longitud y mantuvo constante la dificultad: "Each task remains intentionally simple and is deliberately controlled to isolate the impact of context length alone." (Traducción: "Cada tarea se mantiene intencionadamente simple y se controla de forma deliberada para aislar únicamente el impacto de la longitud del contexto.") En 18 modelos, el resumen es directo — "models do not use their context uniformly; instead, their performance grows increasingly unreliable as input length grows." (Traducción: "los modelos no usan su contexto de manera uniforme; en cambio, su rendimiento se vuelve cada vez menos confiable a medida que crece la longitud de la entrada.") Anthropic adoptó el término en su propia publicación de ingeniería y sacó la conclusión que da nombre a este episodio: "Context is a critical but finite resource for AI agents." (Traducción: "El contexto es un recurso crítico pero finito para los agentes de IA.")
[EVIDENCE] Ahora, el tema del dinero: la mitad que suele pasar desapercibida y que te llega cada mes. Un bucle de agente reenvía toda su historia en cada turno, así que la proporción entrada/salida no se parece en nada a la de un chatbot — Manus reporta la suya cerca de 100:1. Un solo número domina la factura:
"If I had to choose just one metric, I'd argue that the KV-cache hit rate is the single most important metric for a production-stage AI agent." (Traducción: "Si tuviera que elegir solo una métrica, diría que la tasa de aciertos de la KV-cache es la métrica más importante para un agente de IA en producción.")
— Yichao "Peak" Ji, Manus, 2025-07-18
Y la forma en que esa métrica se destruye es tan sutil que parece un detalle menor: "A common mistake is including a timestamp—especially one precise to the second—at the beginning of the system prompt." (Traducción: "Un error común es incluir una marca de tiempo—especialmente una precisa al segundo—al inicio del prompt del sistema.") La caché es una caché de prefijo. Se reutiliza para la secuencia más larga de tokens que tu solicitud comparte con la anterior, desde el principio. Si cambias un token en la posición doce, todo lo que sigue a partir de ahí se vuelve a rellenar en cada turno posterior, para siempre.
[DERIVATION] Si juntas las tres cosas, la regla no es "mantén pequeño tu contexto". Es más precisa que eso, y en realidad son dos reglas:
- La organización es una decisión de costo. Todo lo que cambia entre turnos debe ir al final del contexto, nunca en el prefijo. La posición no es cosmética: tiene precio.
- La frescura es una decisión de corrección. Un hecho que no puede fecharse no puede ser rechazado. Si tu almacén de memoria no tiene un campo de expiración o de supersesión, ninguna calidad de recuperación puede evitar que se cite una política retirada, porque la caducidad no es una propiedad que tu recuperador pueda ver.
[DESIGN] El argumento del proveedor merece una escucha justa, no una burla. Los anuncios de contextos largos son ciertos, y para tareas de un solo disparo — lee este contrato, responde esta pregunta — un millón de tokens es una capacidad real que no existía en 2023. Lo que no se sigue es la inferencia que todos hacen: que la curaduría ahora es opcional. Chroma probó exactamente esa inferencia bajo condiciones controladas y la encontró falsa incluso para tareas simples. Y la factura no cambia en ningún caso: una ventana más grande hace que un contexto sin curar sea más barato en exactamente cero.
[OPEN] Dos límites honestos. Ambas mediciones se refieren a tareas de recuperación; ninguna demuestra que la curaduría siempre supere al relleno en tareas de razonamiento. Además, la economía del caché depende de cada proveedor: la diferencia de 10× entre entrada cacheada y sin cachear que cita Manus para una familia de modelos es solo un precio de lista en un momento específico, no una ley universal. Haz tus propios cálculos antes de citar mi aritmética.
Mapa técnico 1:1
Cada elemento de la metáfora corresponde exactamente a algo que puedes señalar en el código. Una metáfora puede introducir una afirmación, pero nunca sirve como evidencia; así que aquí tienes la traducción, sin adornos.
| La cocina | El sistema | Dónde vive |
|---|---|---|
| la despensa — todo lo que tienes | el corpus y la memoria | tu índice, tus archivos, el historial de tickets |
| la encimera — lo que está fuera mientras cocinas | el contexto ensamblado para este turno | messages[] tal como se envía |
| cuánto mide la encimera | el presupuesto de contexto | MAX_CONTEXT_TOKENS, un número que eliges |
| decidir qué sale de la despensa | recuperación, filtrado y empaquetado | score → filter → pack, en ese orden |
| la fecha de caducidad del frasco | el sello de caducidad o de supersesión | expires, superseded_by |
| el frasco que alguien dejó abierto junto a la sal | un hecho caducado que sigue en contexto | una cláusula de política retirada que el modelo citará |
| la mise en place que nunca se mueve | el prefijo anclado | system prompt + esquemas de herramientas, idénticos byte a byte |
| un reloj clavado sobre la mesa de preparación | un campo volátil dentro del prefijo | una marca de tiempo precisa al segundo |
| el estante al que nunca logras llegar bien | la zona media de una ventana larga | la región Lost in the Middle mide |
| limpiar la encimera entre platillos | compresión que se puede restaurar | eliminar el cuerpo de la página y conservar solo la URL |
| anotar en un ticket y colgarlo | memoria externalizada | un archivo que el agente escribe y luego vuelve a leer |
[DEF] Los tres números sobre los que se apoya el resto de este episodio, definidos una sola vez:
- Tasa de aciertos de la caché de prefijo — en una serie de ejecuciones, la fracción de tokens de entrada servidos desde la caché en vez de ser rellenados de nuevo. No dice nada sobre calidad. Es, simplemente: cuánto de lo que enviaste ya lo habías pagado.
- Tasa de fuga de hechos caducados — sobre N respuestas, la fracción que utiliza al menos un hecho que ya había caducado o había sido reemplazado. No evalúa la fluidez. La respuesta puede ser impecable y citar una cláusula retirada.
- Desbordamiento de presupuesto — en N ensamblados, la cantidad que supera el presupuesto de tokens declarado. No es "degradado": un contexto que excede el presupuesto será truncado por alguien que no eres tú, desde el extremo que prefiera el proveedor.
Compuerta de Predicción
Antes de seguir, comprométete. Escribe tu respuesta — el sentido de este ejercicio es que una predicción que no anotaste es una predicción que vas a recordar como acertada.
Q1. Un agente ejecuta 100 turnos. Su system prompt comienza con la hora actual, precisa al segundo. Todo lo demás solo se agrega. ¿Qué fracción de sus tokens de entrada vendrán servidos desde la caché de prefijo?
Q2. Mueves esa línea del principio del system prompt a la última línea antes de que el modelo responda. Mismos tokens, misma información. ¿Qué pasa con la tasa de aciertos y qué pasa con la factura?
Q3. Tu memoria no tiene campos de caducidad y aproximadamente una cuarta parte está desactualizada. Quieres reducir la frecuencia con la que las respuestas usan hechos caducados. Ordena estos por efecto, de mayor a menor: (a) duplicar el presupuesto de contexto, (b) mejorar el ranking del recuperador, (c) añadir un campo de caducidad y filtrar por él antes de puntuar.
Las respuestas están en la Sala de Fallos y en el Notebook. Si tu instinto en la P3 fue (b), estás en buena compañía y el barrido en la celda 6 te va a valer los quince minutos.
Sala de Fallos
Rompe el sistema a propósito. Un mecanismo que no puedes romper es solo una afirmación, no un mecanismo.
Fallo 1 — "la ventana ahora es de un millón de tokens, así que esto está resuelto." La creencia más común en este peldaño y la que más contra-evidencia publicada tiene. Chroma mantuvo la dificultad constante y solo varió la longitud de entrada en 18 modelos; el rendimiento igual se degradó. Liu et al. mantuvieron la longitud constante y solo variaron la posición; la precisión igual cambió, incluyendo explícitamente modelos de contexto largo. Un mostrador más grande es realmente útil y no cambia ninguno de los dos resultados — y no afecta en absoluto a los dos números que mide este episodio.
Fallo 2 — "tenemos caching activado, así que estamos bien." El caching no es una casilla, es una propiedad del prefijo, y se destruye con detalles que parecen buena ingeniería. Un timestamp para que el modelo sepa la hora. Un id de sesión para trazabilidad. Una línea "user tier: pro" para que la persona se adapte. Una lista de herramientas reordenada porque tu serializador JSON no garantiza el orden de las claves. Cada uno es un token, al frente, y cada uno te cuesta todos los tokens que siguen. En el laboratorio, ese error lleva la tasa de aciertos a 0.003 — y nada da error, nada avisa, y el dashboard que lo habría detectado es el que nadie construyó.
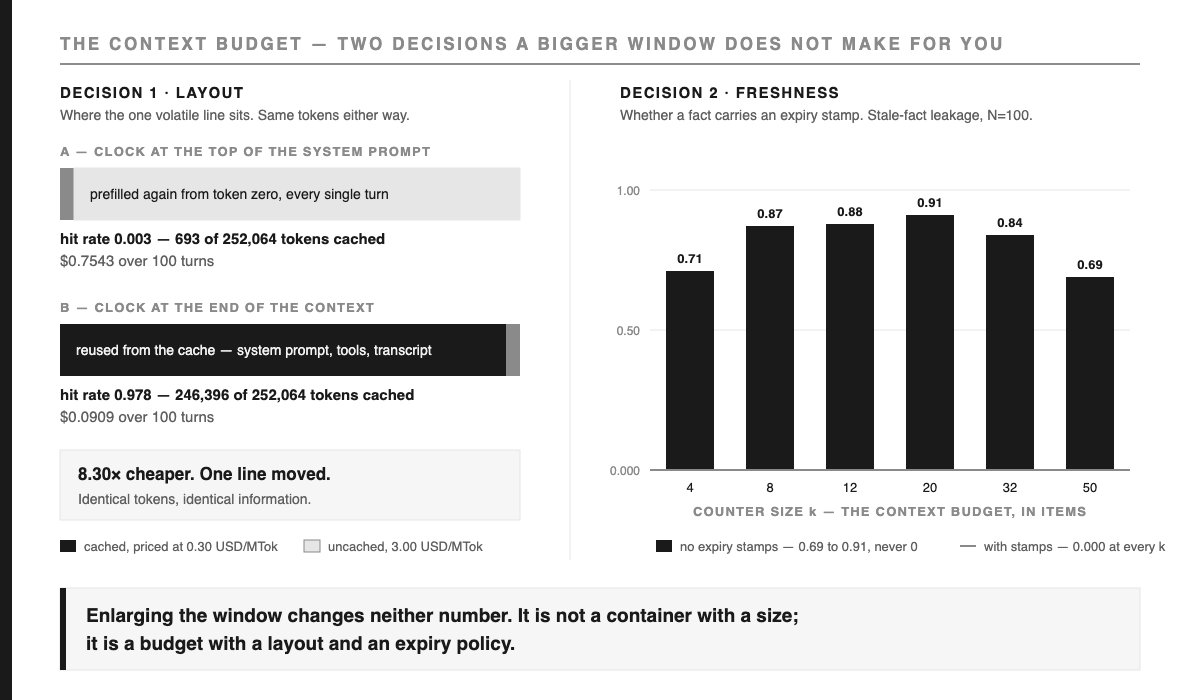
Fallo 3 — "recupera mejor." La trampa para la que existe el barrido. Un mejor ranking solo cambia qué elementos caducados llegan primero; no evita que lleguen, porque la caducidad es invisible para un ranker que no puede ver una fecha. En el laboratorio, la fuga sin campos de caducidad está entre 0.690 y 0.910 para cualquier tamaño de mostrador de 4 a 50 y nunca llega a cero; con campos de caducidad es 0.000 en todos. Eso no es un mejor recuperador — es una pregunta distinta, hecha antes de que corra el recuperador.
Fallo 4 — la métrica que marca 0.000 y no significa nada. Lleva la fuga a cero poniendo casi nada en contexto. Felicidades: tu agente está confiablemente desinformado. Es la misma forma que la métrica de determinismo del Episodio 1 marcando 1.000 en un objeto vacío, y por eso el proyecto fridge-list reporta cuántos ingredientes realmente nombró el plan junto a la tasa de fuga. Una métrica de curación sin una métrica de utilidad al lado es una invitación a hacer trampa.
Respuesta a la P3: (c), luego (b), luego (a) — y (a) no solo es el último, sino que probablemente tiene el signo equivocado. Subir el presupuesto de k=4 a k=20 llevó el número medio de elementos caducados en el mostrador de 1.08 a 9.25 — e incluso una sola duplicación, de k=4 a k=8, lo llevó de 1.08 a 2.90. No diluiste el problema. Invitaste a que entrara más.
Notebook
Laboratorio 02 — Estabilidad del prefijo y el presupuesto. 
labs/02_context_budget.ipynb · Colab gratis · sin API key · ~2 segundos de CPU · cada celda ejecutada antes de publicar · la esencia también abarca ambos proyectos.
Siete celdas, dos partes. Primero: un tokenizador de prueba (un token por cada cuatro caracteres) junto con el único modelo de caché que realmente importa: la KV-cache se reutiliza para el prefijo común más largo entre esta petición y la anterior. Segundo: un archivo de despensa, un ensamblador y una métrica de filtrado de hechos caducados.
- El tokenizador y el modelo de caché de prefijo, usando los precios de lista publicados como referencia de costos.
- El contexto del agente, ensamblado de dos maneras: un reloj al inicio del system prompt, o el mismo reloj como última línea antes de la respuesta.
- La medición sobre N=100 turnos. Lee primero la columna de tokens: es idéntica en ambos casos.
- La despensa: 40 artículos, 11 de ellos ya caducados, cada uno con una
addedfecha y, opcionalmente, unaexpiresfecha. - El ensamblador y la métrica de fuga de hechos caducados, con un tamaño de encimera de 12.
- El barrido, y la celda que vale la pena copiar. Varía el tamaño de la encimera y observa cómo las dos intervenciones se separan.
- El puente: reemplaza dos funciones y la misma medición corre contra un endpoint real.
[EVIDENCIA] Celda 3, exactamente como la imprimió la ejecución:
arrangement                        input tok    cached  hit rate   cost USD
volatile field at the TOP            252,064       693     0.003     0.7543
volatile field at the END            252,064   246,396     0.978     0.0909

cost ratio (top / end)          : 8.30x
cost delta over 100 turns       : $0.6634
Mismos tokens. La misma información disponible en el momento en que el modelo responde. Una línea se movió del principio al final, y el 8.30× de la factura de entrada se evapora. Fíjate en lo que no ocurrió: sin error, sin advertencia, sin salida degradada. La versión cara funciona perfectamente — y por eso sobrevive la revisión de código.
[EVIDENCIA] Celda 6 es la que me hizo cambiar de opinión mientras escribía el esquema, y el veredicto se calcula en tiempo de ejecución en vez de afirmarse por adelantado, para que pudiera contradecirme — y lo hizo, de una forma que casi borro:
| tamaño de encimera k | fuga: sin sellos | fuga: con sellos | media de artículos caducados en la encimera |
|---|---|---|---|
| 4 | 0.710 | 0.000 | 1.08 |
| 8 | 0.870 | 0.000 | 2.90 |
| 12 | 0.880 | 0.000 | 4.98 |
| 20 | 0.910 | 0.000 | 9.25 |
| 32 | 0.840 | 0.000 | 11.00 |
| 50 | 0.690 | 0.000 | 11.00 |
[ABIERTO]La lectura honesta de esa tabla, incluyendo la parte que va en contra de mi argumento. La fuga sin sellos no es monótona en k: sube a 0.910 en k=20 y baja a 0.690 en k=50. Mi primer impulso fue eliminar las dos últimas filas, y hacerlo habría sido recortar a favor de mi tesis. La razón: la despensa tiene 40 artículos, 11 caducados, así que para k=32 ya todos los caducados están sobre la encimera — la cuarta columna se queda fija en 11.00 — y aumentar k solo añade artículos frescos, mientras el cocinero de prueba sigue nombrando los mismos cuatro. La tasa por respuesta se diluye aunque la contaminación de la encimera sea total. Eso es un artefacto del stub, y vale la pena decirlo en voz alta, porque es exactamente la forma de un error real de reporte: una tasa puede mejorar mientras el estado subyacente empeora. La afirmación que sobrevive es la que respalda toda la columna: sin sellos, la fuga nunca llega a cero con ningún presupuesto; con sellos, es 0.000 en todos los casos.
[DISEÑO]Por qué un stub. Un simulador reproduce dónde entra un costo y qué lo elimina, en dos segundos, gratis y sin clave. No reproduce magnitudes. Nada de lo que imprime el notebook es evidencia del efecto de posición de Liu et al. ni de las curvas de degradación de Chroma; solo esas fuentes pueden citarse para eso. El 8.30× es aritmética sobre tokens de prueba con precios de lista publicados aplicados — la proporción es el hallazgo, los dólares son ilustrativos. La celda 7 es el puente honesto: cambia el tokenizador y el cocinero de prueba, y el código de medición no cambia.
Proyectos
Dos proyectos, desde cero — sin frameworks ni dependencias fuera de la biblioteca estándar. Ambos se ejecutaron antes de escribir esta sección, así que cada número de abajo es medido, no predicho.
Proyecto 1 — vida real:the-fridge-list
projects/02-real-fridge-list/ · python3 fridge_list.py 100
Un planificador de comidas familiares cuyo contexto completo es un solo archivo,pantry.json. Lee la despensa, pone doce artículos sobre la encimera y escribe las cenas de la semana con lo que puede ver. Nadie pone fechas de caducidad en un archivo de texto que escribió para sí mismo, y por eso es el primer proyecto correcto. Un archivo de despensa distinto y un cocinero de prueba diferente al del laboratorio — misma estructura, así que la tasa no es la 0.880 del laboratorio.
pantry: 40 items, 11 already expired on 2026-09-11 · N=100 weekly plans · k=12

pantry file                   leakage rate   stale items named   of items named
WITHOUT expiry stamps                0.750                 134              242
WITH expiry stamps 0.000 0 372[EVIDENCIA]Tres cuartas partes de los planes le dicen a la familia que cocine con algo ya caducado, y los planes son fluidos, sensatos y erróneos. El número que no esperaba es el último: con sellos, el planificador nombra más ingredientes — 372 contra 242 — no menos.
Eso invierte la intuición que hace que muchos se salten este trabajo. Filtrar no redujo la encimera; la encimera son doce artículos de cualquier modo. Reemplazó doce espacios de los cuales cinco eran inutilizables por doce que sí lo son, así que se pudieron planear más comidas.Curar no es restar.Es el mismo presupuesto gastado en cosas que sí funcionan — el argumento de Anthropic sobre high-signal-tokens, llegando aquí desde un refrigerador.
Proyecto 2 — empresa:the-desk-memory
projects/02-enterprise-desk-memory/ · make measure · make gate
Un ensamblador de contexto para mesa de soporte. Ticket de entrada, contexto ensamblado de salida, con un presupuesto de tokens y tres invariantes validados en CI. La base de conocimiento son 144 fragmentos — cláusulas de política versionadas, resoluciones pasadas y notas estacionales fechadas — de los cuales 30 están caducados: 16 versiones de política superadas y 14 notas expiradas.
[EVIDENCIA]Un invariante eliminado a la vez, N=100 tickets cada uno:
what was removed          budget_overflows   stale_fact_leaks   distinct prefixes   exit
nothing                                  0                  0                   1      0
the budget packer                      100                  0                   1      1
the freshness filter                     0                100                   1      1
the stable prefix                        0                  0                 100      1
make gatesale 0.make gate-off— el mismo gate con el filtro de frescura eliminado — sale 1.make gate-removedelimina cada invariante por turno y afirma que cada eliminación falla, porque una compuerta que nunca has visto fallar es solo una esperanza, no una compuerta real.
Lee la segunda fila con atención, porque es la que te va a pasar. Quitar el empaquetador de presupuesto no genera ningún error: ensambla 1,420 tokens en promedio y 1,481 en el peor caso para una encimera de 1,200 tokens y los entrega, y un proveedor real trunca — en silencio, desde el extremo que prefiera — así que el dato que más necesitabas es el que se cae. Y aquí está nuestro frasco. La tercera fila es una cláusula de reembolso superada sentada sobre la encimera, citada en cien respuestas de cien. Parecía exactamente una política. Era una política, en marzo.
Constrúyelo en 30 minutos — el contrato
Todo lo que necesita el ensamblador, en el orden en que lo pedirá un ingeniero. Entradas: un ticket y una base de conocimiento. Salida: un contexto ensamblado. Invariante: nada entra si no puede fecharse, y nada se empaqueta si no cabe. Regla de paro: al llegar al presupuesto, se detiene — nunca trunques el prefijo para hacer espacio.
PINNED_PREFIX = system_prompt + tool_schemas   # byte-identical on EVERY request:
                                               # no clock, no session id, sorted keys
SNIPPET = {                                    # the minimal shape of a memory row
  "id":            str,
  "text":          str,
  "expires":       date | None,                # the field that makes refusal possible
  "superseded_by": id   | None,
}
def assemble(ticket, kb, budget=MAX_CONTEXT_TOKENS):
    pool   = [s for s in kb if is_fresh(s)]           # 1. FILTER — before anything else
    ranked = sorted(pool, key=lambda s: -score(s, ticket))   # 2. SCORE
    out, used = [], n_tokens(PINNED_PREFIX)
    for s in ranked:                                  # 3. PACK, newest-relevant first
        if used + n_tokens(s.text) > budget: continue
        out.append(s); used += n_tokens(s.text)
    return PINNED_PREFIX, out, used

# CI gate (make gate): N=100 tickets
#   budget_overflows             == 0
#   stale_fact_leaks             == 0
#   distinct_prefix_fingerprints == 1     (sha256 of the pinned prefix, per request)
# any line off threshold → exit 1 → the build fails
Deliberadamente ausente de ese bloque: una métrica de corrección de respuesta (la brecha honesta, abajo), reranking (mueve el orden, no la elegibilidad), y un modelo en vivo.
[DISEÑO] Cuatro características hacen que este proyecto sea de nivel empresarial y no solo una demo, y cada una tiene su razón de ser:
- Filtra antes de puntuar, nunca después. Si eliminas una cláusula caducada después de empaquetar, ya desplazaste una fresca que sí habría entrado. Es el mismo principio que la compuerta de planes del Episodio 1, que valida antes de que corra cualquier herramienta, no después: filtrar al final solo limpia el registro.
- El prefijo se verifica con huella digital, no solo por intención. La compuerta calcula el hash del prefijo fijado en cada solicitud y exige exactamente un valor idéntico en las 100. “Mantenemos el prefijo estable” es una creencia; un sha256 sobre N=100 es un hecho, y es la única versión que sobrevive cuando alguien añade un timestamp bien intencionado.
- La supersesión es un campo de primera clase, no una convención.
superseded_byRetira una fila sin borrarla, así una auditoría puede leer lo que se le dijo al usuario en marzo aunque el ensamblador se niegue a servirlo hoy. Borrar la fila destruye la auditoría; dejarla sin fecha destruye la respuesta. - El desbordamiento es un fallo de compilación, no solo una advertencia. El proveedor “gestiona” un contexto que excede el presupuesto truncándolo — una decisión sobre qué dato pierde tu cliente, tomada por una API, en silencio. Poner la compuerta en cero te devuelve esa decisión.
[ABIERTO] Lo que ninguno de los proyectos demuestra. Ambos corpus son sintéticos y ambos cocineros son stubs. El estado honesto del build empresarial es ejecutable y con compuerta, no desplegado y medido. ¿Qué lo haría real? Una base de conocimiento tomada de un escritorio real, con su historial auténtico de supersesión, y una métrica de corrección de respuestas reportada junto a las tres invariantes — porque un contexto fresco, pequeño y estable aún puede ser el contexto equivocado, y ninguno de estos tres números lo notaría.
Misma historia, cinco salidas
Un solo eje, luego una puerta para cada lector. Toma una decisión y una acción; deja el resto.
| Si eres | La decisión que cambia este episodio | Una acción para esta semana |
|---|---|---|
| un estudiante de preparatoria | La ingeniería de contexto es decidir qué va sobre la encimera, no tener una despensa más grande. | Corre el laboratorio en Colab (2 segundos, sin API key) y explícale el modelo despensa-encimera a un amigo. |
| un ingeniero de IA | El costo lo determina la organización del prefijo; la corrección, si un hecho puede fecharse. | Haz un grep a tu system prompt buscando cualquier campo que cambie en cada solicitud. Muévelo al final. Mide la tasa de aciertos antes y después. |
| un fundador | Si tu factura de inferencia crece más rápido que el uso, casi siempre es un problema de organización de la caché, no de precios. | Pídele a tu equipo la tasa de aciertos de la caché de prefijo. Si nadie la tiene, ahí está el hallazgo. |
| un ejecutivo | "Which version of the policy did the agent answer from?" is an audit question with a schema answer. (Traducción: "¿De qué versión de la política respondió el agente?" es una pregunta de auditoría que se responde con el esquema.) | Exige que cada fila que el agente pueda recuperar tenga un campo de caducidad o de supersesión, antes del próximo lanzamiento. |
| un inversionista | El foso está en la capa de curación y sus compuertas, no en el tamaño de la ventana que alquila el equipo. | Pídele a cualquier startup de agentes la tasa de aciertos de caché y la fuga de hechos caducados, una junto a la otra. Si falta una, es puro teatro. |
Misión Realidad
Quince minutos, con algo que ya ejecutas esta semana.
- Imprime los bytes exactos que envías en dos turnos consecutivos de un agente real — no lo que crees que envías, sino lo que realmente viaja por el cable.
- Haz un diff. Encuentra el primer byte que cambia. Todo lo que sigue se vuelve a rellenar en cada turno, para siempre.
- Si ese byte es un reloj, un id, un tier, un orden aleatorio de herramientas o una fecha formateada, muévelo al final del contexto. Nada más cambia.
- Abre tu almacén de memoria y hazle una sola pregunta al esquema: ¿puedo saber, solo por la fila, si sigue siendo cierto? Si la respuesta es no, no tienes un problema de recuperación, sino una columna que falta.
- Agrega la columna. Filtra por ella antes de puntuar. Vuelve a ejecutar lo que antes confiabas.
Si el paso 2 no arroja nada porque tu agente envía un prompt nuevo cada vez, has aprendido algo más útil: sigues en el primer peldaño y el mostrador aún no empieza a llenarse. Pero lo hará.
Desafío de investigación
Entrégale esto a un agente y pre-registra la predicción antes de ejecutarlo — un resultado que no predijiste es uno que vas a racionalizar.
Toma una tarea de recuperación con respuesta verificable y un corpus donde una fracción conocida de filas está supersedida. Mantén fijo el modelo y la tarea. Varía dos cosas de forma independiente: el presupuesto de contexto (cuatro valores, de ajustado a 10× el tamaño necesario) y la política de frescura (ninguna · filtrar por caducidad · filtrar más rerank ponderado por recencia). Reporta precisión de respuesta, fuga de hechos caducados, tasa de aciertos de caché de prefijo y costo para las doce combinaciones, e informa fuga por respuesta y contaminación por contexto por separado.
Pre-registra:si la precisión es monótona respecto al presupuesto, y si las dos métricas de fuga alguna vez se mueven en direcciones opuestas.
Mi propio stub dice que esas dos métricas sí se separan con presupuestos grandes, por una razón que es un artefacto del stub. Si se separan en un modelo real, por una razón real, eso es justo lo que nadie ha publicado — y si ocurre, tienes un resultado digno de escribirse, no solo un bug en tu setup.
Qué ha cambiado
Estado de este peldaño al momento de publicación. Generado a partir de una sincronización semanal en vivo de 30 fuentes pionerasresearch-anything (make watch-sync), clasificadas por señal técnica y nunca por alcance de audiencia.
Fecha de sincronización: 2026-09-11.
- arXiv:2609.11728 (2026-09-10) — Reproducibility in the Age of Agentic AI: Context Engineering at the Timescale of a Codebase. Un día de antigüedad al momento de publicación: prácticas de investigación reproducible — tests, historial de commits, estructura del repositorio, registros de decisiones — leídas como ingeniería de contexto para agentes programadores, con la autora insistiendo en que los investigadores sigan siendo responsables de verificar los artefactos.
- arXiv:2608.23992 (2026-08-25) — Hybrid Semantic Tool Discovery for Enterprise MCP Gateway. El dato de producción que este episodio habría querido medir por sí mismo: en PayPal, exponer más de 2,000 herramientas en más de 200 servidores consumía 140,200 tokens, el 70.1% de la ventana de contexto, antes de que llegara la pregunta del usuario. Reemplazar el volcado por dos herramientas de búsqueda lo redujo a 1,300 tokens, 0.8%. El propio enfoque del paper lo plantea como un cuello de botella de ingeniería de contexto, no de retrieval.
- arXiv:2608.29016 (2026-08-29) — Towards Fully Automated Medical Imaging Code Generation via Validation-based Context Engineering. Contexto ensamblado a partir de bases de conocimiento de dominio, memoria compartida y retroalimentación de validación en vez de hacerlo a mano, en seis datasets y cinco modelos backbone. La tendencia: la construcción de contexto se está volviendo un componente con sus propias pruebas.
- Más antiguos pero fundamentales: arXiv:2005.11401 (RAG), arXiv:2307.03172 (Lost in the Middle), arXiv:2310.08560 (MemGPT), y el canon de practicantes de 2025 — los cuatro buckets de LangChain, Context Rot de Chroma,Context Rot, el post sobre tasa de caché de Manus, el post de ingeniería de Anthropic.
[OPEN]Qué no ha cambiado. Busqué una replicación en 2026 de las curvas de degradación de Chroma en modelos actuales de ventana larga y no encontré ninguna: la evidencia pública más fuerte de context rot sigue siendo un informe de proveedor de julio de 2025 y un paper de 2023, ninguno repetido de forma independiente en modelos de 2026. Considera el tamaño del efecto como no resuelto y la dirección como bien respaldada. Tampoco encontré ninguna medición pública controlada de la tasa de aciertos de la caché de prefijo entre proveedores — la brecha de 10× entre caché y no caché que todos citan proviene del precio de lista de un solo proveedor en un momento dado.
Prueba de salida
Haz el chequeo sin hacer scroll hacia arriba.
- ¿Cuál es la diferencia entre la despensa y la encimera, y cuál de las dos es la que realmente se amplía cuando aumentas la ventana de contexto?
- ¿Por qué un timestamp al inicio del system prompt cuesta más que el mismo timestamp al final, si ambos ocupan la misma cantidad de tokens?
- Nombra las dos métricas que refutan la idea de que "una ventana de un millón de tokens resuelve la recuperación", y explica qué mantuvo constante cada una.
- Un recuperador puede ser excelente, pero si la memoria no tiene campo de caducidad, la fuga nunca puede llegar a cero porque no hay forma de distinguir lo vigente de lo obsoleto.
- Si tu fuga de hechos caducados marca 0.000, la forma más barata de que ese número sea mentira es no poner casi nada en contexto. La única métrica que debes reportar junto a ella es cuántos hechos o elementos realmente incluiste.
Cliffhanger
Dejas la encimera impecable.
Cada campo volátil va al final; el prefijo tiene el mismo hash en cien peticiones. Cada fila lleva fecha de caducidad y un puntero de supersesión, y el ensamblador rechaza todo lo que no pueda fechar. Presupuesto declarado, desbordamiento bloqueado en cero. Tasa de aciertos de caché 0.978, fuga 0.000, y por una tarde crees que ya dominas la cocina.
Entonces llega un cliente. Tu agente lee el ticket, recupera exactamente la cláusula correcta de la política vigente y redacta una respuesta perfecta en cada detalle.
Y luego emite el reembolso.
Dos veces, porque la primera llamada expiró y nadie le dijo que un reembolso no es algo que se deba reintentar. Por un monto superior al límite del escritorio, porque nadie había escrito ese límite donde el agente pudiera leerlo. Y escribió al sistema de tickets y al de facturación en un orden que dejó a ambos en desacuerdo — y cuando pides el deshacer, no existe.
La encimera estaba limpia. Los datos eran frescos. Nadie había decidido qué podía tocar el cocinero.
Episodio 3 — La Cocina del Restaurante.Ingeniería de harness: el modelo ve los datos correctos y aun así no puede actuar — y la métrica mostró que un harness de primera pasada empeoró dos de cuatro celdas.
Lee también
Episodio 2 de Intelligence Engineering Adventures, Temporada 7 — La Escalera de la Cocina. Las afirmaciones en la fuente de la serie están etiquetadas por clase — definición, derivación, evidencia, decisión de ingeniería, pregunta abierta — y una metáfora puede ilustrar una idea pero nunca sirve como evidencia. Cada episodio incluye un notebook de Colab que corre en el nivel gratuito sin API key, más dos aplicaciones construidas desde cero — una personal, otra de tipo empresarial. La escalera es la de Feng et al. (arXiv:2608.21156), no la mía. La sección "qué cambió" se genera a partir de una sincronización semanal en vivo de 30 fuentes pioneras, clasificadas por señal técnica y nunca por alcance de audiencia. Este artículo no contiene material de ningún empleador ni cliente. — Paul Jialiang Wu · futuremake.io
Referencias
- Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., Liang, P. (2023). Lost in the Middle: How Language Models Use Long Contexts. arXiv:2307.03172 — resumen consultado el 2026-09-11; la frase sobre la posición se cita textualmente de ahí. Publicado como TACL 12 (2024); comparé ambos resúmenes y son idénticos, así que la cita aplica para cualquiera de las versiones.
- Ji, Y. ("Peak") (2025-07-18). Context Engineering for AI Agents: Lessons from Building Manus. manus.im/blog — leído completo el 2026-09-11; fuente de la cita sobre el KV-cache hit rate, la cita sobre el timestamp en el prefijo, la proporción 100:1 de entrada/salida y los precios de lista usados como modelo de costos en el laboratorio.
- Anthropic (2025-09-29). Effective context engineering for AI agents. anthropic.com/engineering — consultado el 2026-09-11; fuente de la cita sobre el recurso finito y del enfoque de presupuesto de atención descrito en la tabla histórica.
- Hong, K., Troynikov, A., Huber, J. (2025-07-14). Context Rot: How Increasing Input Tokens Impacts LLM Performance. Informe técnico de Chroma, research.trychroma.com/context-rot — consultado el 2026-09-11; 18 modelos, complejidad de tarea constante, longitud de entrada variable.
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. (2026). Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2, revisado 2026-08-26 — la escalera de la serie; "Context Engineering to manage information access" citado de la página del resumen. (Traducción: Ingeniería de contexto para gestionar el acceso a la información)
- Lewis, P., Perez, E., Piktus, A. et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv:2005.11401 (NeurIPS 2020) — el hito de 2020 en la tabla histórica; se leyó la página del resumen, no se cita textualmente.
- Packer, C., Wooders, S., Lin, K. et al. (2023). MemGPT: Towards LLMs as Operating Systems. arXiv:2310.08560 — gestión virtual del contexto; se leyó la página del resumen, no se cita textualmente.
- Willison, S. (2025-06-27). Context engineering. simonwillison.net — el artefacto que leí para ambos posts de junio de 2025. Originales: Tobi Lütke y Andrej Karpathy; ambos se renderizan del lado del cliente, así que las citas aquí provienen de la transcripción de Willison y se atribuyen en consecuencia.
- The LangChain Team (2025-07-02). Context Engineering. langchain.com/blog — la taxonomía escribir / seleccionar / comprimir / aislar; leído el 2026-09-11, descrito pero no citado textualmente.
- Barba, L. A. (2026-09-10). Reproducibility in the Age of Agentic AI: Context Engineering at the Timescale of a Codebase. arXiv:2609.11728 — «lo que cambió»; página del resumen consultada el 11-09-2026.
- Saha, O. et al. (2026-08-25). Hybrid Semantic Tool Discovery for Enterprise MCP Gateway: Architecture and Implementation. arXiv:2608.23992 — «lo que cambió»; las cifras de 140.2k → 1.3k tokens provienen de la página del resumen, consultada el 11-09-2026.
- Zhao, Z. et al. (2026-08-29). Towards Fully Automated Medical Imaging Code Generation via Validation-based Context Engineering. arXiv:2608.29016 — «lo que cambió»; página del resumen consultada el 11-09-2026.
- Dhage, S. (2026). Harness Engineering for Predictable Agentic Systems: An Empirical Study of Deterministic Execution Constraints. arXiv:2608.26197 — la medición del Episodio 1, referenciada aquí por la forma del plan gate y anticipada para el Episodio 3.
- Anthropic (2024-12-19). Building Effective AI Agents. anthropic.com/engineering — hito de harness engineering en la tabla de la serie.
- Laboratorio y proyectos de este episodio, cada celda ejecutada antes de la publicación: gist.github.com/wjlgatech/47eb7973aa5e292524c9c205c73c34d9 —
02_context_budget.ipynb,the-fridge-list,the-desk-memory. - Intelligence Engineering Adventures, Temporada 7, Episodio 1 — La ingeniería de prompts es una especificación, no un hechizo, para la tarjeta de recetas, la compuerta de planes y las métricas de determinismo sobre las que se construye este episodio.