AI-Native 연재 · 에이전트 엔지니어링 비교: 프롬프트 · 컨텍스트 · 하니스 · 루프 · 그래프
컨텍스트 엔지니어링: 더 큰 윈도우가 아니라 예산의 문제
2화 (총 6화 중)이 연재는 AI 에이전트를 만드는 다양한 엔지니어링 방식을 비교한다. 프롬프트, 컨텍스트, 하니스, 루프, 그래프 엔지니어링, 그리고 이번 시즌에서 새롭게 제안하는 여섯 번째 단계인 평가 엔지니어링까지 — 각 방식의 기원, 실제로 제어하는 대상, 주도하는 이들, 그리고 측정으로 검증된 원칙을 다룬다. 이번 편은 대중적으로 널리 알려진 네 가지 분류에서 빠진 컨텍스트 엔지니어링과, 더 큰 윈도우로는 절대 해결할 수 없는 두 가지 핵심 결정을 다룬다.
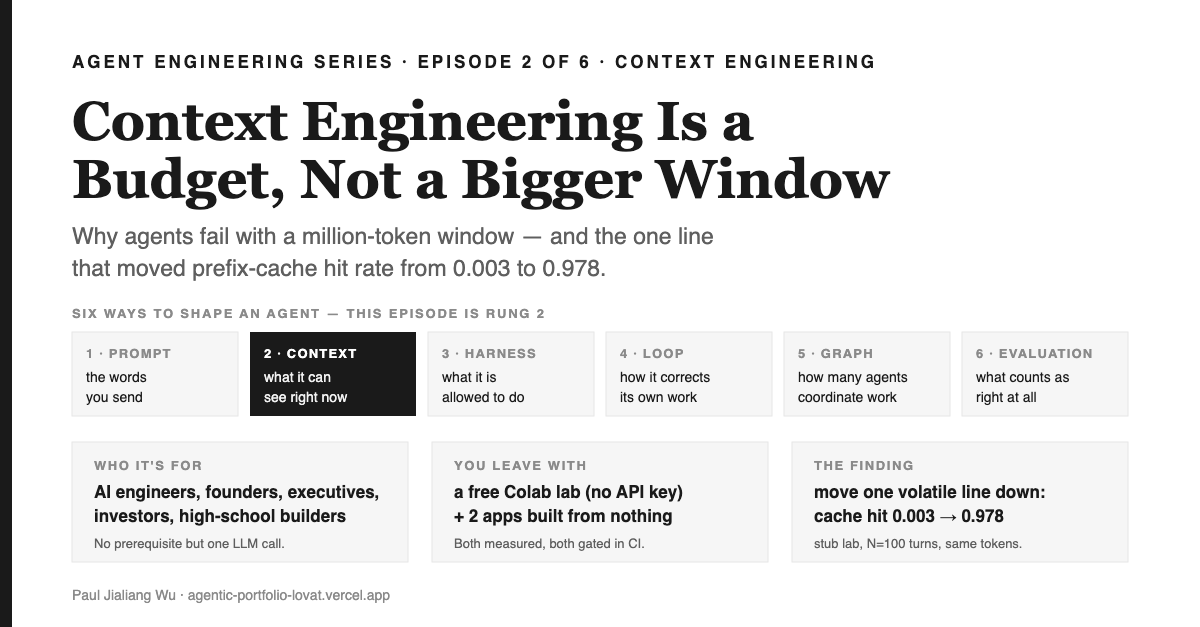
1분 요약 — 이 글에서 얻어갈 핵심
이 글의 성격AI 에이전트 엔지니어링의 다양한 방식을 비교하는 연재다. 프롬프트 엔지니어링(에이전트에 보내는 문장),컨텍스트 엔지니어링 (지금 이 순간 모델이 볼 수 있는 모든 정보), 하니스 엔지니어링(무엇을 할 수 있는지의 범위), 루프 엔지니어링(스스로 결과를 어떻게 바로잡는지), 그래프 엔지니어링(여러 에이전트가 어떻게 조율되는지), 그리고 평가 엔지니어링(무엇이 정답으로 인정되는지). 이번 편에서는 컨텍스트 엔지니어링을 집중적으로 다룬다. 2020년 인출 기반 생성부터 2026년까지의 흐름, 이 분야를 움직이는 주체들, 그리고 실제 측정에서 살아남은 원칙들을 짚는다.
왜 중요한가 매달 두 장의 청구서가 당신 앞으로 날아오고, 둘 다 컨텍스트 엔지니어링의 선택에 달려 있다. 첫째는 비용이다. 프로덕션 에이전트는 매 턴마다 전체 이력을 다시 보내기 때문에, 캐시된 프리픽스가 얼마나 살아남느냐가 추론 비용의 대부분을 결정한다. 둘째는 신뢰다. 은퇴한 정책에서 답을 내는 에이전트는 자신만만하게, 그리고 인용까지 가능하게 틀린 답을 내놓으며, 당신이 가진 모든 테스트를 통과한다. 이 둘은 윈도우를 아무리 키워도 해결되지 않는다. 2023년 Stanford 주도 연구는 정답이 윈도우 어디에 위치하느냐에 따라 정확도가 달라진다는 점을 밝혔고, 2025년 18개 모델을 대상으로 한 보고서는 입력이 길어질수록 단순한 작업조차 성능이 떨어진다는 결과를 냈다. 창업자에게는 데모가 몇 센트, 제품이 수천 달러로 벌어지는 차이고, 엔지니어라면 오늘 오후에 바로 배포할 수 있는 두 가지 수정 사항이다.
읽고 나서 바로 할 수 있는 일 컨텍스트에 토큰 예산을 설정하고, 프리픽스 캐시 적중률을 측정하며, 변동성이 있는 필드는 모두 프리픽스에서 빼고, 메모리 저장소의 모든 사실에 만료 스탬프를 붙여 인출 시 거를 수 있게 하라. Colab 무료 노트북(별도 API 키 불필요)과, 처음부터 직접 만든 두 개의 실전 앱이 제공된다: 만료된 재료 유출이 0.750에서 0.000으로 떨어지는 가족 식단 플래너, 그리고 예산 초과·만료 사실·불안정한 프리픽스가 감지되면 빌드를 막는 CI 게이트가 달린 지원 데스크 컨텍스트 조립기.
Season 7 — 시리즈 줄기
- 프롬프트 엔지니어링 — 주문이 아니라 명세다 1화
- 컨텍스트 엔지니어링 — 더 큰 윈도우가 아니라 예산 이번 화
- 하니스 엔지니어링 — 에이전트가 아니라 경계선 3화
- 루프 엔지니어링 — 재시도가 아니라 외부 심판 4화
- 그래프 엔지니어링 — 페르소나 출연진이 아닌 일정 5화
- 평가 엔지니어링 — 진리 함수이며, 리더보드는 그 결과일 뿐이다 6화
이번 편의 주제와, 컨텍스트 엔지니어링이 두 번째인 이유
AI 에이전트 개발에는 다섯 가지 이름 붙은 분야가 있고, 이번 시즌이 새롭게 제안하는 여섯 번째가 있다. 이들은 대략 다음 순서로 등장했다: 프롬프트 엔지니어링(2020), 루프 엔지니어링(2022), 그래프 엔지니어링(2023), 하니스 엔지니어링(2024), 컨텍스트 엔지니어링(2025) — 평가 엔지니어링은 실천으로는 오래됐지만, 이름으로는 최근에 붙었다. 이 분야들을 가장 명확하게 정리한 것은 Feng 외의 서베이(arXiv:2608.21156)다. 이 논문은 각 분야를 등장 시기가 아니라, 무엇을 제어할 수 있게 해주는지에 따라 프롬프트 → 컨텍스트 → 하니스 → 루프 → 그래프 순으로 배열한다. 이 시리즈는 그 순서대로 각 분야를 한 편씩 다루며, 매번 네 가지 질문을 던진다 — 어디서 비롯됐는가, 정확히 무엇을 통제하는가, 누가 주도하는가, 그리고 어떤 실패가 다음 단계로 밀어올리는가.
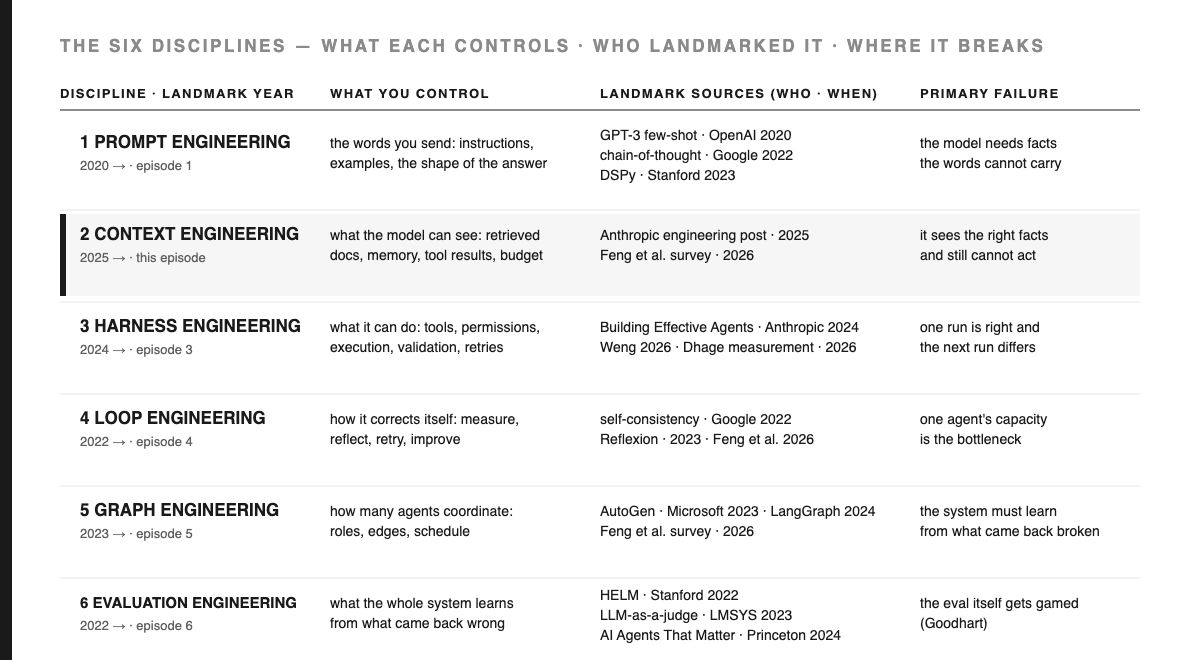
컨텍스트 엔지니어링이 두 번째 단계에 놓이는 이유는, 1단계에서 다 써버리는 자원이 바로 이것이기 때문이다. 에피소드 1의 마지막에서는 완벽한 레시피 카드로 두 가지 서로 다른 요리가 나왔고, 그 원인은 카드에 적혀 있지 않았다. 에이전트가 당신이 보낸 말에 없는 정보—정책, 가격, 어제의 결정, 마지막 도구 결과—를 필요로 하는 순간, 당신은 더 이상 프롬프트만 다루는 사람이 아니다. 이제는 한정된 자원을 어디에 쓸지 선택하는 입장에 선다.
이 글의 독자데모에서는 정답을 내지만 3주 차에는 비싸지거나 틀리는 에이전트형 AI 엔지니어, 사용량보다 더 빠르게 늘어난 추론 요금 청구서를 바라보는 창업자, "프롬프트에 그냥 더 붙여넣으면 되지"가 왜 더는 통하지 않는지 궁금한 고등학생 제작자. 필요한 것은 단 하나, 언어 모델을 한 번이라도 호출해 본 경험뿐이다.
컨텍스트 엔지니어링의 기원과 현재 주도 세력
[정의]컨텍스트란 모델이 답을 내릴 때 볼 수 있는 모든 정보—시스템 프롬프트, 도구 정의, 지금까지의 대화, 검색 결과, 도구가 반환한 값 등—를 뜻한다. 컨텍스트 엔지니어링은 그 안에 무엇을 넣고 무엇을 뺄지 결정하는 일이다. 이것이 전부다. 역사는 검색 기반 기법이 예산 개념으로 진화한 과정이다.
| 시점 | 주요 사건 | 주도자 | 무엇이 바뀌었나 |
|---|---|---|---|
| 2020-05 | Retrieval-Augmented Generation (arXiv:2005.11401) | Lewis et al., Facebook AI Research, UCL, NYU | 사실이 모델의 가중치에서 입력으로 옮겨진다. 모델은 생성 시점에 인덱스에서 정보를 읽어오고, 모델이 "아는 것"은 직접 조립하는 대상이 된다. |
| 2023-07 | Lost in the Middle (arXiv:2307.03172) | Liu et al., Stanford, Berkeley, Samaya AI | 윈도우를 실제로 측정해보니 균일하지 않다는 사실이 드러난다. 정답이 어디에 위치하느냐에 따라 정확도가 달라진다. 위치가 엔지니어링의 핵심 변수가 된다. |
| 2023-10 | MemGPT (arXiv:2310.08560) | Packer et al., UC Berkeley | 운영체제의 가상 메모리 개념을 차용해, 작은 윈도우에 사실을 페이지 인/아웃한다. 윈도우는 파일 캐비닛이 아니라 RAM처럼 다뤄진다. |
| 2025-06 | 용어가 명확히 붙고 확산됨 (simonwillison.net) | Tobi Lütke, Shopify; Andrej Karpathy | '프롬프트 엔지니어링'이 어느새 챗봇에 글을 입력하는 행위로만 인식되던 시절, 두 편의 글이 이 실천에 새로운 이름을 붙였고, 그 이름이 굳어졌다. |
| 2025-07-02 | 컨텍스트 엔지니어링 (langchain.com/blog) | LangChain 팀 | 실무자가 직접 손댈 수 있는 네 가지 범주—작성, 선택, 압축, 분리—를 제시한다. 실제 구현이 뒷받침된 최초의 분류법이다. |
| 2025-07-14 | 컨텍스트 로트 (research.trychroma.com) | Hong, Troynikov, Huber, Chroma | 18개 모델을 대상으로, 과업 난이도는 일부러 단순하게 고정하고 입력 길이만 바꿨다. '이제 백만 토큰 윈도우가 가능하다'는 마케팅이 실제 통제 실험과 맞붙는다. |
| 2025-07-18 | Manus 구축에서 얻은 교훈 (manus.im/blog) | Yichao "Peak" Ji, Manus | 프로덕션 관점에서 보면, KV-캐시 적중률이 비용을 좌우하는 핵심 지표이고, 프리픽스의 안정성이 그 적중률을 지키는 방패다. |
| 2025-09-29 | AI 에이전트의 효과적인 컨텍스트 엔지니어링 (anthropic.com/engineering) | Anthropic | 모델 연구소가 예산이라는 관점을 명확히 내세운다. 컨텍스트는 유한한 자원이자 주의 예산이며, 목표는 신호가 가장 높은 최소 집합을 만드는 것이다. |
| 2026-08 | 사다리형 서베이(arXiv:2608.21156v2) | Feng 외 | 컨텍스트 엔지니어링은 패러다임 사다리의 두 번째 단에 위치하며, 정보 접근을 관리하는 것으로 정의된다. |
[설계]세 가지를 눈여겨볼 만하다. 실천은 이름보다 다섯 해 먼저 시작됐다. 2020년의 RAG도 이미 컨텍스트 엔지니어링이었지만, 그저 자기 이름을 몰랐을 뿐이다. 2025년에 이 용어를 붙인 두 글은 논문이 아니라 각각 CEO와 전 연구소장이 소셜 미디어에 올린 글이었고, 기존 용어가 남용으로 망가진 덕분에 새 이름이 자리를 잡았다. 그리고 여기서 가장 날카로운 결과는마케팅을 정면으로 반박하는 실측 결과같은 해에 벤더들이 백만 토큰 윈도우를 자랑했지만, 두 개의 독립 연구팀이 더 긴 윈도우가 항상 고르게 쓸 수 있는 자원이 아님을 실험으로 보여줬다.
지금 이 분야를 움직이는 주체모델 연구소가 가이드라인을 만들고, 여러분이 최적화해야 할 캐싱 동작의 기준을 쥐고 있다. 에이전트 제품팀—가장 대표적인 공개 사례는 Manus—은 실제 운영 지표를 공개한다. 이들은 대규모로 비용을 직접 부담하기 때문이다. 프레임워크 벤더는 이런 실천법을 기본값으로 녹여낸다. 검색 인프라 기업들은 경쟁적 측정 실험에 투자한다. 이는 건강한 구조다. 검색을 파는 쪽이 윈도우만 채우는 것이 대체가 될 수 없음을 가장 강하게 입증할 동기를 갖고 있기 때문이다. 학계는 두 개의 핵심 측정 중 하나를 제공한다(Liu 등, Stanford와 Berkeley), 나머지는 산업계 몫이다. 이게 바로 이 단계의 현실적 풍경이다.
이 시리즈를 관통하는 사고틀: 주방 사다리
여섯 편 전체를 하나로 꿰는 그림이 있다. 이번엔 이야기 대신 도구로 다시 꺼내 든다. 모든 요리사는 같은 사다리를 오른다. 처음엔 자기 자신을 위해, 그다음 가족, 식당 주방, 패스트푸드 체인, 그리고 여러 체인을 먹여 살리는 국가 공급망까지—그 위에 리콜 로그가 있다. AI 엔지니어도 마찬가지다. 학생에서 최전선 리더까지, 에이전트 엔지니어링의 각 단계는 이 사다리의 한 주방에 대응한다.
1화는 레시피 카드였다. 내가 카드를 쓰고, 말을 섞을 수 없는 요리사가 그걸로 음식을 만든다. 모든 정보는 미리 카드에 담겨 있어야 한다.두 번째 단계는 팬트리와 조리대다.이제 당신은 가족을 위해, 일주일에 여러 번, 점점 쌓여가는 주방에서 요리한다. 레시피 카드도 여전히 중요하다. 하지만 화요일과 금요일 사이에 팬트리가 채워지고, 조리대—실제로 요리가 이루어지는 작은 평평한 공간—에서 모든 요리의 성패가 갈린다.
| 단계 | 주방 | 당신의 역할 | 어떤 부분을 주도적으로 바꿀 수 있는가 |
|---|---|---|---|
| 1. 프롬프트 | 레시피 카드 — 자기 자신을 위한 요리 | 학생 | 요리사가 참고하는 글로 된 지침 |
| 2. 컨텍스트 | 팬트리와 조리대 — 가족을 위한 요리 | 주니어 개발자 | 조리대에 나와 있는 것과 그 신선도, 그리고 실제 작업 중에 그것이 어떻게 변하는지 |
| 3. 하니스 | 레스토랑 주방 | 시니어 개발자 | 각 스테이션, 손이 닿는 도구들, 모든 접시가 검사되는 패스 |
| 4. 루프 | 패스트푸드 체인 | AI 테크 리드 | 맛을 보고, 측정하고, 고치고, 그 결과를 모든 매장에 적용한다 |
| 5. 그래프 | 전국 공급망 | CTO | 여러 주방, 하나의 일정표, 하나의 트럭 운송망 |
| 6. 평가 | 리콜 기록 | 프론티어 리더 | 전체 식품 시스템이 반품에서 배우는 것 |
팬트리는 내가 가진 모든 식재료—선반, 냉동고, 냉장고 구석까지 포함한다. 카운터는 지금 당장 꺼내놓은 것, 요리할 때 손이 닿는 곳에 있는 재료다. 이 둘은 전혀 다른 대상이며, 이 차이를 혼동하는 것이 이번 편의 핵심이다. 병을 많이 모은다고 저녁이 나아지지 않는다. 저녁 메뉴를 결정하는 건 카운터에 올라온 재료—그리고 그 중 상한 것이 있는지 여부다.
축은 하나가 아니라 둘이다.이건 한 번 오르고 끝나는 사다리가 아니다. 모든 주방에는 여섯 개의 층이 동시에 존재한다. 집밥 요리사도 레시피 카드, 팬트리, 스토브, 맛보기, 공급자, 그리고 지난번 실패의 기억까지 모두 갖고 있다. 올라갈수록 내가 만질 수 있는 층이 늘고, 각 층을 얼마나 엄격하게 운영하는지가 달라진다. 처음엔 감으로, 그다음엔 측정하고, 게이트를 두고, 자기 교정까지 간다. 전국 체인이라도 공급망 다이어그램만 그려놓고 유통기한 정책이 없다면, 모든 병에 날짜를 붙이는 한 가족 주방보다 미성숙하다. 즉, 각 분야는 내가 통제하는 층이고, 시니어리티는 그 층을 얼마나 성숙하게 운영하는가이며, "그래프"가 "루프"보다 무조건 더 고급인 것은 아니다.
이 비유는 주장을 소개할 수 있지만, 그 자체로 증거가 될 수는 없다. 아래 1:1 기술 맵에서 모든 요소는 코드의 한 지점에 정확히 대응된다. 그리고 1화 마지막에 등장했던 그 물건이 여전히 여기 있다.소금 옆에 누군가 열어둔 채로 둔 병.계속 지켜보라. 약 900단어 뒤에 진짜 돈이 새어나갈 것이다.
이 사다리는 내 것이 아니다
[정의]용어는 출처에 정확히 연결되어 있다. 이 영역을 두고 여러 라벨이 경쟁하고, 대부분의 리스트 글은 이 구성을 잘못 짚는다.
이 사다리에 대한 가장 명확한 공식 출처는 Feng 외(arXiv:2608.21156, 2026-08-26 개정)의 서베이이다. 이들은 이 단계를 여섯 단어로 정의한다:"Context Engineering to manage information access"(번역: 정보 접근을 관리하는 컨텍스트 엔지니어링) — 이 단계는 프롬프트 엔지니어링(모델이 이미 할 수 있는 능력을 이끌어내는 것)과 하니스 엔지니어링(모델이 도달할 수 있는 범위를 조직하는 것) 사이에 놓인다.
실무자들의 정의가 먼저 나왔다. Shopify의 Tobi Lütke는 2025년 6월, 이를 이렇게 불렀다 "the art of providing all the context for the task to be plausibly solvable by the LLM"(번역: LLM이 문제를 그럴듯하게 풀 수 있도록 모든 컨텍스트를 제공하는 기술); 며칠 뒤 Andrej Karpathy가 이렇게 덧붙였다 "the delicate art and science of filling the context window with just the right information for the next step"(번역: 다음 단계를 위해 컨텍스트 윈도우에 꼭 필요한 정보만을 채워 넣는 섬세한 기술이자 과학). 두 인용 모두 2025년 6월 27일자 Simon Willison의 노트에서 따온 것으로, 내가 직접 읽은 기록이다.
[DESIGN] 세 정의가 공통적으로 강조하는 점과, 대중적 사용에서 사라진 부분을 보자. Lütke는 '모든 컨텍스트'를, Karpathy는 '딱 맞는 정보'를, Feng 등은 '접근 관리'를 말한다. 누구도 '더 많이'라고 하지 않는다. 이 분야는 원래 무엇을 넣을지 선별하는 문제로 명명됐지만, 실제로는 무엇이든 쌓아두는 문제로 오해되어 실무에서 다뤄진다. 이 둘의 차이가 바로 대부분의 에이전트 비용이 발생하는 원인이다.
주장의 분류
[DEF] 컨텍스트는 그릇이 아니라 예산이다. 예산에는 그릇과 다른 세 가지 특징이 있다. 한정되어 있고, 소진되며, 어디에 쓸지는 매번 네가 직접 선택한다. 그리고 이 예산에는 배치라는 개념이 있다 — 이 예산에서는 토큰이 어디에 놓이느냐에 따라 비용과 읽히는 정도가 달라진다.
[EVIDENCE] 먼저 위치부터 살펴보자. 이 부분이 가장 오래되고, 가장 많이 측정된 근거다. Liu 등은 동일한 정보를 윈도우 내 여러 위치에 배치해 정확도를 측정했다:
"performance is often highest when relevant information occurs at the beginning or end of the input context, and significantly degrades when models must access relevant information in the middle of long contexts, even for explicitly long-context models"(번역: 관련 정보가 입력 컨텍스트의 처음이나 끝에 있을 때 성능이 가장 높고, 긴 컨텍스트의 중간에 있을 때는 — 명시적으로 긴 컨텍스트 모델에서도 — 성능이 크게 저하된다)
— Liu 등, Lost in the Middle, arXiv:2307.03172
마지막 문장이 핵심이다: even for explicitly long-context models. 윈도우를 늘린다고 이 문제가 해결되지 않는다. 이건 윈도우의 크기가 아니라, 그 안에서 주의(attention)가 어떻게 분포되는지에 관한 이야기다. (이 논문은 2024년 TACL에 실렸고, arXiv 초록과 게재본 초록을 비교해 보니 단어 하나까지 완전히 일치했다.)
[EVIDENCE] Chroma의 2025년 기술 보고서는 반대편에서 같은 문제를 파고든다. Lost in the Middle이 위치를 바꿨다면, Chroma는 길이를 바꾸고 난이도는 일정하게 유지했다:Lost in the Middle에서는 정보의 위치를 바꿔 실험했고, Chroma는 입력 길이만 늘리고 난이도는 일정하게 맞췄다."Each task remains intentionally simple and is deliberately controlled to isolate the impact of context length alone."(번역: "각 작업은 의도적으로 단순하게 유지되며, 오직 컨텍스트 길이의 영향만을 분리해 측정할 수 있도록 신중하게 통제된다.") 18개 모델을 대상으로 한 결론은 명확하다."models do not use their context uniformly; instead, their performance grows increasingly unreliable as input length grows."(번역: "모델들은 컨텍스트를 고르게 활용하지 않으며, 입력 길이가 길어질수록 성능이 점점 더 불안정해진다.") Anthropic은 자사 엔지니어링 블로그에서 이 용어를 받아들였고, 바로 이 에피소드의 제목이 된 결론을 내렸다."Context is a critical but finite resource for AI agents."(번역: "컨텍스트는 AI 에이전트에게 필수적이지만 유한한 자원이다.")
[EVIDENCE]이번에는 돈 얘기다. 상대적으로 관심을 덜 받지만, 매달 실제로 청구서에 찍히는 부분이다. 에이전트 루프는 매 턴마다 전체 히스토리를 다시 보낸다. 그래서 입력 대비 출력 비율은 챗봇과는 전혀 다르다. Manus는 이 비율이 약 100:1이라고 밝힌다. 결국 한 가지 수치가 비용을 좌우하게 된다.
"If I had to choose just one metric, I'd argue that the KV-cache hit rate is the single most important metric for a production-stage AI agent."(번역: "단 하나의 지표만 고르라면, KV-캐시 히트율이 프로덕션 단계 AI 에이전트에서 가장 중요한 지표라고 생각한다.")
— Yichao "Peak" Ji, Manus, 2025-07-18
그리고 이 지표를 망치는 원인은 너무 사소해서 그냥 사소한 습관처럼 보일 정도다."A common mistake is including a timestamp—especially one precise to the second—at the beginning of the system prompt."(번역: "흔한 실수는 시스템 프롬프트 맨 앞에 타임스탬프—특히 초 단위까지 정확한 것—를 포함하는 것이다.") 여기서 말하는 캐시는 프리픽스 캐시다.이 캐시는 요청이 이전 요청과 앞부분에서 얼마나 많은 토큰을 공유하는지에 따라, 그 구간만큼을 재사용한다. 12번째 토큰 하나만 달라져도, 그 이후 모든 토큰은 매 턴마다 다시 프리필된다. 이 현상은 끝없이 반복된다.
[DERIVATION]이 세 가지를 합치면 결론은 '컨텍스트를 작게 유지하라'가 아니다. 더 본질적인 두 가지 원칙이 나온다.
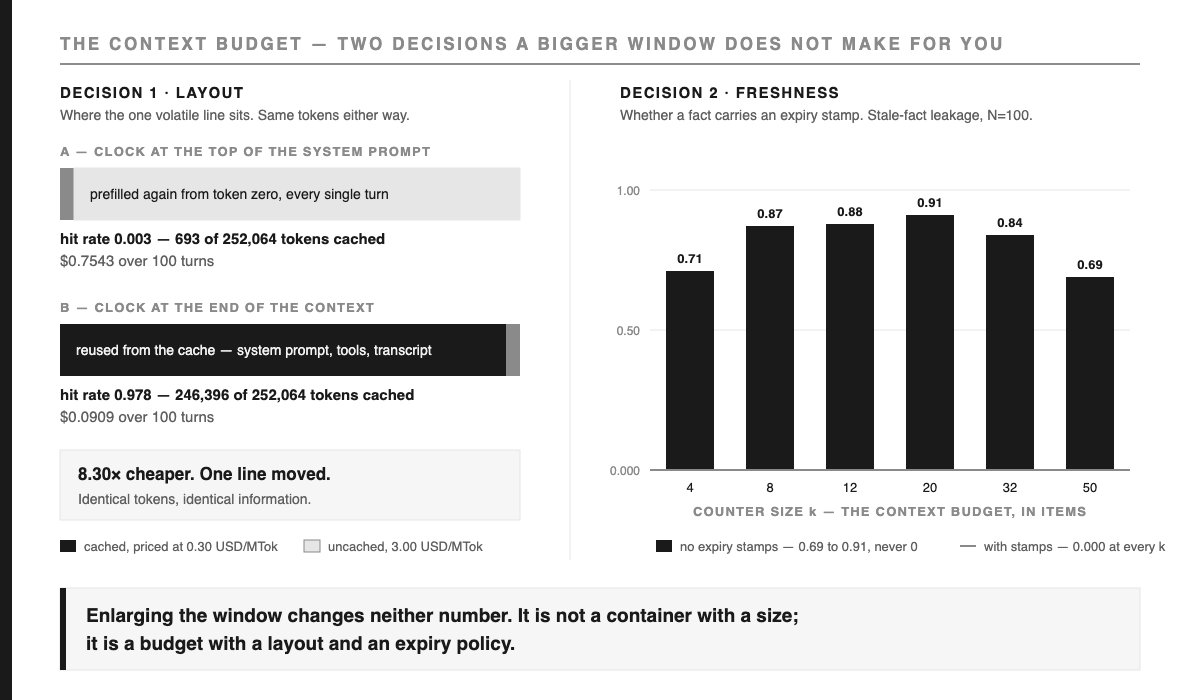
- 레이아웃은 곧 비용이다.매 턴마다 바뀌는 정보는 프리픽스가 아니라 컨텍스트의 끝에 둬야 한다. 위치는 단순한 보기 좋음이 아니라, 실제로 비용이 매겨진다.
- 신선도는 곧 정답의 조건이다.날짜를 붙일 수 없는 사실은 걸러낼 수 없다. 메모리 저장소에 만료나 대체 필드가 없다면, 아무리 리트리버가 좋아도 은퇴한 정책이 인용되는 걸 막을 수 없다. 왜냐하면 오래됨(staleness)은 리트리버가 볼 수 있는 속성이 아니기 때문이다.
[DESIGN]벤더의 주장은 무시할 게 아니라, 제대로 들어볼 필요가 있다. 롱 컨텍스트 지원 발표는 사실이고, 단발성 작업—계약서 읽기, 질문 답변 등—에서는 100만 토큰이 2023년에는 없던 진짜 능력이다. 하지만 여기서 모두가 쉽게 내리는 결론, 즉 이제 큐레이션이 선택 사항이라는 추론은 성립하지 않는다. Chroma는 바로 그 가정을 통제된 조건에서 실험했고, 단순한 작업에서도 거짓임을 확인했다. 그리고 비용은 어느 쪽이든 변하지 않는다. 더 큰 윈도우가 큐레이션 없는 컨텍스트를 1원도 싸게 만들지 않는다.
[OPEN] 두 가지 분명한 한계가 있다. 두 측정 모두 인출(검색) 유형의 작업에 관한 것이며, 어느 쪽도 큐레이션이 단순 누적보다 항상 추론 중심 작업에서 낫다는 점을 입증하지는 않는다. 또한 캐시 비용 구조는 제공자마다 다르다. Manus가 특정 모델 패밀리에서 인용한 캐시와 비캐시 입력 간 10배 차이는 특정 시점의 정가일 뿐, 자연법칙이 아니다. 내 산식을 인용하기 전에 반드시 본인 제공자 기준으로 다시 계산하라.
1:1 기술 대응표
비유의 각 요소는 코드에서 정확히 하나의 대상에 매핑된다. 비유는 주장을 소개할 수 있지만, 결코 증거가 될 수는 없다. 그래서 여기서는 장식 없이 대응만 남긴다.
| 주방 | 시스템 | 실제로 존재하는 위치 |
|---|---|---|
| 팬트리 — 내가 소유한 모든 것 | 코퍼스와 메모리 저장소 | 인덱스, 파일, 티켓 이력 |
| 조리대 — 지금 조리 중에 꺼내놓은 것 | 이번 턴에 조립된 컨텍스트 | messages[] 실제로 전송된 상태 |
| 조리대의 길이 | 컨텍스트 예산 | MAX_CONTEXT_TOKENS, 내가 정하는 숫자 |
| 팬트리에서 무엇을 꺼낼지 결정 | 인출, 필터링, 패킹 | score → filter → pack, 이 순서로 |
| 병의 유통기한 | 만료 또는 대체(슈퍼세션) 스탬프 | expires, superseded_by |
| 누군가 소금 옆에 열어둔 병 | 아직 컨텍스트에 남아 있는 만료된 사실 | 모델이 인용할 은퇴한 정책 조항 |
| 항상 자리를 지키는 미장플라스 | 고정된 프리픽스 | 시스템 프롬프트와 도구 스키마, 바이트 단위까지 동일함 |
| 조리대 위에 박아둔 시계 | 프리픽스 안에 들어 있는 변동 필드 | 초 단위까지 기록된 타임스탬프 |
| 끝내 손이 닿지 않는 선반 | 긴 윈도우의 한가운데 | 영역 Lost in the Middle 에서 측정한 구간 |
| 코스가 바뀔 때마다 조리대 비우기 | 복구 가능한 압축 | 본문은 버리고 URL만 남기기 |
| 티켓에 적어 클립으로 걸어두기 | 외부화된 메모리 | 에이전트가 직접 쓰고 다시 읽는 파일 |
[정의]이 에피소드에서 계속 다루게 될 세 가지 핵심 수치, 여기서 한 번만 정의한다.
- 프리픽스 캐시 적중률— 여러 번 실행했을 때, 입력 토큰 중 캐시에서 불러온 비율(미리 채워진 부분 제외). 품질과는 무관하다. 오직: 이미 비용을 지불한 입력이 얼마나 되는가.
- 만료 사실 유출률— N개의 답변 중, 이미 만료되었거나 대체된 사실을 하나라도 사용한 비율. 답변이 아무리 자연스럽고 유창해도, 은퇴한 조항을 인용할 수 있다.
- 예산 초과 — N번 조립 중 선언한 토큰 예산을 넘긴 횟수다. "저하"가 아니다. 예산을 초과한 컨텍스트는 당신이 아닌, 제공자가 원하는 쪽 끝에서 잘라낸다.
예측 게이트
아래로 내리기 전에, 답을 꼭 적어두라. 기록하지 않은 예측은 나중에 스스로 맞았다고 착각하게 된다. 이 장치의 목적이 바로 그것이다.
Q1. 에이전트가 100번 동작한다. 시스템 프롬프트 맨 앞에 초 단위까지의 현재 시각이 들어간다. 나머지는 모두 추가만 된다. 입력 토큰 중 몇 퍼센트가 프리픽스 캐시에서 제공될까?
Q2. 그 한 줄을 시스템 프롬프트 맨 앞에서 모델이 답을 내기 직전 마지막 줄로 옮긴다. 토큰 수도, 정보도 같다. 히트율과 비용은 어떻게 달라질까?
Q3. 메모리 저장소에 만료 필드가 없고, 약 4분의 1이 이미 오래된 데이터다. 답변에서 만료된 사실이 사용되는 빈도를 줄이고 싶다. 효과가 큰 순서대로 나열하라: (a) 컨텍스트 예산을 두 배로 늘린다, (b) 리트리버의 랭킹을 개선한다, (c) 만료 필드를 추가하고 스코어링 전에 필터링한다.
정답은 Failure Room과 Notebook에 있다. Q3에서 (b)를 골랐다면, 당신은 흔한 오해에 빠진 것이고, 셀 6의 실험 결과가 15분 투자할 가치가 있다.
Failure Room
일부러 망가뜨려 보라. 망가뜨릴 수 없는 메커니즘은 주장일 뿐, 진짜 메커니즘이 아니다.
Failure 1 — "이제 윈도우가 백만 토큰이니, 다 해결됐다." 이 계단에서 가장 흔히 믿는 이야기이자, 가장 많은 반례가 출판된 주장이다. Chroma는 난이도를 고정하고 입력 길이만 18개 모델에서 바꿨지만 성능은 여전히 떨어졌다. Liu 등은 길이를 고정하고 위치만 바꿨는데, 정확도는 여전히 변했다. 명시적으로 롱컨텍스트 모델도 포함해서다. 카운터가 커지는 건 실제로 쓸모 있지만, 두 결과 모두 바뀌지 않는다. 그리고 이번 에피소드가 측정하는 두 숫자에도 아무 영향이 없다.
Failure 2 — "캐싱만 켜면 문제없다." 캐싱은 단순 체크박스가 아니라 프리픽스의 속성이다. 그리고 좋은 엔지니어링처럼 보이는 사소한 변화에도 쉽게 깨진다. 모델이 시간을 알도록 타임스탬프를 넣는다. 추적용 세션 id. 페르소나가 바뀌도록 "user tier: pro" 한 줄. JSON 직렬화기가 키 순서를 보장하지 않아 툴 리스트가 매번 다른 순서로 재조립된다. 각각이 맨 앞의 한 토큰이고, 각각이 그 뒤 모든 토큰에 비용을 부과한다. 아래 실험에서는 이 실수 하나로 히트율이 0.003까지 떨어진다. 에러도, 경고도, 잡아낼 대시보드도 없다. 그 대시보드는 아무도 만들지 않았다.
Failure 3 — "retrieve better." 이 함정에 많은 이가 빠진다. 더 나은 랭킹은 어떤 오래된 항목이 먼저 오는지만 바꾼다. 오래된 항목이 오는 걸 막지는 못한다. 날짜를 볼 수 없는 랭커에게는 신선도 자체가 보이지 않기 때문이다. 실험에서 만료 스탬프 없이 누출률은 카운터 크기 4~50에서 0.690~0.910 사이를 오가며, 단 한 번도 0에 도달하지 않는다. 스탬프가 있으면 항상 0.000이다. 이건 더 나은 리트리버가 아니다. 리트리버가 돌기 전에 묻는 완전히 다른 질문이다.
Failure 4 — 0.000을 찍는다고 의미 있는 메트릭이 아니다. 컨텍스트에 거의 아무것도 넣지 않으면 누출률을 0으로 만들 수 있다. 축하한다. 당신의 에이전트는 신뢰할 수 없을 만큼 무지하다. 에피소드 1의 결정성 메트릭이 빈 오브젝트에서 1.000을 찍는 것과 똑같은 모양이고, 그래서 fridge-list 프로젝트가 누출률 옆에 실제로 플랜이 언급한 재료 개수를 같이 보고한다. 유용성 없는 큐레이션 메트릭은 부정행위의 초대장이다.
Q3 정답: (c), 그다음 (b), 마지막이 (a) — 그리고 (a)는 단순히 꼴찌가 아니라, 오히려 방향 자체가 잘못됐다. 예산을 k=4에서 k=20으로 올리면 카운터에 올라온 만료 항목의 평균 개수가 1.08에서 9.25로 뛴다. 단 한 번만 두 배로 늘려도, k=4에서 k=8로 가면 1.08에서 2.90으로 오른다. 문제를 희석한 게 아니다. 더 많이 불러들인 것이다.
Notebook
Lab 02 — 프리픽스 안정성과 예산 
labs/02_context_budget.ipynb · Colab 무료 티어 · API 키 필요 없음 · 약 2초의 CPU · 모든 셀은 출판 전에 실행됨 · 핵심 요약 두 프로젝트 모두 여기에 담겨 있다.
총 7개의 셀로 구성되어 있고, 두 부분으로 나뉜다. 첫 번째는 스텁 토크나이저(4자당 1토큰)와 실제로 중요한 단 하나의 캐시 모델이다. 여기서 KV 캐시는 이번 요청과 직전 요청의 최장 공통 프리픽스를 재사용한다. 두 번째는 팬트리 파일, 어셈블러, 그리고 누출률 측정기가 담당한다.
- 토크나이저와 프리픽스 캐시 모델은 공개된 리스트 가격을 비용 모델로 삼는다.
- 에이전트의 컨텍스트는 두 가지 방식으로 조립한다. 하나는 시스템 프롬프트 맨 위에 시계를 두는 것이고, 다른 하나는 답변 직전 마지막 줄에 같은 시계를 두는 방식이다.
- N=100턴에 걸친 측정 결과다. 토큰 열을 먼저 보면 된다. 두 방식 모두 토큰 수는 완전히 동일하다.
- 팬트리에는 40개의 항목이 있고, 그 중 11개는 이미 만료된 상태다. 각 항목에는
added날짜와 선택적으로expires날짜가 붙는다. - 어셈블러와 누출률 측정기는 카운터 크기 12에서 동작한다.
- 스윕 그리고 반드시 챙겨가야 할 셀. 카운터 크기를 바꿔가며 두 가지 개입이 어떻게 갈라지는지 직접 확인해보라.
- 브리지: 함수 두 개만 교체하면, 동일한 측정 코드가 실제 엔드포인트에서도 그대로 작동한다.
[EVIDENCE] 셀 3, 실행 결과 그대로:
arrangement                        input tok    cached  hit rate   cost USD
volatile field at the TOP            252,064       693     0.003     0.7543
volatile field at the END            252,064   246,396     0.978     0.0909

cost ratio (top / end)          : 8.30x
cost delta over 100 turns       : $0.6634
토큰도 같고, 모델이 답할 때 볼 수 있는 정보도 같다. 단 한 줄만 앞에서 뒤로 옮겼을 뿐인데 입력 비용의 8.30배가 사라진다. 주목할 점은 아무런 에러도, 경고도, 출력 저하도 없다는 것이다. 비싼 버전 역시 완벽하게 동작한다. 그래서 코드 리뷰를 무사히 통과한다.
[EVIDENCE] 셀 6은 내가 아웃라인을 쓰던 중 생각을 바꾸게 만든 셀이다. 평가는 미리 단정하지 않고 런타임에 계산하도록 했는데, 실제로 내 예상을 뒤집는 결과가 나와서 한때 지울까 고민했다.
| 카운터 크기 k | 누출률: 스탬프 없음 | 누출률: 스탬프 있음 | 카운터 위 만료 항목 평균 개수 |
|---|---|---|---|
| 4 | 0.710 | 0.000 | 1.08 |
| 8 | 0.870 | 0.000 | 2.90 |
| 12 | 0.880 | 0.000 | 4.98 |
| 20 | 0.910 | 0.000 | 9.25 |
| 32 | 0.840 | 0.000 | 11.00 |
| 50 | 0.690 | 0.000 | 11.00 |
[OPEN]그 표를 곱씹어 보면, 내 주장에 반하는 부분까지 포함해서 읽어야 한다. 스탬프가 없을 때 누수율은 k값에 따라 단조롭게 움직이지 않는다. k=20에서 0.910까지 올랐다가, k=50에서는 0.690으로 다시 내려간다. 처음엔 마지막 두 행을 잘라낼까 했지만, 그랬다면 내 논지에 유리하게 표를 손질하는 셈이었다. 이유는 이렇다. 팬트리에는 40개의 항목이 있고, 그 중 11개가 이미 만료됐다. 그래서 k=32가 되면 만료된 항목이 모두 카운터에 올라온다. 네 번째 열이 11.00에서 고정된다. 이후 k를 더 늘려도 신선한 항목만 추가될 뿐, 스텁 요리사는 여전히 네 개만 고정해서 집는다. 답변당 누수율은 희석되지만, 카운터는 이미 완전히 오염된 상태다. 이건 스텁의 구조적 한계에서 비롯된 현상이고, 실제 리포트 오류의 전형적인 모습이기도 하다. 즉, 비율은 개선된 것처럼 보이지만, 실제 상태는 더 나빠질 수 있다. 여기서 살아남는 주장은 표 전체가 뒷받침하는 바로 그것이다. 스탬프가 없으면 예산을 아무리 늘려도 누수율이 0이 되지 않는다. 스탬프가 있으면 언제나 0.000이다.
[설계]왜 스텁을 쓰는가. 시뮬레이터는 비용이 어디서 발생하고 어디서 사라지는지 2초 만에, 무료로, 별도 키 없이 재현해준다. 규모 자체는 재현하지 않는다. 노트북이 출력하는 수치는 Liu et al.의 위치 효과나 Chroma의 성능 저하 곡선에 대한 증거가 아니다. 그런 주장은 반드시 해당 논문만 인용해야 한다. 8.30배라는 수치는 스텁 토큰에 공개 단가를 곱한 산술 결과다. 비율이 핵심이고, 달러 표기는 예시일 뿐이다. 7번 셀은 정직한 다리 역할을 한다. 토크나이저와 스텁 요리사만 바꿔도 측정 코드는 그대로 쓸 수 있다.
프로젝트
두 가지 빌드, 정말 아무것도 없는 상태에서 시작했다. 프레임워크도 없고, 표준 라이브러리 외에는 의존성도 없다. 두 빌드는 이 섹션을 쓰기 전에 직접 실행해 봤으니, 아래 모든 수치는 예측이 아니라 실측값이다.
프로젝트 1 — 실전 사례:the-fridge-list
projects/02-real-fridge-list/ · python3 fridge_list.py 100
가족 식사 플래너. 전체 컨텍스트가 단 하나의 파일로 구성된다.pantry.json이 플래너는 팬트리를 읽고, 12개 항목을 카운터에 올린 뒤, 그 순간 볼 수 있는 재료로 한 주의 저녁 식단을 짠다. 자기 자신을 위해 쓴 텍스트 파일에 유통기한을 적는 사람은 없다. 바로 그 점이 첫 빌드로서 적합한 이유다. 팬트리 파일과 스텁 요리사는 랩에서 쓴 것과 다르지만, 구조는 동일하므로 누수율도 랩의 0.880과는 다르다.
pantry: 40 items, 11 already expired on 2026-09-11 · N=100 weekly plans · k=12

pantry file                   leakage rate   stale items named   of items named
WITHOUT expiry stamps                0.750                 134              242
WITH expiry stamps 0.000 0 372[증거]전체 플랜의 4분의 3이 이미 상한 재료로 요리하라고 가족에게 지시한다. 플랜은 유창하고, 그럴듯하며, 틀렸다. 내가 예상하지 못한 숫자는 마지막에 있다. 스탬프를 붙이니 플래너가 더 많은 재료를 언급한다. 372개 대 242개. 줄어드는 게 아니라 오히려 늘어난다.
이 결과는 사람들이 이 작업을 건너뛰게 만드는 직관을 완전히 뒤집는다. 필터링을 했다고 해서 카운터가 줄어드는 게 아니다. 카운터는 어차피 12개다. 다만 12개 중 5개가 쓸 수 없던 자리를 모두 쓸 수 있는 것으로 바꿨을 뿐이다. 그래서 더 많은 식단이 가능해졌다.큐레이션은 빼기가 아니다.같은 예산을 쓸모 있는 것에 쓴다는 뜻이다. Anthropic의 high-signal-tokens 논리가, 여기서는 냉장고에서 출발해 도착했다.
프로젝트 2 — 엔터프라이즈 사례:the-desk-memory
projects/02-enterprise-desk-memory/ · make measure · make gate
고객 지원 데스크용 컨텍스트 조립기. 티켓을 입력받아, 조립된 컨텍스트를 출력한다. 토큰 예산과 세 가지 불변 조건이 CI에서 게이트된다. 지식 베이스는 144개의 스니펫(버전 관리된 정책 조항, 과거 해결 사례, 날짜가 붙은 계절별 노트)으로 구성되며, 이 중 30개가 만료 상태다. 16개의 대체된 정책 버전과 14개의 만료된 노트가 포함된다.
[증거]불변 조건을 한 번에 하나씩 제거하며, N=100개의 티켓을 처리한다.
what was removed          budget_overflows   stale_fact_leaks   distinct prefixes   exit
nothing                                  0                  0                   1      0
the budget packer                      100                  0                   1      1
the freshness filter                     0                100                   1      1
the stable prefix                        0                  0                 100      1
make gate0번에서 종료.make gate-off신선도 필터를 뺀 같은 게이트 — 1번에서 종료.make gate-removed각 불변 조건을 차례로 제거하고, 제거할 때마다 실패하는지 단언한다. 한 번도 실패하는 걸 본 적 없는 게이트는 희망일 뿐, 게이트라 할 수 없다.
두 번째 행을 주의 깊게 보라. 바로 당신에게 일어날 상황이다. 예산 패커를 제거해도 어디서도 에러가 나지 않는다. 평균 1,420토큰, 최악 1,481토큰을 1,200토큰 카운터에 조립해서 넘긴다. 실제 제공자는 아무런 알림 없이, 원하는 쪽에서 잘라낸다. 그래서 당신이 가장 필요했던 사실이 바로 떨어져 나간다. 그리고 여기, 우리의 병이 있다. 세 번째 행은 대체된 환불 조항이 카운터에 그대로 남아, 100번 중 100번 답변에 인용된다. 겉보기엔 정책 조항과 똑같았다. 실제로도 3월에는 정책이었다.
30분 만에 만들기 — 계약
조립기에 필요한 모든 것, 엔지니어가 묻는 순서대로. 입력: 티켓과 지식 베이스. 출력: 조립된 컨텍스트 하나. 불변 조건: 날짜를 붙일 수 없는 것은 들어올 수 없고, 예산을 넘는 것은 포장되지 않는다. 중단 규칙: 예산에 도달하면 멈춘다. 프리픽스를 잘라내서 공간을 만들지 않는다.
PINNED_PREFIX = system_prompt + tool_schemas   # byte-identical on EVERY request:
                                               # no clock, no session id, sorted keys
SNIPPET = {                                    # the minimal shape of a memory row
  "id":            str,
  "text":          str,
  "expires":       date | None,                # the field that makes refusal possible
  "superseded_by": id   | None,
}
def assemble(ticket, kb, budget=MAX_CONTEXT_TOKENS):
    pool   = [s for s in kb if is_fresh(s)]           # 1. FILTER — before anything else
    ranked = sorted(pool, key=lambda s: -score(s, ticket))   # 2. SCORE
    out, used = [], n_tokens(PINNED_PREFIX)
    for s in ranked:                                  # 3. PACK, newest-relevant first
        if used + n_tokens(s.text) > budget: continue
        out.append(s); used += n_tokens(s.text)
    return PINNED_PREFIX, out, used

# CI gate (make gate): N=100 tickets
#   budget_overflows             == 0
#   stale_fact_leaks             == 0
#   distinct_prefix_fingerprints == 1     (sha256 of the pinned prefix, per request)
# any line off threshold → exit 1 → the build fails
일부러 빠진 항목: 답변 정확도 메트릭(아래의 정직한 간극), 재정렬(순서만 바꿀 뿐, 자격은 안 바뀜), 그리고 실제 모델.
[설계] 이 네 가지는 이 프로젝트를 단순 데모가 아니라 엔터프라이즈급으로 만들어 주는 핵심 요소다. 각각의 이유가 분명하다.
- 점수 산출 전에 먼저 필터링하라. 결과가 나온 뒤가 아니라. 포장 이후에 만료된 조항을 제거하면, 원래 들어갈 수 있었던 신선한 항목이 이미 밀려난 뒤다. 이는 1화의 플랜 게이트와 똑같은 구조다. 플랜 게이트는 어떤 도구도 돌리기 전에 미리 유효성을 검증한다. 사후 필터링은 그저 로그만 정리할 뿐이다.
- 프리픽스는 '의도'가 아니라 '지문'으로 남겨야 한다. 게이트는 요청마다 고정 프리픽스에 해시를 적용해, 100번 요청이 모두 정확히 하나의 값만 갖도록 강제한다. "우리는 프리픽스를 안정적으로 유지한다"는 건 믿음에 불과하다. N=100에 대해 sha256을 돌린 값이야말로 사실이고, 다음 사람이 아무리 친절하게 타임스탬프를 추가해도 살아남는 유일한 버전이다.
- 슈퍼세션은 관례가 아니라 명시적 필드여야 한다.
superseded_by행을 삭제하지 않고 은퇴시키면, 감사 시 3월에 데스크가 무슨 답을 했는지 여전히 추적할 수 있다. 반면 어셈블러는 오늘 그 내용을 제공하지 않는다. 행을 삭제하면 감사 내역이 사라지고, 날짜 없이 남기면 답변의 신뢰성이 무너진다. - 오버플로우는 경고가 아니라 빌드 실패로 간주해야 한다. 제공자는 예산을 초과한 컨텍스트를 조용히 잘라낸다. 어떤 정보가 고객에게서 빠질지 API가 자동으로 결정한다는 뜻이다. 오버플로우를 0에서 게이트하면, 그 결정권이 다시 당신에게 돌아온다.
[오픈] 두 프로젝트 모두 증명하지 못한 부분이 있다. 두 말뭉치는 모두 합성이고, 두 요리사도 스텁이다. 엔터프라이즈 빌드의 솔직한 현재 상태는 실행 가능하고 게이트가 적용된 상태이지, 실제 배포 및 측정 완료는 아니다. 진짜로 만들려면 실제 데스크에서 샘플링한 지식베이스와 그 실제 슈퍼세션 이력이 필요하다. 그리고 세 가지 불변 조건 옆에 답변 정확성 지표가 함께 보고되어야 한다. 신선하고, 작고, 안정적인 컨텍스트도 여전히 잘못된 컨텍스트일 수 있고, 이 세 숫자 중 어느 것도 그것을 감지하지 못하기 때문이다.
같은 맥락, 다섯 갈래의 선택지
뼈대는 하나, 각 독자에게 열려 있는 문은 다섯. 한 가지 결정을 내리고, 한 가지 행동만 이번 주에 실천하라. 나머지는 남겨두어도 된다.
| 당신이 만약 | 이 에피소드가 바꾸는 관점 | 이번 주에 실천할 한 가지 |
|---|---|---|
| 고등학생 빌더라면 | 컨텍스트 엔지니어링은 더 큰 팬트리를 갖는 게 아니라, 조리대 위에 무엇을 올릴지 선택하는 일이다. | Colab 실험실을 2초만에 돌려보고, 팬트리와 조리대 비유를 친구 한 명에게 설명해보라. |
| AI 엔지니어 | 비용은 프리픽스 배치가, 답의 신뢰성은 각 사실에 날짜를 붙일 수 있는지 여부가 좌우한다. | 시스템 프롬프트에서 요청마다 달라지는 항목을 grep으로 찾아낸다. 그 항목을 맨 끝으로 옮긴다. 옮기기 전후로 캐시 히트율을 직접 측정한다. |
| 창업자 | 사용량보다 더 빠르게 늘어나는 추론 비용은 대개 가격 문제가 아니라 캐시 배치의 결함 때문이다. | 팀에게 프리픽스 캐시 히트율을 물어본다. 아무도 모르면, 그게 바로 문제의 실체다. |
| 임원 | "에이전트가 어떤 버전의 정책에서 답변했는가?"는 스키마로 명확히 답할 수 있는 감사 질문이다. | 다음 출시 전까지, 에이전트가 조회할 수 있는 모든 행에 만료일 또는 대체 필드를 반드시 추가하도록 요구한다. |
| 투자자 | 방어벽은 팀이 임대한 윈도우 크기가 아니라, 큐레이션 계층과 그 게이트에 있다. | 어떤 에이전트 스타트업이든 캐시 히트율과 만료 사실 유출률을 함께 물어본다. 둘 중 하나라도 빠지면 그건 보여주기용에 불과하다. |
현실 과제
이번 주에 이미 돌리고 있는 실제 시스템에 15분만 투자한다.
- 실제 에이전트가 두 번 연속 턴에서 실제로 전송하는 바이트를 그대로 출력한다. 내가 보낸다고 생각하는 내용이 아니라, 실제로 네트워크를 타고 나가는 바이트를 본다.
- 두 출력을 diff로 비교해, 처음 달라지는 바이트를 찾는다. 그 이후로는 매 턴마다, 영원히, 다시 프리필된다.
- 그 바이트가 시계, id, 등급, 무작위 툴 순서, 혹은 포맷된 날짜라면, 컨텍스트 맨 끝으로 옮긴다. 그 외에는 건드리지 않는다.
- 메모리 스토어를 열고 스키마에 이렇게 묻는다: 한 행만 보고도 그게 여전히 유효한지 알 수 있는가? 답이 '아니오'라면, 검색 문제가 아니라 컬럼이 빠진 것이다.
- 컬럼을 추가한다. 스코어링 전에 필터링한다. 예전처럼 신뢰하던 것을 다시 돌려본다.
2단계에서 아무것도 안 나오고, 에이전트가 매번 새 싱글샷 프롬프트만 보낸다면, 더 중요한 사실을 배운 것이다. 아직 1단계에 있고, 카운터는 아직 차기 시작하지 않았다. 곧 차기 시작할 것이다.
연구 과제
이 실험을 에이전트에게 맡기고, 실행 전에 예측을 미리 기록한다. 예측하지 않은 결과는 반드시 나중에 합리화하게 된다.
정답 검증이 가능한 인출형 태스크 하나와, 일부 행이 대체된 것이 확실한 코퍼스를 고른다. 모델과 태스크는 고정한다. 컨텍스트 예산(4단계, 빡빡한 것부터 필요한 것의 10배까지)과 신선도 정책(없음 · 만료 필터 · 만료+최신성 가중 재정렬) 두 가지를 독립적으로 바꾼다. 12개 모든 조합에 대해 정답률, 만료 사실 유출률, 프리픽스 캐시 히트율, 비용을 보고한다. 유출률은 답변별·컨텍스트별로 따로 집계한다.
사전 등록:정확도가 예산에 따라 단조롭게 변하는지, 그리고 두 가지 누출 지표가 서로 반대 방향으로 움직이는 경우가 있는지 확인하라.
내 스텁에서는 이 두 지표가 예산이 커질 때 실제로 갈라진다. 그 원인은 스텁의 구조적 특성 때문이다. 실제 모델에서, 실제 이유로 이런 현상이 나타나는지는 아직 아무도 발표하지 않았다. 만약 그런 결과가 실제로 나온다면, 그건 셋업의 버그가 아니라 논문으로 쓸 만한 발견이다.
최근 동향
이 계단의 최신 상황. 30개 선구적 소스를 주간으로 실시간 동기화해 집계한 결과이다.research-anything (make watch-sync기술적 신호만으로 순위를 매기고, 대중적 인기는 고려하지 않는다.
동기화 기준일: 2026-09-11
- arXiv:2609.11728 (2026-09-10) — Reproducibility in the Age of Agentic AI: Context Engineering at the Timescale of a Codebase. 집필 시점 기준 하루 된 논문. 재현 가능한 연구 관행—테스트, 커밋 이력, 저장소 구조, 결정 기록—을 코딩 에이전트의 컨텍스트 엔지니어링 관점에서 해석하며, 저자는 연구자가 산출물 검증 책임을 끝까지 져야 한다고 강조한다.
- arXiv:2608.23992 (2026-08-25) — Hybrid Semantic Tool Discovery for Enterprise MCP Gateway. 이번 글에서 직접 측정해보고 싶었던 실전 수치: PayPal에서 2,000개가 넘는 툴을 200여 서버에 노출하는 데 140,200토큰, 즉 컨텍스트 윈도우의 70.1%가 소모됐고, 사용자의 질문이 도착하기 전이었다. 이 덤프를 두 개의 검색 툴로 대체하자 1,300토큰, 0.8%로 줄었다. 논문 자체도 이 현상을 리트리벌 문제가 아니라 컨텍스트 엔지니어링 병목으로 다룬다.
- arXiv:2608.29016 (2026-08-29) — Towards Fully Automated Medical Imaging Code Generation via Validation-based Context Engineering. 컨텍스트를 도메인 지식베이스, 공유 메모리, 검증 피드백에서 조립하며, 수작업이 아니라 자동화로 여섯 개 데이터셋과 다섯 개 백본 모델에 적용. 방향성은 컨텍스트 구성 자체가 독립적으로 테스트 가능한 컴포넌트가 되어가고 있다는 점이다.
- 이전이지만 핵심을 떠받치는 논문들: arXiv:2005.11401 (RAG), arXiv:2307.03172 (Lost in the Middle), arXiv:2310.08560 (MemGPT), 그리고 2025년 실무자 정전—LangChain의 네 가지 버킷, Chroma의 Context Rot, Manus의 캐시율 포스트, Anthropic의 엔지니어링 포스트.
[OPEN]아직 변하지 않은 것. 2026년 최신 롱컨텍스트 모델에서 Chroma의 성능 저하 곡선을 재현한 결과는 찾지 못했다. 컨텍스트 로트에 대한 가장 강력한 공개 증거는 여전히 2025년 7월 벤더가 직접 수행한 리포트와 2023년 논문뿐이며, 2026년 모델에서는 독립적으로 반복된 바 없다. 효과의 크기는 유보적으로 보고, 방향성은 충분히 뒷받침된 것으로 간주하라. 또한 여러 제공자에 걸친 프리픽스 캐시 적중률의 통제된 공개 측정도 찾지 못했다. 모두가 인용하는 10배 캐시/비캐시 차이는 한 벤더의 일시적 리스트 가격에서 비롯된 것이다.
이탈 테스트
위로 스크롤하지 말고, 스스로 답을 점검하라.
- 팬트리와 조리대의 차이는 무엇이며, 더 큰 컨텍스트 윈도우가 확장하는 것은 둘 중 어디인가?
- 시스템 프롬프트 맨 앞에 타임스탬프가 있을 때와 맨 끝에 있을 때, 두 경우 모두 토큰 수는 같은데 왜 앞에 있을 때 비용이 더 많이 드는가?
- "백만 토큰 윈도우면 검색 문제는 해결된다"는 주장에 반박하는 두 가지 측정치를 말하고, 각각 무엇을 고정했는지 설명하라.
- 리트리버가 아무리 뛰어나도 메모리 저장소에 만료 필드가 없다면, 왜 유출률이 0이 될 수 없는지 한 문장으로 설명하라.
- 만료 사실 유출률이 0.000으로 나온다. 이 수치가 거짓일 수 있는 가장 쉬운 방법과, 반드시 함께 보고해야 할 단일 지표를 제시하라.
막간
이제 조리대를 바로잡았다.
모든 변동 필드를 맨 끝으로 옮겼다. 프리픽스는 100번의 요청에서 모두 동일한 해시값을 가진다. 모든 행에는 만료일과 대체 포인터가 붙고, 조립기는 날짜가 없는 항목은 거부한다. 예산을 선언하고, 초과는 0에서 차단한다. 캐시 적중률 0.978, 유출률 0.000. 단 하루 동안은 주방을 완벽하게 통제했다고 믿는다.
그런데 고객이 문의를 남긴다. 에이전트는 티켓을 읽고, 정확히 현재 정책의 해당 조항을 찾아내어, 모든 면에서 올바른 답변을 작성한다.
그리고 환불을 실행한다.
두 번이나 실행한다. 첫 번째 호출이 타임아웃 되었는데, 환불은 재시도 대상이 아니라는 걸 아무도 알려주지 않았기 때문이다. 데스크 한도를 넘는 금액이었지만, 그 한도를 에이전트가 읽을 수 있는 곳에 적어둔 사람이 없었다. 그리고 티켓 시스템과 결제 시스템에 서로 다른 순서로 기록해서 두 시스템의 상태가 어긋났다. 되돌리기를 요청하면, 없다.
조리대는 깨끗했다. 사실들은 신선했다. 하지만 요리사가 만질 수 있는 범위를 아무도 정하지 않았다.
3화 — 레스토랑 주방 하니스 엔지니어링: 모델이 올바른 사실을 봐도 여전히 행동하지 못한다. 그리고 첫 번째 하니스가 네 셀 중 두 곳에서 상황을 더 악화시킨다는 측정 결과가 있다.
이어 읽기
2화 —Intelligence Engineering Adventures, 시즌 7 — 주방 사다리. 시리즈 원본의 주장들은 정의, 도출, 증거, 엔지니어링 선택, 오픈 퀘스천 등으로 구분되어 있다. 비유는 주장을 소개할 수 있지만, 결코 증거가 될 수 없다. 각 화마다 Colab 무료 노트북(키 불필요)과, 처음부터 만든 두 개의 애플리케이션(개인용, 엔터프라이즈형)을 함께 제공한다. 사다리의 원형은 Feng 외(arXiv:2608.21156)이며, 내 창작이 아니다. 'what moved' 섹션은 30개 선구적 소스를 기술적 신호 기준으로만 실시간 동기화해 생성된다. 이 글에는 어떤 고용주나 클라이언트의 자료도 포함되어 있지 않다. — Paul Jialiang Wu · futuremake.io
참고문헌
- Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., Liang, P. (2023). Lost in the Middle: How Language Models Use Long Contexts. arXiv:2307.03172 — 초록 페이지 2026-09-11 열람. 위치 관련 문장은 영어 원문 그대로 인용함. 최종 출판본: TACL 12 (2024); 두 초록을 비교해보니 완전히 동일하므로, 인용문은 두 버전 모두에 해당한다.
- Ji, Y. ("Peak") (2025-07-18). Context Engineering for AI Agents: Lessons from Building Manus. manus.im/blog — 2026-09-11 전체 열람. KV-cache-hit-rate 인용, prefix 내 timestamp 인용, 100:1 input-to-output 비율, 실험에 사용된 캐시/비캐시 단가의 출처.
- Anthropic (2025-09-29). Effective context engineering for AI agents. anthropic.com/engineering — 2026-09-11 열람. 한정된 자원 인용 및 연혁 표에 설명된 attention-budget 프레이밍의 출처.
- Hong, K., Troynikov, A., Huber, J. (2025-07-14). Context Rot: How Increasing Input Tokens Impacts LLM Performance. Chroma 기술 보고서, research.trychroma.com/context-rot — 2026-09-11 열람. 18개 모델, 작업 난이도 고정, 입력 길이만 변화.
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. (2026). Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2, 2026-08-26 개정 — 본 시리즈의 계단식 분류에서 "Context Engineering to manage information access"(번역: 정보 접근을 관리하는 컨텍스트 엔지니어링)라는 문구는 초록에서 직접 인용함.
- Lewis, P., Perez, E., Piktus, A. 외 (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv:2005.11401 (NeurIPS 2020) — 연표상 2020년의 전환점으로, 초록만 참고했으며 직접 인용은 아님.
- Packer, C., Wooders, S., Lin, K. 외 (2023). MemGPT: Towards LLMs as Operating Systems. arXiv:2310.08560 — 가상 컨텍스트 관리에 관한 논문으로, 초록만 참고했고 인용은 아님.
- Willison, S. (2025-06-27). Context engineering. simonwillison.net — 2025년 6월 두 포스트 모두에서 내가 읽은 원본 기록. 원저자: Tobi Lütke와 Andrej Karpathy; 두 글 모두 클라이언트 사이드 렌더링이므로, 여기 인용문은 Willison의 전사에서 가져와 각각 출처를 명확히 표기함.
- The LangChain Team (2025-07-02). Context Engineering. langchain.com/blog — 작성·선택·압축·분리의 네 가지 분류법을 제시함; 2026-09-11에 읽었으며, 직접 인용은 아니고 설명만 포함.
- Barba, L. A. (2026-09-10). Reproducibility in the Age of Agentic AI: Context Engineering at the Timescale of a Codebase. arXiv:2609.11728 — "what moved"; 초록 페이지 2026-09-11 열람.
- Saha, O. 외 (2026-08-25). 엔터프라이즈 MCP 게이트웨이용 하이브리드 시맨틱 툴 디스커버리: 아키텍처와 구현. arXiv:2608.23992 — "what moved"; 140.2k → 1.3k 토큰 수치는 초록 페이지에서 인용, 2026-09-11 열람.
- Zhao, Z. 외 (2026-08-29). 검증 기반 컨텍스트 엔지니어링을 통한 완전 자동 의료 영상 코드 생성. arXiv:2608.29016 — "what moved"; 초록 페이지 2026-09-11 열람.
- Dhage, S. (2026). 예측 가능한 에이전트형 시스템을 위한 하니스 엔지니어링: 결정적 실행 제약에 대한 실증 연구. arXiv:2608.26197 — 에피소드 1의 측정값으로, 여기서는 플랜 게이트 구조를 설명하며 에피소드 3의 예고편 역할도 한다.
- Anthropic (2024-12-19). 효과적인 AI 에이전트 구축. anthropic.com/engineering — 시리즈 표에서 하니스 엔지니어링의 기준점.
- 이번 에피소드의 실험과 프로젝트 — 모든 셀은 출간 전 실행 완료: gist.github.com/wjlgatech/47eb7973aa5e292524c9c205c73c34d9 —
02_context_budget.ipynb,the-fridge-list,the-desk-memory. - Intelligence Engineering Adventures, 시즌 7, 에피소드 1 — 프롬프트 엔지니어링은 마법이 아니라 명세다, 이번 에피소드가 다루는 레시피 카드, 플랜 게이트, 결정성 지표에 관하여.