Serie AI-Native · Ingeniería de Agentes, comparada: Prompt · Contexto · Harness · Bucle · Grafo
La ingeniería de prompts es una especificación, no un hechizo
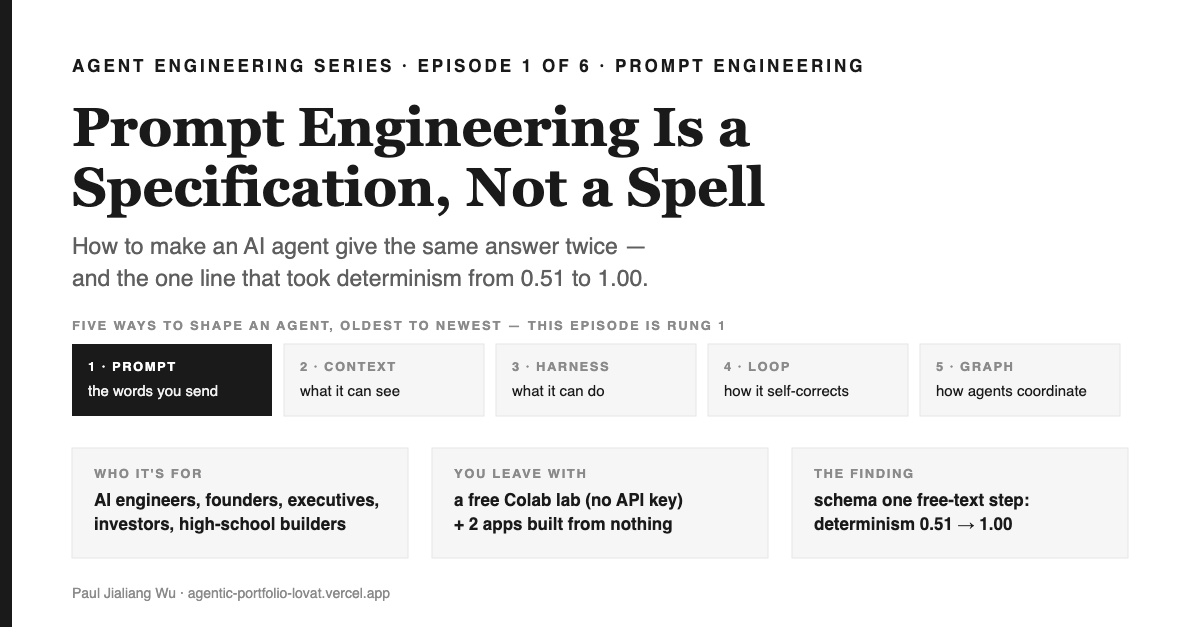
Episodio 1 de 6. Esta serie compara las cinco formas en que se puede diseñar un agente de IA —ingeniería de prompts, ingeniería de contexto, ingeniería de harness, ingeniería de bucles e ingeniería de grafos—: de dónde viene cada una, qué controla, quién la impulsa y qué principios resisten la prueba de la medición. Este episodio es el peldaño más antiguo, la ingeniería de prompts, y la medición de 2026 que demuestra que no está resuelta.
En un minuto — ideas clave para llevarte
¿De qué va esto? Una serie comparativa sobre las cinco formas de diseñar un agente de IA — ingeniería de prompts (las palabras que envías), ingeniería de contexto (lo que puede ver), ingeniería de harness (lo que puede hacer), ingeniería de bucles (cómo se autocorrige) e ingeniería de grafos (cómo se coordinan varios agentes). Este episodio trata sobre la ingeniería de prompts: su historia desde GPT-3 en 2020 hasta 2026, quién la impulsa y los principios que realmente resisten la prueba.
Por qué importa. Los agentes dan respuestas diferentes a la misma solicitud, y eso es lo que impide que lleguen a clientes, pasen una auditoría o se les confíe dinero. Un estudio de 2026 encontró que la causa habitual no es la falta de un framework sino un paso de texto libre sin restricciones; ponerle un esquema a ese paso llevó la reproducibilidad a 1.000 en 100 ejecuciones — en tres de cuatro celdas, en dos tareas sintéticas y dos modelos open-weight, aún sin replicación independiente; nuestro propio router reproduce ese salto (0.510 → 1.000) en seis tickets sintéticos. Para una persona fundadora, esa es la diferencia entre un demo y un producto. Para una persona ingeniera, es un arreglo que puedes hacer esta misma tarde.
Qué puedes aplicar después de leer. Escribe un prompt como una especificación verificable, mide cuántas veces produce el mismo resultado, identifica el paso de texto libre que causa la variación y ponle un control. Te llevas un notebook de Colab gratis (sin API key) y dos aplicaciones funcionales hechas desde cero: un generador de listas de compras cuya primera ejecución medida demostró que mi propia especificación estaba mal, y un router de solicitudes de cambio de TI cuyo índice de determinismo pasa de 0.510 → 1.000 con un control de CI que falla el build si se desvía.
Season 7 — la espina de la serie
- Ingeniería de prompts — una especificación, no un hechizo este episodio
- Ingeniería de contexto — un presupuesto, no una ventana más grande episodio 2
- Ingeniería de harness — el envelope, no el agente episodio 3
- Ingeniería de bucles — un árbitro externo, no un reintento episodio 4
- Ingeniería de grafos — una agenda, no un elenco de personajes episodio 5
- Ingeniería de evaluación — la función de verdad, no un leaderboard episodio 6
De qué va este episodio y por qué la ingeniería de prompts es el primer escalón
Hoy existen cinco disciplinas con nombre propio para construir agentes de IA, y surgieron más o menos en este orden: ingeniería de prompts (2020), ingeniería de bucles (2022), ingeniería de grafos (2023), ingeniería de harness (2024) e ingeniería de contexto (2025). La declaración publicada más clara del conjunto es el estudio de Feng et al. (arXiv:2608.21156), que las ordena según lo que cada disciplina te permite controlar en vez de por antigüedad: prompt → contexto → ingeniería de harness → ingeniería de bucles → ingeniería de grafos. Esta serie toma una por episodio, en ese orden, y les hace las mismas cuatro preguntas a cada una: de dónde viene, qué controlas exactamente, quién la impulsa y qué falla te obliga a subir al siguiente peldaño.
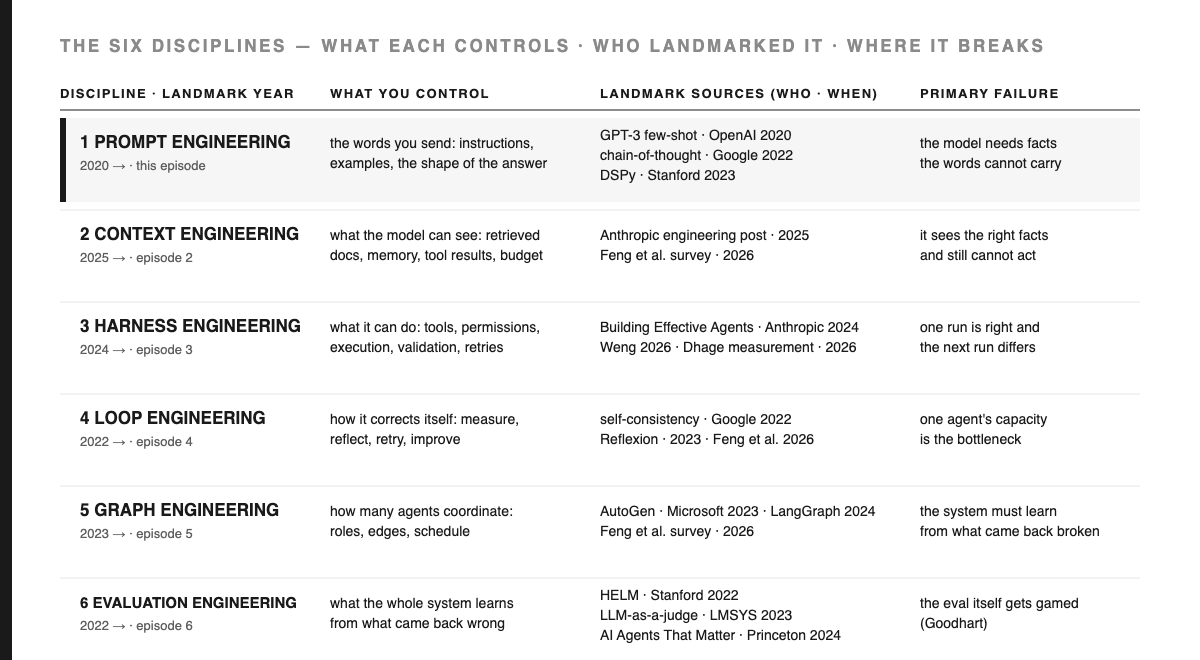
La ingeniería de prompts va primero porque todo lo que está encima está limitado por ella. La medición de 2026 en el centro de este episodio (Dhage, arXiv:2608.26197) buscaba demostrar que una ingeniería de harness — tercer peldaño — hace que los agentes sean reproducibles. Pero en realidad encontró que la varianza que quedaba venía de un solo lugar donde el modelo todavía podía escribir prosa, y que restringir ese único paso a nivel de prompt logró lo que la ingeniería de harness no pudo. No puedes saltarte el primer peldaño.
¿Para quién es esto? Un ingeniero de IA que necesita que la misma entrada produzca la misma salida. Un fundador decidiendo si un demo de agente puede convertirse en producto. Un estudiante de secundaria que quiere saber qué es realmente la "ingeniería de prompts", sin el misticismo. El único requisito es haber llamado a un modelo de lenguaje al menos una vez.
De dónde viene la ingeniería de prompts y quién la impulsa
[DEF] Un prompt es el texto que le envías a un modelo de lenguaje: las instrucciones, los ejemplos y la forma en que quieres la respuesta. La ingeniería de prompts es la disciplina de escribir ese texto para que la salida sea lo que necesitabas. Esa es toda la definición. La historia es cómo pasó de ser un truco a una especificación.
| Cuándo | Hito | Quién | Qué cambió |
|---|---|---|---|
| 2020-05 | GPT-3: Language Models are Few-Shot Learners (arXiv:2005.14165) | Brown et al., OpenAI | Unos pocos ejemplos en la entrada guían al modelo sin actualizar pesos. Las palabras se vuelven una superficie de control. |
| 2021-02 | Prompt Programming for Large Language Models (arXiv:2102.07350) | Reynolds & McDonell | Sostienen que el encuadre, y no los ejemplos, es lo que realmente marca la diferencia. "Prompt programming" entra al vocabulario. |
| 2021-07 | Pre-train, Prompt, and Predict revisión (arXiv:2107.13586) | Liu et al., Carnegie Mellon | Identifica el prompting como un paradigma propio, distinto del fine-tuning. |
| 2022-01 | Chain-of-thought prompting (arXiv:2201.11903) | Wei et al., Google Research, Brain Team | Un patrón de frases en el prompt cambia la precisión del razonamiento. El prompt empieza a comportarse como un programa. |
| 2022-03 | Self-consistency (arXiv:2203.11171) | Wang et al., Google | Genera varias cadenas de razonamiento y toma la mayoría: el primer loop que nace de un prompt. |
| 2022-05 | "Let's think step by step" (arXiv:2205.11916) | Kojima et al., University of Tokyo and Google | El clímax de la era de los conjuros: una sola frase, un efecto grande y medible. |
| 2022-09 | "Prompt injection" nombrado (simonwillison.net) | Simon Willison | El prompt es una superficie de ataque, así que es un artefacto de seguridad, no un texto de marketing. |
| 2023-03 | Ingeniería de promptsencuesta (lilianweng.github.io) | Lilian Weng | Las técnicas quedan organizadas en un mapa. La misma autora publica sobre ingeniería de harness tres años después. |
| 2023-10 | DSPy (arXiv:2310.03714) | Khattab et al., Stanford | Prompts generados a partir de firmas declaradas y una métrica. La ingeniería de prompts evoluciona a programación de prompts con optimizador. |
| 2024–25 | Guías de prompt engineering de los proveedores (Anthropic, OpenAI) | los model labs | La práctica común: instrucciones explícitas, ejemplos, salida estructurada, espacio para razonar, llamadas encadenadas. |
| 2025-03 | Promptware Engineering (arXiv:2503.02400) | Chen et al. | Los prompts como artefactos de software: requisitos, pruebas, versionado y mantenimiento. |
| 2026-08 | La escalera de cinco niveles (arXiv:2608.21156) y el estudio sobre determinismo (arXiv:2608.26197) | Feng et al.; Dhage | La ingeniería de prompts aparece como el primer nivel de cinco — y se demuestra que sigue siendo la restricción clave. |
[DISEÑO] Tres cosas clave en esa tabla. Primero, esta disciplina no nació como ingeniería: empezó en 2020 con el hallazgo de que las palabras en el input dirigen al modelo sin reentrenarlo. Segundo, la era de la “frase mágica” tuvo su auge en 2022 y terminó a finales de 2023, cuando DSPy de Stanford reemplazó los prompts escritos a mano por firmas declaradas y un optimizador. Tercero, la práctica común —las propias guías de Anthropic y OpenAI— coincidió en una lista breve: sé explícito, muestra ejemplos, da estructura a la salida, permite que el modelo razone antes de responder, y divide los trabajos grandes en llamadas encadenadas. Nada de eso es magia. Cada punto es una restricción que permite verificar la salida, y esa es justo la definición que sostiene este episodio.
Quién lo lidera hoy. Los laboratorios de modelos (OpenAI, Anthropic, Google) publican las guías y controlan los prompts de sistema. DSPy de Stanford NLP y el programa de “promptware” en ingeniería de software están convirtiendo los prompts en artefactos versionados y probados. Practicantes independientes mantienen a los laboratorios bajo escrutinio — Simon Willison acuñó el término prompt injection en 2022 y estaba anotando el prompt de sistema más reciente de Claude el día antes de que esto saliera publicado. La medición sobre la que se apoya este episodio no vino de ninguno de ellos: es un estudio empírico de un solo autor publicado tres semanas antes del cierre de edición.
El modelo mental de la serie: la escalera de la cocina
Una imagen va a sostener los seis episodios, así que aquí va, planteada como herramienta y no como historia. Toda persona que cocina sube la misma escalera: primero cocinas para ti, luego para tu familia, después en la cocina de un restaurante, luego diriges una cadena de comida rápida, y finalmente gestionas la cadena nacional de suministro que alimenta a varias cadenas. Cada ingeniero de IA sube una equivalente: aprendiz escolar, desarrollador junior, desarrollador senior, líder técnico de IA, CTO, líder de frontera — y cada peldaño de la ingeniería de agentes es una cocina en esa escalera. El primer peldaño es la tarjeta de receta. La escribes; un cocinero con el que no puedes hablar prepara el plato; tú no estás en la cocina y no puedes probar mientras avanza. Todo lo que quieres debe caber en la tarjeta, por adelantado, sin oportunidad de aclarar:
Salteado de tomate con huevo para dos. Tres huevos, dos tomates, 3 g de sal, 1 cdita de azúcar. Los huevos se revuelven suaves primero y se sacan de la sartén antes de poner los tomates — así quedan suaves. En la mesa en 12 minutos.
Esa tarjeta es un prompt. El cocinero es el modelo. Cada disciplina superior es una parte distinta de la cocina que puedes controlar: la despensa y la encimera desde donde trabaja el cocinero (contexto), las estaciones y herramientas disponibles (ingeniería de harness), la prueba de sabor y la corrección (loop), la cadena de suministro que alimenta muchas cocinas (graph). En este episodio solo tienes control sobre la tarjeta y nada más. Ni la despensa, ni las herramientas, ni lo que pasa después de entregar la tarjeta.
| Peldaño | Cocina | Quién eres | Qué puedes definir |
|---|---|---|---|
| 1. prompt | la tarjeta de receta — cocinando para ti | aprendiz escolar | las instrucciones escritas que sigue el cocinero |
| 2. contexto | la despensa — cocinando para la familia | desarrollador junior | lo que hay disponible en la encimera y en el refrigerador durante la preparación |
| 3. harness | la cocina de restaurante | desarrollador senior | las estaciones, las herramientas al alcance, el control de calidad antes de servir cada plato |
| 4. loop | la cadena de comida rápida | líder técnico de IA | probar, medir, corregir y aplicar la solución en todas las sucursales |
| 5. graph | la red nacional de suministro | CTO | muchas cocinas, un solo calendario, una flota de camiones |
| 6. evaluación | el registro de devoluciones | líder en la frontera | lo que todo el sistema alimentario aprende de los errores — tema del episodio 6 |
Dos ejes, no uno.Lee la tabla con atención: no es una escalera que subes y dejas atrás; cada cocina tiene las seis capas a la vez. Quien cocina en casa tiene una tarjeta, una despensa, una estufa, un paladar y un proveedor. Lo que cambia al avanzar —como cocinero o como ingeniero— es cuántas capas puedes intervenir y con cuánta rigurosidad ejecutas cada una: primero a ojo, luego midiendo, después con validaciones, y finalmente autocorrigiendo. Una cadena nacional con un diagrama bonito de logística pero sin prueba de sabor es menos madura que un solo restaurante que pesa cada plato. Así que las cinco disciplinas son capas (lo que controlas); la experiencia es madurez (cómo las ejecutas); y "graph" no es automáticamente más avanzado que "loop". La sexta capa, aún abierta, tiene un candidato fuerte: la ingeniería de evaluación, la función de verdad que las demás capas toman prestada para saber si mejoraron — y el episodio 6 la va a defender, no a dar por sentada.
La analogía puede introducir una idea, pero nunca sirve como evidencia: cada elemento está anclado a algo concreto en código en el mapa técnico 1:1 de abajo. Y el episodio termina con el descubrimiento de que una tarjeta de receta perfectamente escrita sigue produciendo platos distintos, porque la tarjeta no es lo único que hay en la cocina cuando se cocina. Eso es el episodio 2.
La escalera no la inventé yo
[DEF] El vocabulario, anclado a su fuente — porque cinco etiquetas compiten por el mismo terreno y la mayoría de los listados populares lo presentan mal.
La exposición más clara y publicada de la escalera está en el estudio de Feng et al. (arXiv:2608.21156, revisado 2026-08-26). Enumera cuatro peldaños y luego argumenta por un quinto: "Prompt Engineering to elicit model capabilities, Context Engineering to manage information access, Harness Engineering to organize external tools and resources, and Loop Engineering to support continual reflection and self-improvement" (Traducción: Ingeniería de prompts para extraer capacidades del modelo, ingeniería de contexto para gestionar el acceso a la información, ingeniería de harness para organizar herramientas y recursos externos, e ingeniería de bucles para fomentar la reflexión continua y la auto-mejora) — y luego ingeniería de grafos, para lo que los autores llaman System Intelligence, el punto en el que la capacidad organizativa de un agente es la restricción principal, más que su habilidad.
[DESIGN] Fíjate en lo que esto implica para el esquema de cuatro etiquetas que seguramente has visto — prompt, harness, loop, graph. Falta un peldaño, y no es menor. La ingeniería de contexto ocupa el segundo lugar, entre prompt e ingeniería de harness, y es el peldaño sobre el que la literatura práctica ha escrito más palabras. El episodio 2 trata sobre el peldaño que los listados populares omiten.
[OPEN] Observa también lo que la encuesta no afirma: que cada peldaño reemplaza al anterior. Esa es la interpretación que invitan las etiquetas y la que esta temporada va a seguir poniendo a prueba. La temporada 6 de esta serie examinó específicamente la afirmación de anidamiento — un prompt dentro de un harness, un harness ejecutando bucles, un grafo coordinando bucles — y encontró que se contradice con su propia fuente principal, ya que la definición de Anthropic hace que el harness sea el loop y no una capa superior. Ese hallazgo se mantiene. Esta temporada suma una pregunta diferente: cuando falla un peldaño, ¿el siguiente es la solución?
La afirmación, clasificada
[DEF] Un prompt es una especificación. No es una petición, ni un conjuro, ni una "palabra mágica" — es una declaración escrita de lo que la salida debe cumplir, entregada a un trabajador que no puede pedir aclaraciones.
[EVIDENCE] La razón para tomar esa definición literalmente y no de forma poética es que alguien por fin la midió, y el resultado es más claro que el folclore.
El estudio empírico de Dhage (arXiv:2608.26197, 2026-08-25) se propuso probar si envolver un agente en una capa de ejecución determinista — control de estados finitos, selección forzada de herramientas, validación de salida, reintentos acotados, planificación estructurada — lo hace reproducible. Dos tareas sintéticas (finanzas y legal), dos modelos open-weight (Qwen-2.5-7B-Instruct y Gemma-3-27B), cuatro celdas modelo-tarea.
El resultado inicial es un caos, y el propio artículo lo dice sin rodeos: el harness "significantly improves reproducibility in one of four model-task cells, significantly degrades it in two, and has no effect in the fourth." (Traducción: mejora significativamente la reproducibilidad en una de las cuatro combinaciones modelo-tarea, la degrada significativamente en dos y no tiene efecto en la cuarta.)
Vuelve a leerlo. En tres de las cuatro celdas no hubo mejora o incluso empeoró. El equipo añadió restricciones y el panel de control levantó una alerta. Si te hubieras detenido ahí, el titular honesto habría sido la ingeniería de harness no funciona.
[EVIDENCE] Luego, el diagnóstico a nivel de traza encontró la causa, y esa causa es la razón de ser de este episodio. Cuando la secuencia de herramientas, la secuencia de estados y la salida ya eran muy consistentes, la fuente principal de variabilidad entre ejecuciones era un paso de planeación en texto libre sin restricciones. Un punto de la cadena donde el modelo todavía podía escribir prosa.
Restringir solo ese paso — "validating the plan against a fixed schema before any tool is invoked" (Traducción: validar el plan contra un esquema fijo antes de invocar cualquier herramienta) — "eliminates the effect entirely: three of four cells reach a Reproducibility Rate and Determinism Index of 1.000 at N=100, and task success rises to 100% in three of four cells." (Traducción: elimina el efecto por completo: tres de cuatro celdas alcanzan una Tasa de Reproducibilidad y un Índice de Determinismo de 1.000 con N=100, y el éxito en la tarea sube al 100% en tres de cuatro celdas.)
[DERIVATION] Así que el hallazgo, expresado como una regla práctica: la maquinaria más sofisticada en los peldaños superiores está limitada por el fragmento de lenguaje menos restringido en cualquier parte del sistema. No logras determinismo añadiendo capas. Lo logras encontrando el único lugar que sigue generando texto libre y dándole una estructura.
Ese es un problema de primer peldaño con una solución de primer peldaño, descubierto por gente que intentaba demostrar el tercer peldaño.
[DESIGN] Y el costo no es cero, y el artículo lo deja claro: "token cost falls in every cell, but latency shows a genuine, sample-size-robust split by model — one becomes faster under the constraint, the other markedly slower." (Traducción: el costo en tokens baja en todas las celdas, pero la latencia muestra una diferencia real y robusta según el modelo: uno se vuelve más rápido bajo la restricción, el otro notablemente más lento.) Más barato, más confiable y, según el modelo, quizá más lento. La conclusión del propio artículo es la que hay que tomar: la ingeniería de harness es una disciplina real "but its cost is model-dependent and must be measured, not assumed." (Traducción: pero su costo depende del modelo y debe medirse, no asumirse.)
[OPEN] Dos límites honestos sobre todo lo anterior. Es un solo artículo, dos tareas sintéticas, dos modelos open-weight de 7B y 27B, sin replicación independiente. Y "determinismo" es una meta más extraña de lo que parece: un sistema que da la misma respuesta cada vez no necesariamente da una respuesta buena cada vez. Reproducibilidad y corrección son ejes distintos, y el artículo mide ambos precisamente porque pueden moverse en direcciones opuestas.
Mapa técnico 1:1
Cada elemento de la metáfora corresponde exactamente a algo que puedes señalar en el código. Una metáfora puede introducir una afirmación, pero nunca sirve como evidencia — así que aquí va la traducción, sin nada decorativo.
| La cocina | El sistema | Dónde vive |
|---|---|---|
| la tarjeta de receta que se le entrega al cocinero | el prompt — mensaje del sistema + mensaje del usuario | messages[] |
| "3 g de sal" | una restricción estricta que debe poder verificarse | un campo del esquema con un límite definido |
| "para que queden suaves" | el motivo de la restricción | la parte que el modelo realmente usa para resolver dudas o ambigüedades |
| "en la mesa en 12 minutos" | un plazo que la cocina no puede negociar | un presupuesto: tokens, tiempo de ejecución, reintentos |
| "al gusto" — la frase que la tarjeta de receta anterior evitó escribir | el único paso de texto libre | el campo de planeación sin restricciones que identificó el diagnóstico de trazas |
| el criterio del cocinero | todo lo que no especificaste | el prior del modelo — tu valor predeterminado real |
| dos platos distintos a partir de la misma receta | variabilidad entre ejecuciones | Tasa de Reproducibilidad sobre N ejecuciones |
| un plato cocinado perfectamente, pero servido a alguien alérgico | cumple la especificación, falla el propósito | tus afirmaciones eran incompletas |
| la revisión final antes de que el plato salga de la cocina | validación de salida | un esquema JSON, validado antes de usarse |
[DEF] Los dos números sobre los que se apoya el resto de esta temporada, definidos una sola vez:
- Tasa de Reproducibilidad — sobre N ejecuciones idénticas, la fracción que produce exactamente la misma salida. No dice nada sobre calidad. Solo: ¿hace lo mismo dos veces?
- Índice de Determinismo — la misma idea, pero aplicada a la trayectoria en vez de solo la respuesta final: misma secuencia de herramientas, mismo estado, mismo resultado.
Un sistema puede marcar 1.000 en ambos y estar equivocándose de forma consistente. Eso es una característica de la métrica, no un defecto. Separa "¿es estable?" de "¿es correcto?", y realmente no puedes depurar lo segundo hasta que hayas resuelto lo primero.
Puerta de Predicción
Antes de seguir leyendo, comprométete. Escribe tu respuesta — el objetivo de este ejercicio es que una predicción que no anotaste es una predicción que luego creerás haber acertado.
Tomas un prompt que genera una salida estructurada. Anotas veinte condiciones que esa salida debe cumplir: campos presentes, tipos correctos, valores permitidos, longitudes acotadas. Lo ejecutas 100 veces con temperatura 0.
Q1. ¿Qué porcentaje de las ejecuciones produce una salida idéntica, byte por byte?
Q2. Ahora haces un solo cambio: el modelo debe primero emitir un plan que valide contra un esquema fijo antes de llamar cualquier herramienta. ¿Qué pasa con el porcentaje de la P1 — y qué ocurre con la latencia?
Q3. Ordena estos tres según cuánto reducen la variabilidad entre ejecuciones, de mayor a menor: (a) bajar la temperatura a 0, (b) añadir veinte condiciones explícitas al texto del prompt, (c) validar con un esquema un paso de texto libre.
Las respuestas están en la Sala de Fallos y en el Notebook. Si pusiste la P3 en el orden intuitivo, el notebook sí vale tus quince minutos.
Sala de Fallos
Rompe el mecanismo a propósito. Un mecanismo que no puedes romper es solo una afirmación, no un mecanismo real.
Fallo 1 — temperatura 0 no es determinismo. La creencia más común en este nivel, y es falsa en la práctica. Temperatura 0 hace que el sampling sea determinista (greedy); no vuelve el sistema determinista, porque el batching, la no-determinismo del kernel en GPU, los resultados de herramientas, los timestamps y el orden de recuperación pueden variar por debajo. Las cuatro celdas de Dhage están en condiciones controladas y aun así muestran variabilidad suficiente para justificar un paper entero. Si tu argumento de confiabilidad es "pusimos la temperatura en cero", ni has empezado.
Fallo 2 — la condición que no escribiste. La tarjeta dice 3 g salt. El cocinero usa exactamente 3 g — y el plato sigue estando demasiado salado, porque especificaste la sal y nunca mencionaste la salsa de soya, que ya aporta la suya. Toda especificación incompleta parece completa hasta el primer plato. Por eso el notebook te obliga a escribir condiciones antes de mirar cualquier salida: las condiciones escritas después solo describen lo que obtuviste.
Fallo 3 — la sobre-especificación anula la capacidad que estabas pagando. Si te vas al otro extremo, tienes el fallo espejo. Restringe cada campo, prohíbe toda desviación, y has escrito una if declaración carísima — un cocinero que sigue la tarjeta con la creatividad culinaria de una engrampadora. El juicio del cocinero es lo que contrataste. La pregunta de ingeniería nunca es ¿cuánto puedo restringir? — sino qué paso sin restricciones está generando la mayor parte de la variabilidad, que es justamente la pregunta que el diagnóstico a nivel de trazas en arXiv:2608.26197 responde de forma empírica, no por intuición.
Fallo 4 — la métrica que marca 1.000 y no sirve para nada. Lleva la Reproducibility Rate a 1.000 haciendo que el modelo devuelva {} siempre. No es una broma; así es como ocurre la mayoría del reward hacking. Cualquier métrica de determinismo debe reportarse junto a una métrica de éxito en la tarea, o es una invitación a hacer trampa. El paper reporta ambas, y el notebook también.
Respuesta a la Q3: (c), luego (b), luego (a) — y la diferencia no es pequeña. Validar con un esquema un solo paso de texto libre llevó tres de cuatro celdas a 1.000. Añadir aserciones al texto ayuda a que el modelo se esfuerce más, pero no hace que nada sea verificable. La temperatura 0 ya estaba aplicada cuando se midió la variabilidad.
Notebook
Lab 01 — Variabilidad, y el único paso que la elimina. 
labs/01_prompt_as_specification.ipynb · Colab gratuito · sin API key · ~15 segundos de CPU · cada celda ejecutada antes de publicar.
Ocho celdas. El worker es un stub cuya decisión se deriva de un campo de texto libre plan — esa única decisión de diseño es todo el laboratorio, porque un paso de texto libre antes de una decisión no añade variabilidad superficial, mueve la decisión.
- El worker, con cuatro modos de fallo de empaquetado mantenidos deliberadamente independientes del plan, para que el diagnóstico pueda detectar que la decisión cambió respecto a el JSON estaba mal formado.
- Las aserciones, escritas como un esquema antes de revisar cualquier salida.
- Línea base con N=100: reproducibilidad 0.280, índice de determinismo 0.330, éxito de la tarea 0.890.
- Reintento limitado — el arreglo de una sola línea que todo framework incluye. El éxito de la tarea sube a 1.000. El determinismo sube a 0.440.
- El diagnóstico a nivel de trazas, atribuyendo la varianza a cada campo.
plany los campos de decisión posteriores son los que más pesan;ticket_idnunca cambia. - El recorrido, y la celda que vale la pena copiar. Varía qué tan inestable es el paso de texto libre y observa cómo se separan las dos intervenciones.
- Planificación estructurada — restringe el plan antes de que la decisión lo lea — y observa la gráfica.
- El puente: apunta la misma medición a cualquier endpoint compatible con OpenAI.
[EVIDENCE] El resultado que hizo que valiera la pena construir este laboratorio está en la celda 6, y no fue el que esperaba cuando escribí el esquema. El reintento nunca reduce el determinismo en ningún ajuste de este simulador — yo predije que sí, y el veredicto del notebook se calcula en tiempo real, no está escrito de antemano, precisamente para poder contradecirme, cosa que hizo. Lo que realmente ocurre es más sutil y útil:
| variación aguas arriba | línea base | reintento | ganancia del reintento | validación del plan |
|---|---|---|---|---|
| 0.00 | 0.885 | 1.000 | +0.115 | 0.885 |
| 0.25 | 0.680 | 0.815 | +0.135 | 0.870 |
| 0.50 | 0.480 | 0.665 | +0.185 | 0.860 |
| 0.75 | 0.340 | 0.440 | +0.100 | 0.875 |
| 1.00 | 0.260 | 0.290 | +0.030 | 0.865 |
El reintento gana sin discusión cuando el paso anterior ya es estable, y su ventaja desaparece justo cuando el problema se pone difícil. La validación del plan es constante en toda la serie de pruebas, porque elimina la causa en vez de solo amortiguar el síntoma. Esa es la diferencia entre una solución estructural y un remedio temporal — y pasa completamente desapercibida si solo mides en un único escenario, que es lo que hace casi todo el mundo.
[DISEÑO] Por qué usar un stub y no un modelo real. Los laboratorios de la Temporada 1 son explícitamente mecanismo-primero y "do not pretend a four-action bandit is an LLM" (Traducción: no finjas que un bandido de cuatro acciones es un LLM). Un simulador reproduce dónde entra la variabilidad y qué la elimina en segundos, gratis y sin clave de acceso. no reproduce magnitudes. Nada de lo que imprime el notebook sirve como evidencia para el 1.000-a-N=100 de Dhage; eso se midió en modelos reales y solo el paper puede citarse por ello. La celda 8 es el puente honesto: configuras dos variables de entorno y el mismo código de medición corre contra un endpoint real. La medición no cambia. Solo cambia el trabajador.
Proyectos
Dos implementaciones, desde cero. Sin frameworks ni dependencias fuera de la biblioteca estándar. Ambas parten de la misma idea, pero apuntan a consecuencias muy distintas — y ambas se ejecutaron antes de escribir esta sección, así que cada número de abajo es medido, no predicho.
Proyecto 1 — vida cotidiana:the-grocery-slip
projects/01-real-grocery-slip/ · python3 measure.py 20
Un generador semanal de lista de compras a partir de un menú. Nadie pensaría en escribir una especificación para esto, y por eso es el primer experimento ideal: descubres que tus aserciones están incompletas en algo donde equivocarte no cuesta nada.
prompt version : slip-v4
conformance    : 0.700   (14/20 passed every assertion)
reproducibility: 0.450   (identical output share)
[EVIDENCIA] Tres cosas fallaron, y el README registra cada una antes de corregirla.
Ejecución 1 — mi bug, no del modelo. La conformidad fue 0.000. Todas las ejecuciones fallaron. La especificación decía 0 < qty <= 20 por cada unidad y la lista contenía 500 g de zanahorias. El límite no era demasiado estricto; se aplicó en la granularidad equivocada — "una familia por una semana" son 5000 en gramos y 20 en manojos, y un solo número para ambos es un error de categoría disfrazado de restricción. Corregirlo llevó la conformidad a 0.700. Lo primero que me enseñó una especificación medida fue que la propia especificación estaba equivocada, que es lo habitual y la razón para ejecutar veinte veces antes de confiar en cualquier resultado.
Ejecución 7 — el hueco que este proyecto existe para que lo encuentres. La lista incluía milk y Milk, en dos pasillos distintos, y todas las comprobaciones pasaron. Cada artículo era válido por sí solo. La especificación revisaba los elementos, pero nunca la colección. Era completa sobre la unidad de análisis equivocada. Mi lista del súper pasó todas las pruebas menos la de hacer las compras.
Ejecución 11 — la tentación. El modelo generó una lista objetivamente mejor que la permitida por la especificación, y la tentación de relajar la comprobación para que esa ejecución pasara era fuerte. Si la especificación está mal, cámbiala de forma deliberada, en su propio commit y dejando constancia del motivo. Nunca la edites solo para que pase una salida que te gustó.
Proyecto 2 — empresa:the-change-ticket
projects/01-enterprise-change-ticket/ · make compare · make gate
Un router de solicitudes de cambio ITSM: texto libre de entrada, decisión de enrutamiento estructurada de salida — nivel de riesgo, grupo aprobador, bandera de ventana de congelamiento. Seis tickets dorados, N=100 cada uno.
[EVIDENCIA] Solo cambió una variable:
                        WITHOUT plan gate      WITH plan gate
determinism                     0.510                 1.000
conformance                     1.000                 1.000
escalation_recall               1.000                 1.000
make gate con planificación estructurada sale 0.make gate al quitar la planificación estructurada sale 1. Ese es el titular del paper reproducido en otra tarea — y nota que la conformidad ya era 1.000 sin la intervención. Cada decisión individual era válida. Simplemente no eran la misma decisión dos veces, que es el modo de fallo que pasa todas las pruebas unitarias que tengas.
Constrúyelo en 30 minutos — el contrato
Todo lo que necesita el router, en el orden en que lo pedirá un ingeniero. Entradas: texto libre. Salida: un Decision. Invariante: no se toma ninguna decisión hasta que un plan haya pasado el esquema. Regla de paro: un plan rechazado escala; nunca se reintenta.
PLAN_SCHEMA = {                       # the "to taste" step, given a shape
  "strategy":   enum["standard","expedited","emergency","reject"],
  "risk_tier":  enum["low","medium","high"],
  "freeze_hit": bool,
  "confidence": number in [0, 1],
}
def route(ticket, prompt_version):
    plan = model.plan(ticket)               # free text → structured plan
    if not validates(plan, PLAN_SCHEMA):    # 1 check, before ANY tool runs
        return escalate(ticket, "plan_rejected", prompt_version)  # no retry
    if plan.confidence < 0.60:
        return escalate(ticket, "low_confidence", prompt_version) # refusal path
    return decide(plan, prompt_version)     # deterministic given the plan

# CI gate (make gate): N=100 per golden ticket
#   determinism       == 1.000   (Decision.key() excludes decided_at)
#   conformance       == 1.000
#   escalation_recall == 1.000   (under-specified tickets escalate in ALL 100)
# any line below threshold → exit 1 → the build fails
Lo que falta deliberadamente en ese bloque: reintentos sobre un plan rechazado (vuelven a sacar la decisión), una marca de tiempo en la clave de comparación (haría cada ejecución única), y un modelo real (cambia model.plan para cualquier endpoint; el código de medición no cambia).
[DISEÑO] Cuatro características hacen que esto tenga perfil empresarial y no sea solo una demo, y cada una está ahí por una razón:
- Planificación estructurada antes de cualquier acción. El plan es una selección entre cuatro estrategias de enrutamiento aprobadas, validada antes de tomar la decisión. Validarlo después solo deja el registro más ordenado.
- Sin reintentos ante un plan rechazado. Un reintento es una nueva muestra; vuelve a generar el plan, lo que implica una nueva decisión. Rechazar significa escalar, no volver a intentar — y el experimento del notebook lo demuestra: el beneficio del reintento cae a +0.030 justo cuando el problema se complica.
- Una ruta de rechazo aplicada como invariante. Dos tickets dorados están deliberadamente subespecificados. Si la confianza baja de 0.60, la única salida legal es escalar a una persona designada, y
escalation_recallse exige en 1.000, requiriendo que la escalada sea unánime en las 100 ejecuciones, no solo habitual. - La versión del prompt registrada en cada fila de decisión. Un auditor que pregunte por qué el #4471 fue dirigido a plataforma en marzo necesita una respuesta reconstruible; por eso el prompt forma parte de la trazabilidad de auditoría y se convierte en un artefacto versionado — la tesis de este episodio, vista desde el ángulo de cumplimiento.
[DISEÑO] Una decisión que vale la pena debatir. Decision.key() excluye deliberadamente decided_at: una marca de tiempo es información de procedencia, no una decisión, e incluirla haría que cada ejecución fuera trivialmente única y que la métrica de determinismo quedaría permanentemente en 1/N. Cada número de determinismo tiene una decisión así detrás. Si no puedes decir qué excluye tu clave de comparación y por qué, no estás midiendo lo que crees.
[ABIERTO] Lo que ninguno de los proyectos demuestra. Ambos conjuntos dorados son sintéticos y ambos workers son stubs por defecto. El estado honesto del build empresarial es ejecutable y controlado, no desplegado y medido. ¿Qué lo haría real? Un set dorado tomado de tickets históricos con sus rutas reales, y una tasa de acuerdo reportada junto al determinismo — porque el determinismo sin acuerdo es solo un router que se equivoca siempre igual.
La misma historia, cinco caminos
Un solo eje central, luego una puerta para cada tipo de lector. Elige una decisión y una acción; deja el resto.
| Si eres | La decisión que este episodio cambia | Una acción para esta semana |
|---|---|---|
| un estudiante de preparatoria | "Ingeniería de prompts" es escribir una receta verificable, no buscar palabras mágicas. | Corre el laboratorio en Colab (15 segundos, sin clave) y cuéntale la escalera de la cocina a un amigo. |
| un ingeniero de IA | El determinismo viene de moldear ese único paso de texto libre, no de agregar más capas. | Implementa el contrato de arriba con un prompt tuyo; ponle control en N=20. |
| un fundador | Un demo que responde diferente dos veces no es un producto; el arreglo es barato y medible. | Pídele a tu equipo el número de reproducibilidad de tu prompt principal. Si nadie lo tiene, ahí está el hallazgo. |
| un ejecutivo | La confiabilidad es una pregunta de auditoría: ¿qué versión del prompt tomó esta decisión, y se repite? | Agrega "versión del prompt registrada en cada fila de decisión" a la próxima revisión de arquitectura. |
| un inversionista | La ventaja competitiva está en especificaciones medidas y controladas, no en el modelo que renta un equipo. | Pídele a cualquier startup de agentes el determinismo y éxito de tarea, uno al lado del otro. Uno sin el otro es puro teatro. |
Misión en el mundo real
Quince minutos, usando algo que ya ejecutas esta semana.
- Elige un prompt del que realmente dependas — uno real, en una herramienta o flujo que uses de verdad.
- Antes de ver cualquier resultado, anota qué condiciones debe cumplir la salida. Campos, tipos, valores permitidos, límites de longitud. Intenta llegar a diez afirmaciones. Te costará mucho más de lo que imaginas, y esa dificultad es justo el hallazgo.
- Ejecuta 20 veces. Cuenta cuántas afirmaciones fallan. Anota ese número.
- Ubica el único punto en tu pipeline que sigue generando texto libre sin restricciones — tu propio "season to taste". Casi siempre hay exactamente uno, y casi nunca está donde crees.
- Ponle un esquema a ese paso. Ejecuta otras 20 veces. Compara.
Si el paso 4 no arroja nada porque tu pipeline es solo una llamada sin paso de planificación, has aprendido algo aún más útil: todavía no estás en esta escalera, y el próximo episodio es para ti.
Reto de investigación
Entrégale esto a un agente y deja registrada tu predicción antes de ejecutarlo — un resultado que no anticipaste es uno que tenderás a racionalizar después.
Replica la estructura de arXiv:2608.26197 a pequeña escala. Elige una tarea con una salida verificable. Establece una Tasa de Reproducibilidad y un Índice de Determinismo de referencia sobre N=100 con parámetros fijos. Luego aplica exactamente una intervención a la vez, en orden aleatorio: (a) validar con esquema el paso de planificación, (b) forzar la selección de herramienta, (c) limitar los reintentos, (d) añadir validación de salida. Reporta el efecto marginal de cada una tanto en determinismo como en éxito de la tarea, además del costo en tokens y la latencia.
Deja registrada tu predicción: ¿qué intervención única explica la mayor parte del efecto, y si la latencia se mueve en la misma dirección para dos modelos distintos?
La respuesta del propio paper es que la planificación estructurada es la clave, y que la latencia varía según el modelo — uno se vuelve más rápido, el otro notablemente más lento. Haz tu predicción antes de comprobar. Si obtienes un orden distinto en tu tarea, eso es un desacuerdo publicable con un paper de hace tres semanas, no un bug en tu configuración.
Qué ha cambiado
Estado de este peldaño al momento de publicación. Generado a partir de una sincronización semanal en vivo de 30 fuentes pioneras en research-anything (make watch-sync), clasificadas por señal técnica y nunca por alcance de audiencia.
Fecha de sincronización: 2026-09-03.
- arXiv:2608.26197 (2026-08-25) — el estudio empírico sobre el que se construye este episodio. Tres semanas desde su publicación.
- arXiv:2608.21156v2 (revisado 2026-08-26) — la encuesta que define la escalera de cinco niveles, incluyendo el nivel de ingeniería de contexto que la lista popular de cuatro etiquetas omite.
- Simon Willison (2026-09-02) — El nuevo system prompt de Claude realmente no quiere reproducir letras de canciones: los system prompts siguen siendo los artefactos más consultados y menos versionados de la industria.
- Más antiguos pero fundamentales: arXiv:2401.14423 Diseño e ingeniería de prompts; arXiv:2503.02400 Ingeniería de promptware; de Lilian Weng, Ingeniería de prompts (2023-03-15), sigue siendo la referencia más clara sobre las técnicas de este nivel.
[OPEN] Lo que no ha cambiado: nadie ha publicado una réplica de arXiv:2608.26197. Un resultado de autor único y un solo artículo sobre dos tareas sintéticas es toda la base empírica para la afirmación central de este episodio, y debe leerse así hasta que alguien lo replique.
Test de salida
Pon a prueba tu memoria sin mirar hacia arriba.
- Nombra los cinco niveles publicados en orden, y di cuál deja fuera la lista popular de cuatro etiquetas.
- ¿Cuál es la diferencia entre Tasa de Reproducibilidad e Índice de Determinismo, y por qué un sistema puede marcar 1.000 en ambos y aun así ser inútil?
- En arXiv:2608.26197, un primer intento de harness empeoró la reproducibilidad peor en cuántas de las cuatro celdas — y ¿qué único cambio lo solucionó?
- ¿Por qué el notebook usa un stub en vez de un modelo real, y qué es lo que ese stub no te permite afirmar?
- Te dicen que una pipeline es completamente determinista porque la temperatura está en 0. Da tres razones por las que eso no es cierto.
Cliffhanger
Escribes la receta perfecta.
Cada cantidad está acotada y comprobable. Cada motivo está explicado, no solo cada regla. El único "al gusto" se reemplazó por un número. La ejecutas cien veces y la Tasa de Reproducibilidad marca 1.000, y por una tarde crees que has resuelto la cocina.
Luego le das la misma tarjeta al mismo cocinero, pero un viernes por la noche en vez de un martes por la mañana.
Obtienes un plato distinto.
Nada en la tarjeta cambió. Nada del cocinero cambió. Lo que cambió fue lo que había sobre la mesa de trabajo cuando se cocinó — la salsa a medio usar de la noche anterior, el pedido de otra mesa todavía prendido en el riel, un frasco que alguien dejó abierto junto a la sal.
La tarjeta nunca fue lo único en la cocina.
Episodio 2 — La Despensa. El peldaño que la lista de cuatro etiquetas omite, el que la escalera publicada pone en segundo lugar, y donde vive el fallo más costoso de los agentes en producción actualmente.
Lee también
Episodio 1 de Intelligence Engineering Adventures, Temporada 7 — La Escalera de la Cocina. Las afirmaciones en la fuente de la serie están clasificadas por tipo — definición, derivación, evidencia, decisión de ingeniería, pregunta abierta — y una metáfora puede introducir una idea, pero nunca sirve como prueba de nada. Cada episodio incluye un notebook de Colab que corre en el nivel gratuito, sin clave de API, más dos aplicaciones construidas desde cero: una personal y otra con enfoque empresarial. La escalera es la de Feng et al. (arXiv:2608.21156), no es invención mía. La sección de "qué ha cambiado" se genera a partir de una sincronización semanal en vivo de 30 fuentes pioneras, ordenadas por señal técnica y nunca por alcance de audiencia. Este artículo no contiene material de ningún empleador ni cliente. — Paul Jialiang Wu · futuremake.io
Referencias
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. (2026). Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2, revisado 2026-08-26. — la escalera de cinco niveles, citada textualmente en "La escalera no es mía".
- Dhage, S. (2026). Harness Engineering for Predictable Agentic Systems: An Empirical Study of Deterministic Execution Constraints. arXiv:2608.26197, 2026-08-25. — el resultado 1-de-4 / 2-de-4 en el primer intento, el diagnóstico a nivel de trazas y Structured Planning alcanzando 1.000 en N=100 en tres de cuatro celdas.
- Chen, B., Zhang, Z., Langrené, N. et al. (2023). Unleashing the potential of prompt engineering for large language models. arXiv:2310.14735. — revisión de técnicas.
- Amatriain, X. (2024). Prompt Design and Engineering: Introduction and Advanced Methods. arXiv:2401.14423.
- Chen, Z., Wang, C. et al. (2025). Promptware Engineering: Software Engineering for Prompt-Enabled Systems. arXiv:2503.02400. — el argumento completo de "un prompt es un artefacto de software".
- Weng, L. (2023). Prompt Engineering. lilianweng.github.io, 2023-03-15. — y observa que la misma autora escribió Harness Engineering for Self-Improvement (2026-07-04): un solo autor, tres niveles, siete años.
- Willison, S. (2026-09-02). Claude's new system prompt really doesn't want to reproduce song lyrics. simonwillison.net.
- Brown, T. B., Mann, B. et al. (2020). Language Models are Few-Shot Learners. arXiv:2005.14165. — el hito de 2020 en la tabla histórica.
- Reynolds, L., McDonell, K. (2021). Prompt Programming for Large Language Models: Beyond the Few-Shot Paradigm. arXiv:2102.07350.
- Liu, P., Yuan, W. et al. (2021). Pre-train, Prompt, and Predict: A Systematic Survey of Prompting Methods in Natural Language Processing. arXiv:2107.13586.
- Wei, J., Wang, X. et al. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. arXiv:2201.11903.
- Wang, X., Wei, J. et al. (2022). Self-Consistency Improves Chain of Thought Reasoning in Language Models. arXiv:2203.11171.
- Kojima, T., Gu, S. S. et al. (2022). Large Language Models are Zero-Shot Reasoners. arXiv:2205.11916.
- Willison, S. (2022-09-12). Prompt injection attacks against GPT-3. simonwillison.net.
- Khattab, O., Singhvi, A. et al. (2023). DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines. arXiv:2310.03714.
- Shinn, N., Cassano, F. et al. (2023). Reflexion: Agentes de lenguaje con aprendizaje por refuerzo verbal. arXiv:2303.11366. — referente de ingeniería de bucles en la tabla de la serie.
- Wu, Q., Bansal, G. et al. (2023). AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation. arXiv:2308.08155. — referente de ingeniería de grafos en la tabla de la serie; LangGraph: github.com/langchain-ai/langgraph.
- Anthropic (2024-12-19). Building Effective AI Agents. anthropic.com/engineering. — referente de ingeniería de harness en la tabla de la serie.
- Anthropic (2025-09-29). Effective context engineering for AI agents. anthropic.com/engineering. — referente de ingeniería de contexto en la tabla de la serie.
- Guías de ingeniería de prompts descritas (no citadas textualmente) en la tabla histórica: Anthropic · OpenAI.
- Liang, P., Bommasani, R. et al. (2022). Evaluación holística de modelos de lenguaje. arXiv:2211.09110. — referencia clave de ingeniería de evaluación en la tabla de la serie.
- Zheng, L., Chiang, W.-L. et al. (2023). Evaluando LLM-as-a-Judge con MT-Bench y Chatbot Arena. arXiv:2306.05685. — referencia clave de ingeniería de evaluación en la tabla de la serie.
- Kapoor, S., Stroebl, B. et al. (2024). Agentes de IA que importan. arXiv:2407.01502. — referencia clave de ingeniería de evaluación en la tabla de la serie.
- Intelligence Engineering Adventures, Temporada 6 — The Governor Engine, episodios 1 y 3, para el argumento de que el diagrama de anidamiento no sobrevive al contacto y que ninguna etiqueta aquí puede expresar estabilidad.