AI-Nativeシリーズ · エージェントエンジニアリング比較:プロンプト · コンテキスト · ハーネス · ループ · グラフ
コンテキストエンジニアリングは「予算」であり、単なる「ウィンドウ拡張」ではない
第2回(全6回)このシリーズでは、AIエージェントの設計手法──プロンプト、コンテキスト、ハーネス、ループ、グラフエンジニアリング、そして今シーズンが新たに提唱する第六の評価エンジニアリング──を比較する。それぞれの起源、制御対象、主導するプレイヤー、測定で生き残った原則を問う。今回取り上げるのは、一般的な4分類リストが抜かしている「コンテキストエンジニアリング」と、「ウィンドウ」を広げても絶対に自動化できない2つの意思決定だ。
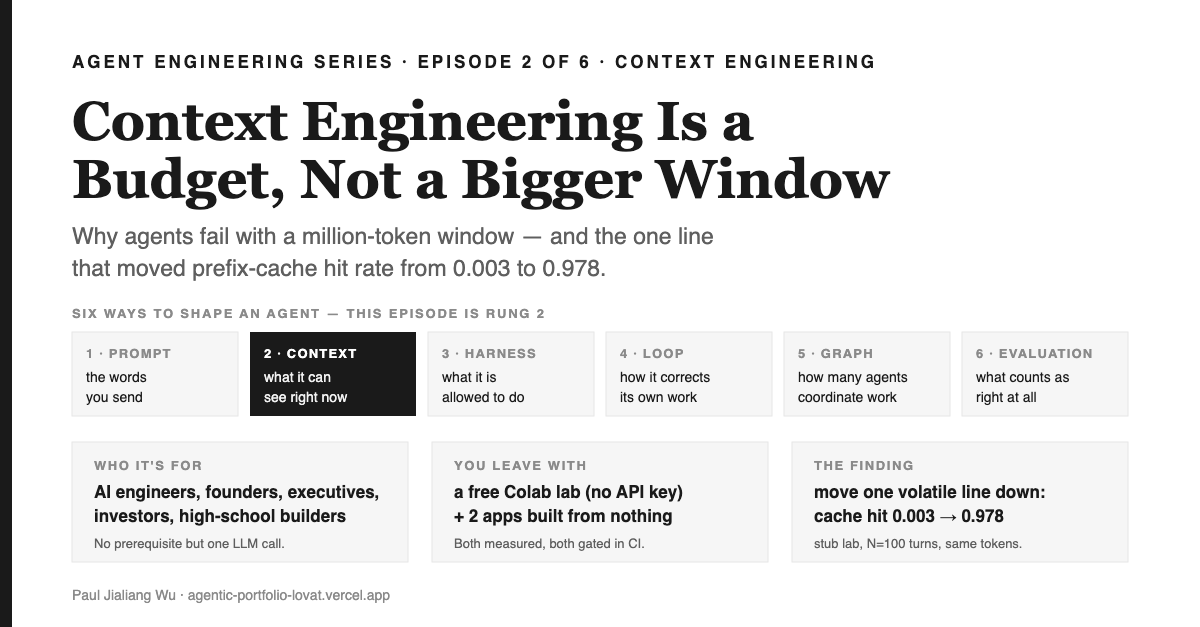
1分でつかむ要点──この記事で得られるもの
この記事についてAIエージェントの設計手法を比較するシリーズ──プロンプトエンジニアリング(送る言葉)、コンテキストエンジニアリング(AIが今まさに見ているもの)、ハーネスエンジニアリング(何を許可するか)、ループエンジニアリング(自分の出力をどう修正するか)、グラフエンジニアリング(複数のエージェントがどう連携するか)、評価エンジニアリング(何が「正しい」とみなされるか)。本エピソードでは、コンテキストエンジニアリングを取り上げる。2020年のリトリーバル拡張生成から2026年までの歴史、主導する人々、そして計測で生き残った原則を辿る。
なぜ重要なのか 毎月あなたに降りかかる2つのコスト、そのどちらもコンテキストエンジニアリングで決まる。ひとつはお金だ。プロダクションのエージェントは毎ターン履歴全体を再送するため、キャッシュされたプレフィックスが残るかどうかが推論コストの大半を占める。もうひとつは信頼。引退済みの方策から答えるエージェントは、自信満々に、しかも引用可能な形で間違いを返し、あなたのすべてのテストをパスする。どちらもウィンドウを大きくしても解決しない。2023年のStanford主導の研究では、答えがウィンドウ内のどこにあるかで精度が決まるとされ、2025年の18モデル横断レポートでは、入力が増えると単純なタスクでも性能が劣化することが示された。創業者にとっては、数セントのデモと数千ドルの製品の間に横たわるギャップだし、エンジニアにとっては今日中に出せる2つの修正である。
この記事を読んだあとにできること コンテキストにトークン予算を設け、プレフィックスキャッシュのヒット率を測り、揮発性のあるフィールドはすべてプレフィックスから外し、メモリストア内のすべての事実に有効期限スタンプを付けてリトリーバル時に弾けるようにする。無料で使えるColabノートブック(APIキー不要)と、ゼロから組み上げた2つの動くアプリが手に入る。ひとつは失効済み食材の混入率が0.750→0.000になるファミリー向け献立プランナー、もうひとつは予算超過・失効事実・不安定なプレフィックスでビルドが落ちるCIゲート付きのサポートデスク用コンテキストアセンブラだ。
Season 7 — シリーズの背骨
- プロンプトエンジニアリング——呪文ではなく仕様 第1話
- コンテキストエンジニアリング——予算で考える、ウィンドウを広げる話ではない この回
- ハーネスエンジニアリング――エンベロープであってエージェントそのものではない 第3話
- ループエンジニアリング——再試行ではなく外部の判定者 第4話
- グラフエンジニアリング —— 配役ではなくスケジュール 第5話
- 評価エンジニアリング——リーダーボードではなく「正しさ」を決める関数 第6話
今回の論点と、なぜコンテキストエンジニアリングが2番目なのか
AIエージェントを作るために名付けられた5つの分野があり、今シーズンはさらに6つ目を提案する。登場順はおおよそこうだ:プロンプトエンジニアリング(2020)、ループエンジニアリング(2022)、グラフエンジニアリング(2023)、ハーネスエンジニアリング(2024)、コンテキストエンジニアリング(2025)。評価エンジニアリングは実践としては古く、名前としては新しい。最も明確な定義はFengらのサーベイ(arXiv:2608.21156)にあり、年次順ではなく「何を制御できるか」で並べている:プロンプト→コンテキスト→ハーネス→ループ→グラフ。本シリーズはこの順に各エピソードで1つずつ取り上げ、毎回同じ4つの問い——どこから来たか、何を制御するか、誰が主導しているか、どんな失敗が次の段階を促すか——を問う。
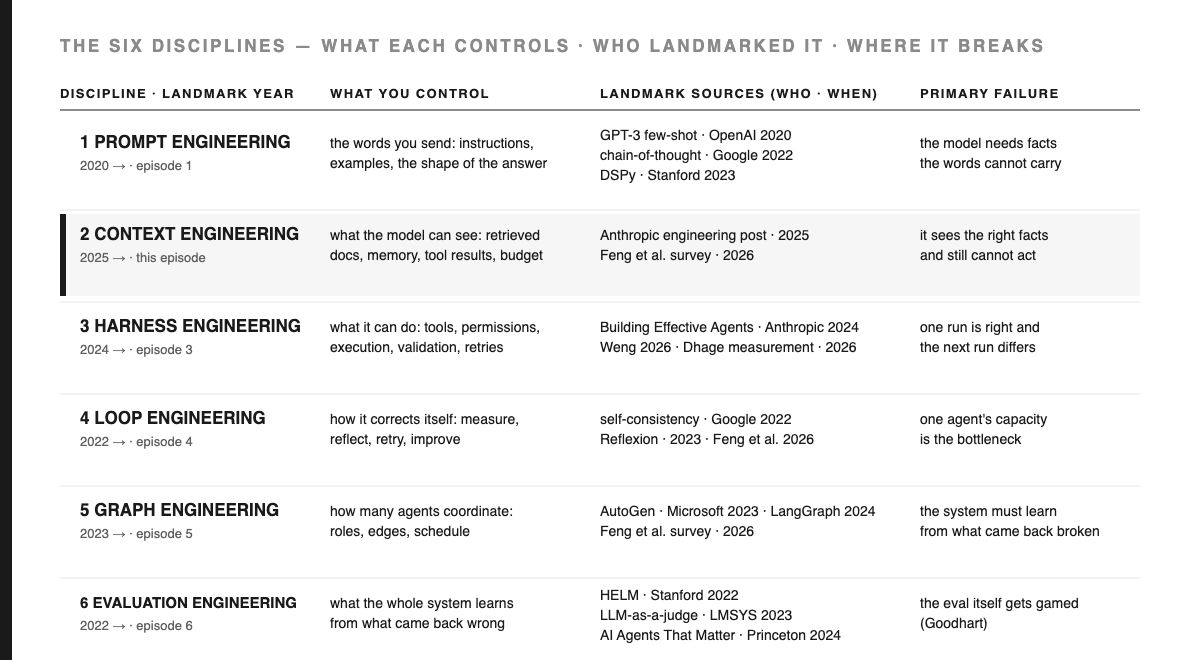
コンテキストエンジニアリングが二番目に位置する理由は、最初の段階——プロンプトエンジニアリング——が使い果たされる瞬間が必ず来るからだ。エピソード1の終わりでは、完璧なレシピカードから二つの異なる料理が生まれたが、その原因はカードの内容にはなかった。エージェントが送信した言葉の中にない事実——たとえば方策や価格、昨日の決定、直近のツールの出力——が必要になった時点で、もはやプロンプトの編集作業ではなくなる。そこから先は、限られたリソースを何に割り当てるかという意思決定になる。
この分野を読むべき人 デモでは正しく動くのに、三週目には高コスト化したり誤答が増えたりするエージェントを抱えるAIエンジニア。利用量よりも速いペースで推論コストが膨らむのを目の当たりにした創業者。「プロンプトにもっと貼ればいい」と思っていたのに、なぜそれが通用しなくなるのか知りたい高校生ビルダー。必要なのは、一度でも言語モデルを呼び出した経験だけだ。
コンテキストエンジニアリングの起源と担い手
[DEF] コンテキストとは、モデルが回答する瞬間に見えているすべて——システムプロンプト、ツール定義、これまでの会話、リトリーブされた情報、ツールの返却値——を指す。コンテキストエンジニアリングとは、そこに何を入れ、何を除外するかを決める技術領域だ。定義はこれに尽きる。歴史とは、リトリーバルの工夫がやがて「予算」という考え方に変わっていった過程そのものだ。
| 時系列 | 転換点 | 主導者 | 何が変わったか |
|---|---|---|---|
| 2020-05 | リトリーバル強化生成(arXiv:2005.11401) | Lewis ら、Facebook AI Research、UCL、NYU | 事実が重みから入力へと移り、モデルは生成時にインデックスから情報を読み出すようになった。「知識」は自分で組み立てるものになった。 |
| 2023-07 | Lost in the Middle (arXiv:2307.03172) | Liu ら、Stanford、Berkeley、Samaya AI | ウィンドウの中で情報の位置によって正確さが変わることが測定され、ウィンドウが一様ではないと判明した。位置がエンジニアリング上の変数となった。 |
| 2023-10 | MemGPT(arXiv:2310.08560) | Packer ら、UC Berkeley | OSの仮想メモリの発想を取り入れ、小さなウィンドウ内で事実をページイン・ページアウトする仕組みを導入。ウィンドウはもはや書類棚ではなくRAMとなった。 |
| 2025-06 | 用語の命名と普及(simonwillison.net) | Tobi Lütke, Shopify/Andrej Karpathy | この実践に定着した名前を与えたのは、二つの投稿である。「プロンプトエンジニアリング」という言葉が、世間では単なるチャットボットへの入力作業と化し、意味が崩壊していたためだ。 |
| 2025-07-02 | コンテキストエンジニアリング (langchain.com/blog) | LangChainチーム | 実践者が手を動かせる四つのカテゴリ──書く・選ぶ・圧縮する・分離する。実装まで伴った初の分類法だ。 |
| 2025-07-14 | コンテキストロット (research.trychroma.com) | Hong、Troynikov、Huber(Chroma) | 18モデルを対象に、タスクの複雑さは意図的に一定に保ち、入力長だけを変化させた。「100万トークン時代」の主張が、制御された実験で検証された。 |
| 2025-07-18 | Manus構築の現場から (manus.im/blog) | Yichao "Peak" Ji(Manus) | プロダクション現場の視点──KVキャッシュのヒット率がコストを決め、プレフィックスの安定性がそれを守る。 |
| 2025-09-29 | AIエージェントのための効果的なコンテキストエンジニアリング (anthropic.com/engineering) | Anthropic | モデルラボが「予算」フレームを明言した。有限なリソース=アテンション予算という考え方と、「最小かつ高シグナルな集合」を目指すという目標である。 |
| 2026-08 | ラダー調査(arXiv:2608.21156v2) | Fengら | コンテキストエンジニアリングはパラダイムラダーの2段目に位置づけられ、「情報アクセスの管理」と定義されている。 |
[DESIGN]注目すべき点が三つある。まず、実践自体は名前より5年早く始まっていた。2020年のRAGはすでにコンテキストエンジニアリングだったが、まだそう呼ばれていなかった。2025年にこの呼称を定着させたのは、論文ではなく、CEOと元ラボディレクターによるSNS投稿だった。旧ラベルが使い古されて意味を失っていたため、新しい名前が広まった。そして、ここで最も鋭い成果は、マーケティングの主張に真っ向から反論する計測データ──ベンダーが「ミリオントークンウィンドウ」を売り文句にしたその年、独立した2つの研究グループが「ウィンドウをいくら広げても、均等に使えるわけではない」とする実証結果を発表した。
今この分野を動かしているのは誰か モデルラボが指針を示し、キャッシュの挙動も彼らが握っている。エージェント製品チーム(Manusが最も分かりやすい公開例)は、運用コストを実際に支払う立場として、現場の数値を公開する。フレームワークベンダーは現場の知見をデフォルト設定に落とし込む。リトリーバル基盤企業は、逆張りの計測に資金を出す──リトリーバルを売る側こそ「ウィンドウに詰め込むだけでは代用にならない」ことを証明する強い動機があるからだ。アカデミアは基盤となる2つの計測のうち1つ(Liuら、StanfordとBerkeley)を担い、残りは産業界が担う──これがこの段の実態である。
シリーズ全体を貫く思考モデル──キッチンのはしご
全6回のエピソードを1枚の絵で表すなら、道具としてこの比喩をもう一度出しておく。料理人はみな同じはしごを登る。まず自分のため、次に家族のため、レストランの厨房、ファストフードチェーン、全国のサプライチェーン──その最上段にはリコールログがある。AIエンジニアも同じ構造を辿る。学校の学習者から最前線のリーダーまで、エージェントエンジニアリングの各段は、それぞれのキッチンに対応している。
エピソード1はレシピカードだった。あなたが書き、直接話せない料理人がその通りに料理を作る。すべては事前にカードに収めておく必要がある。第2段はパントリーとカウンターだ。 今やあなたは家族のために週に何度も料理をする。キッチンには物がどんどん溜まっていく。レシピカードも依然として重要だが、火曜から金曜の間にパントリーは充実し、カウンター──実際に料理が行われる小さな作業台──こそが、毎回の料理の成否を決める場所になる。
| 段 | キッチン | あなたの立場 | どこを自分で設計できるか |
|---|---|---|---|
| 1. プロンプト | レシピカード──自分のための料理 | 学校の学習者 | 料理人が参照する書かれた指示 |
| 2. コンテキスト | パントリーとカウンター──家族のための料理 | ジュニア開発者 | カウンターに出ているもの、その鮮度──作業中に何が使えるか |
| 3. ハーネス | レストランの厨房 | シニア開発者 | 各ステーション、手の届くツール、すべての皿をチェックするパス |
| 4. ループ | ファストフードチェーン | AIテックリード | 味見、計測、修正、全店舗へ修正を展開 |
| 5. グラフ | 全国規模のサプライチェーン | CTO | 複数のキッチン、ひとつのスケジュール、ひとつのトラック隊 |
| 6. 評価 | リコールログ | フロンティアリーダー | フードシステム全体が、戻ってきた失敗から学ぶこと |
パントリーは、自分が持っているすべて——棚、冷凍庫、冷蔵庫の奥まで含む。カウンターは、今まさに料理中に手の届く範囲に出ているものだ。この二つは別物であり、ここを取り違えるのが今回のテーマだ。瓶をたくさん持っていても、夕食が良くなるわけではない。夕食を決めるのは、カウンターに何が出ているか、そしてその中に傷んだものがないかどうか、である。
軸は一つではなく、二つある。 これは登りきって終わるはしごではない。どのキッチンにも常に六層すべてが同時に存在する。家庭の料理人にも、レシピカード、パントリー、コンロ、味見、仕入先、そして前回の失敗の記憶がある。上に行くほど、触れる層の数と、それぞれをどれだけ厳密に運用するかが変わる。最初は勘、次に計測、ゲート、そして自己修正へと進化する。サプライチェーン図だけ飾って消費期限管理のない全国チェーンは、すべての瓶に日付をつけている一軒の家庭キッチンより未熟だ。つまり、ディシプリンは「何を制御するか」というレイヤーであり、シニアリティは「どう運用するか」という成熟度である。「グラフ」が「ループ」より自動的に高度というわけではない。
このアナロジーは主張を導入するために使ってよいが、証拠として使うことは許されない。下の1:1技術マップで、すべての要素がコード上の何か一つに対応している。そして、エピソード1の終わりから残っているものが一つある。塩の隣に誰かが開けっぱなしで置いた瓶。 これを見失わないでほしい。約900ワード後、これが本当にお金を食うことになる。
このはしごは自分の発明ではない
[定義] 用語は出典に紐づけて示す。なぜなら、この領域には複数のラベルが競合しており、大半のリスト記事はセットを間違えているからだ。
このはしごについて最も明確に公表された定義はFengらのサーベイ(arXiv:2608.21156, 2026-08-26改訂)であり、この段を6語で定義している:「Context Engineering to manage information access」(訳:情報アクセスを管理するためのコンテキストエンジニアリング)"Context Engineering to manage information access"(訳:情報アクセスを管理するためのコンテキストエンジニアリング)——これは、モデルがすでに持つ能力を引き出すプロンプトエンジニアリングと、モデルがアクセスできる範囲を整理するハーネスエンジニアリングの間に位置づけられる。
まず実務家による定義が現れた。ShopifyのTobi Lütkeは2025年6月、こう述べている "the art of providing all the context for the task to be plausibly solvable by the LLM"(訳:タスクがLLMで現実的に解けるよう、すべてのコンテキストを用意する技術)。数日後にはAndrej Karpathyが、さらにこう補足した "the delicate art and science of filling the context window with just the right information for the next step"(訳:次のステップのために、コンテキストウィンドウにちょうど適切な情報だけを詰める繊細な技術と科学)。いずれも2025年6月27日付Simon Willisonのノートからの引用で、私が読んだ一次資料だ。
[DESIGN]三者に共通するのは「どれだけ多く入れるか」ではなく、「何をどう選ぶか」だ。Lütkeは「すべてのコンテキスト」と言い、Karpathyは「ちょうど適切な情報」と言い、Fengらは「アクセスを管理する」と述べている。誰も「もっと多く」とは言っていない。本来この分野はキュレーションの問題として名付けられたが、現場ではしばしば「とにかく詰め込む」問題として扱われている。この読み違いこそが、多くのエージェント運用コストの温床になっている。
この主張の位置づけ
[DEF] コンテキストは「コンテナ」ではなく「予算」だ。予算にはコンテナにない三つの特徴がある。有限であり、消費され、何に使うかを毎ターン自分で決める必要がある。そして「どこに置くか」というレイアウトも重要だ——この予算では、トークンの位置によってコストも読まれ方も変わる。
[EVIDENCE]まず「位置」から見ていこう。これはこの主張の中で最も古く、かつ多く測定されてきた部分だ。Liuらは同じ情報をウィンドウ内の異なる場所に配置し、精度を調べた:
"performance is often highest when relevant information occurs at the beginning or end of the input context, and significantly degrades when models must access relevant information in the middle of long contexts, even for explicitly long-context models"(訳:関連情報が入力コンテキストの最初または最後にある場合、パフォーマンスはしばしば最も高く、長いコンテキストの中央に関連情報がある場合、モデルはその情報にアクセスする際に著しく性能が低下する。これは明示的に長いコンテキストモデルでも同様である)
——Liuら、Lost in the Middle、arXiv:2307.03172
特に注目すべきは最後の一節だ:even for explicitly long-context models(訳:明示的に長いコンテキストモデルであっても)。ウィンドウを大きくしてもこれは解決しない。なぜなら、これはウィンドウ全体におけるアテンションの「形」に関する主張であり、単なるサイズの問題ではないからだ。(この論文は2024年TACLに掲載された。私は公開されたアブストラクトとarXiv版を比較し、一語一句同一であることを確認した。)
[EVIDENCE]今度はChromaの2025年技術レポートが、別の角度から同じ問題に切り込む。Lost in the Middleが位置を変数としたのに対し、Chromaは長さを変数とし、難易度を一定に保った。Lost in the Middle は、情報の位置を変えて測定し、Chromaはコンテキストの長さだけを変えて難易度を一定に保った。"Each task remains intentionally simple and is deliberately controlled to isolate the impact of context length alone."(訳:各タスクは意図的に単純なままに保たれ、コンテキスト長の影響だけを分離して測定できるよう厳密に制御されている。) 18モデルを横断した結果は、きわめて率直だ。"models do not use their context uniformly; instead, their performance grows increasingly unreliable as input length grows."(訳:モデルはコンテキストを一様に利用しているわけではなく、入力長が増すほどパフォーマンスはどんどん不安定になる。) Anthropicは自社のエンジニアリング記事でこの用語を採用し、本エピソードのタイトルとなった結論を導いた。"Context is a critical but finite resource for AI agents."(訳:コンテキストはAIエージェントにとって重要だが有限なリソースである。)
[EVIDENCE] ここからはコストの話に移る。普段はあまり注目されないが、毎月あなたのもとに請求として現れる部分だ。エージェントのループは毎ターン履歴全体を再送するため、入力と出力の比率はチャットボットとはまったく異なる。Manusによれば、その比率はおよそ100:1。結果、請求額を決めるのはたった一つの指標になる。
"If I had to choose just one metric, I'd argue that the KV-cache hit rate is the single most important metric for a production-stage AI agent."(訳:もし指標を一つだけ選ぶなら、プロダクション段階のAIエージェントにとってKVキャッシュヒット率こそが最重要だと私は主張する。)
— Yichao "Peak" Ji, Manus, 2025-07-18
しかも、この指標を壊すのは、あまりにも些細で一見良さそうな工夫だったりする。"A common mistake is including a timestamp—especially one precise to the second—at the beginning of the system prompt."(訳:よくあるミスは、特に秒単位で精密なタイムスタンプをシステムプロンプトの冒頭に含めてしまうことだ。) キャッシュはプレフィックスキャッシュだ。 リクエストが前回と先頭からどこまで一致しているか、その最長部分だけが再利用される。12番目のトークンを一つ変えれば、その後ろはすべて再度プリフィルされ、以降のすべてのターンで永遠にコストがかかる。
[DERIVATION] この三つを合わせると、ルールは「コンテキストを小さく保て」では終わらない。より本質的には、二つのルールに分かれる。
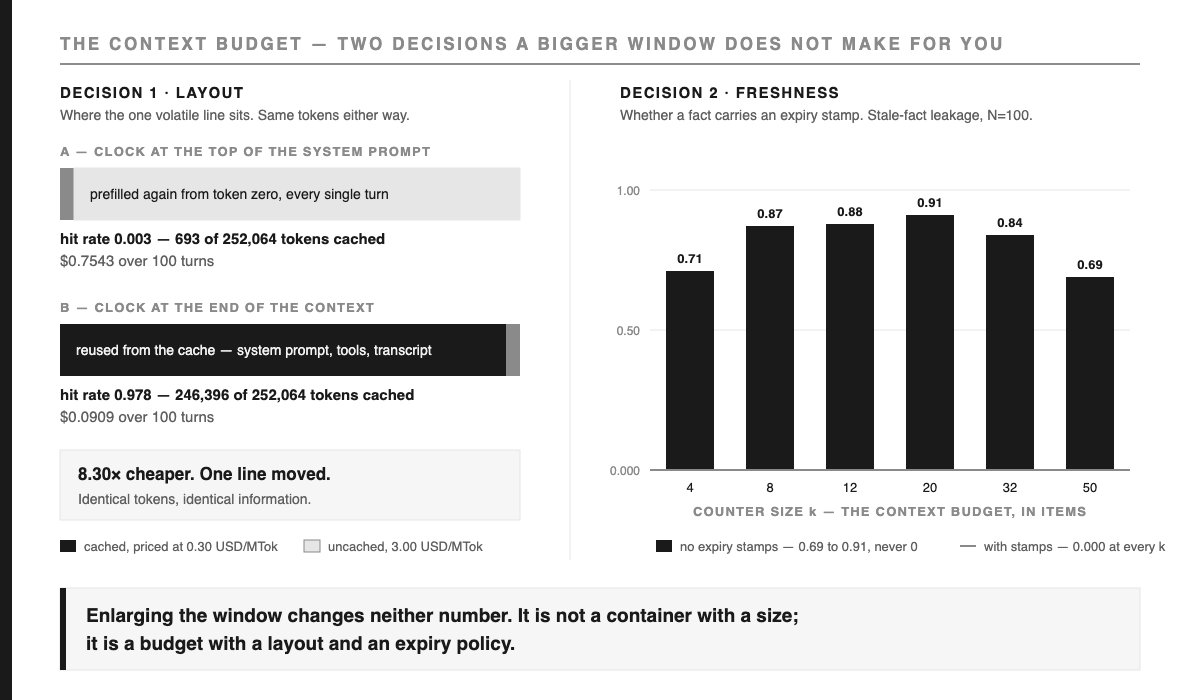
- レイアウトはコストの意思決定だ。 ターンごとに変わるものは必ずコンテキストの末尾に置き、決してプレフィックスには入れない。位置は見た目の問題ではなく、コストが発生する。
- 鮮度は正しさの意思決定だ。 日付がつけられない事実は拒否できない。メモリストアに有効期限や廃止フィールドがなければ、どれだけリトリーバの品質を上げても、引退済みの方策が引用されるのを防げない。古いかどうかはリトリーバからは見えない性質だからだ。
[DESIGN] ベンダー側の主張も、揶揄せず正面から聞く価値がある。長大なコンテキストのアナウンスは事実であり、単発タスク――この契約書を読め、この質問に答えろ――において100万トークンは2023年にはなかった本物の能力だ。ただし、そこから「キュレーションはもう不要だ」という推論は導けない。Chromaはまさにその推論を厳密な条件下で検証し、単純なタスクですら誤りであることを示した。そして請求額はどちらでも変わらない。ウィンドウを大きくしても、未整理のコンテキストが安くなることは一切ない。
[OPEN]率直に言って、限界が二つある。どちらの測定もリトリーバル型タスクに関するものであり、「推論型タスク」ではキュレーションが常に詰め込みに勝るとは限らないことを示しているわけではない。そしてキャッシュのコスト構造はプロバイダーごとに異なる。Manusがあるモデルファミリーについて挙げている「キャッシュ済みと未キャッシュ入力で10倍の差がある」という数字も、特定時点のリスト価格にすぎず、普遍的な法則ではない。自分の使うプロバイダーで再計算してから、私の算数を引用してほしい。
1:1 技術マッピング
このメタファーの各要素は、コード上で指し示せる具体的な一箇所に対応している。メタファーは主張を導入するためのものであって、証拠にはならない——だからここでは、装飾を一切省いた対応表を示す。
| キッチン | システム | どこに存在するか |
|---|---|---|
| パントリー——自分が持っているものすべて | コーパスとメモリストア | インデックス、ファイル、チケット履歴 |
| カウンター——今まさに調理中に出ているもの | このターンで組み立てたコンテキスト | messages[] 実際に送った内容 |
| カウンターの長さ | コンテキスト予算 | MAX_CONTEXT_TOKENS(自分で決める数値) |
| パントリーから何を出すか決めること | リトリーバル→フィルタリング→パッキング | score → filter → pack(この順番) |
| 瓶の消費期限 | 有効期限または後継バージョンのスタンプ | expires, superseded_by |
| 誰かが塩の隣に開けたまま放置した瓶 | まだコンテキストに残っている失効事実 | モデルが引用する退役済みポリシークローズ |
| 決して動かさないミザンプラス | 固定されたプレフィックス | システムプロンプト+ツールスキーマ(バイト単位で完全一致) |
| 調理台の上に打ち付けられた時計 | プレフィックス内の変動フィールド | 秒単位まで刻まれたタイムスタンプ |
| どうしても手が届かない棚 | 長いウィンドウの中央部 | 「Lost in the Middle」で測定された領域Lost in the Middleで測定される範囲 |
| コースごとにカウンターを片付けること | 復元可能な圧縮 | ページ本文を捨ててURLだけ残す |
| チケットに書いてクリップで留める | 外部化されたメモリ | エージェントが書き込み・読み出しするファイル |
[定義] このエピソードで拠り所となる三つの指標を、ここで一度だけ定義しておく。
- プレフィックスキャッシュ・ヒット率 — 一連の実行で、キャッシュから供給された入力トークンの割合(プリフィル分を除く)。品質は問わない。単純に「すでに支払い済みのトークンがどれだけ含まれていたか」。
- 失効事実の混入率 — N回の回答のうち、すでに期限切れまたは置き換え済みの事実を少なくとも1つ使った割合。流暢さは関係ない。どれだけ美しい回答でも、退役済みの条項を引用していればカウントされる。
- 予算超過 ——N回のアセンブルのうち、宣言したトークン予算を超えた回数。ここで「劣化」とは違う。予算オーバーのコンテキストは、あなた以外の誰か(プロバイダー)が、好きな端から勝手に切り詰める。
予測ゲート
スクロールする前に、必ず自分の答えを書き出してほしい。記録しなかった予測は、後から「当たっていた」と思い込む罠になる。
Q1. エージェントが100ターン動く。システムプロンプトの冒頭に現在時刻(秒単位)が入っている。他はすべて追記式。このとき、入力トークンのうち何割がプレフィックスキャッシュから供給されるだろう?
Q2. その1行をシステムプロンプトの冒頭から、モデルが回答する直前の最後の行に移す。同じトークン、同じ情報。ヒット率と請求額はどう変わる?
Q3. メモリストアに有効期限フィールドがなく、約4分の1が失効している。古い事実が回答に混入する頻度を減らしたい。効果が大きい順に並べよ:(a)コンテキスト予算を2倍にする、(b)リトリーバーのランキング精度を上げる、(c)有効期限フィールドを追加し、スコアリング前にそれでフィルタする。
答えはFailure RoomとNotebookにある。Q3で(b)を選んだなら、あなたは良い仲間だし、セル6のスイープは15分かける価値がある。
Failure Room(失敗実験室)
意図的に壊してみよう。壊せない仕組みは、仕組みではなく単なる主張にすぎない。
Failure 1 — "the window is a million tokens now, so this is solved."(訳:「ウィンドウが100万トークンになったから、もう解決だ。」) この段で最もよくある誤解であり、しかも最も多く反証が出ている。Chromaは難易度を一定に保ち、入力長だけを18モデルで変えたが、性能はやはり劣化した。Liuらは長さを固定し、位置だけを変えたが、精度はやはり動いた(長大なコンテキストモデルも含む)。カウンターを大きくするのは確かに有用だが、どちらの結果も変わらない。そして今回測る2つの数値にも全く影響しない。
Failure 2 — "we have caching enabled, so we're fine."(訳:「キャッシュを有効にしてるから大丈夫。」) キャッシュは単なるチェックボックスではなく、プレフィックスの性質そのものだ。そして、見た目は良さそうなエンジニアリングで簡単に壊れる。モデルに時刻を知らせるためのタイムスタンプ。トレース用のセッションID。ペルソナ適応用の「user tier: pro」行。JSONシリアライザがキー順を保証しないためにツールリストの順序が毎回変わる。どれも冒頭の1トークンであり、その後ろのすべてのトークンにコストがかかる。下のラボでは、このミスでヒット率が0.003まで落ちる。エラーも警告も出ず、本来検知すべきダッシュボードも誰も作っていなかった。
Failure 3 — "retrieve better."(訳:「もっと良いリトリーバーを使えばいい。」) このスイープが仕掛ける罠。ランキング精度を上げても、古いアイテムが先に来るだけで、到達自体は防げない。なぜなら、日付が見えないリトリーバーには古さが見えないからだ。ラボでは、有効期限スタンプなしのリーケージはカウンターサイズ4〜50で0.690〜0.910の間を推移し、一度もゼロにならない。スタンプありなら常に0.000。これは「より良いリトリーバー」ではなく、「リトリーバーの前に別の問いを立てた」だけだ。
Failure 4 — the metric that reads 0.000 and means nothing.(訳:「0.000と表示されるが、何の意味もない指標。」) リーケージをゼロにする最も安上がりな方法は、ほとんど何もコンテキストに入れないことだ。おめでとう、あなたのエージェントは確実に無知になった。これはエピソード1の決定性メトリックが空オブジェクトで1.000になるのと同じ構造であり、fridge-listプロジェクトがリーケージ率の隣に実際に何個の材料をプランに入れたかを報告している理由でもある。キュレーション指標に有用性指標が並んでいなければ、それはズルの誘いだ。
Q3の答え: (c)、次に(b)、最後に(a)。しかも(a)は単に最下位というだけでなく、むしろ逆効果ですらある。予算をk=4からk=20に上げると、カウンター上の失効アイテム平均数は1.08から9.25に増えた。たった一度の倍増(k=4→k=8)でも1.08から2.90に。問題を薄めたのではなく、むしろ招き入れただけだ。
Notebook(ノートブック)
Lab 02 — プレフィックスの安定性と予算 
labs/02_context_budget.ipynb · Colab無料枠 · APIキー不要 · CPU約2秒 · 全セル公開前に実行済み · 要点まとめ には両プロジェクトの内容も含まれている。
全7セルを2つのパートに分けている。前半はスタブのトークナイザー(4文字で1トークン換算)と、唯一重要なキャッシュモデル——KVキャッシュは、今回と前回のリクエストで最長一致するプレフィックス部分に対して再利用される。後半はパントリー用のファイル、アセンブラー、そしてリーケージ(失効事実の混入)を測る指標だ。
- トークナイザーとプレフィックスキャッシュモデルは、公開されているリスト価格をコスト計算に使っている。
- エージェントのコンテキストは2パターンで組み立てる。ひとつはシステムプロンプトの冒頭に時計を置く方法、もうひとつは同じ時計を回答直前の末尾に置く方法だ。
- N=100ターン分の計測結果。 まずトークン数の列に注目してほしい。どちらのパターンでも同じ値になっている。
- パントリーには40個のアイテムがあり、そのうち11個はすでに失効している。それぞれに
added日付、さらに必要に応じてexpires日付が付与されている。 - アセンブラーとリーケージ指標。カウンターサイズは12。
- スイープ、そして必ず盗みたくなるセル。カウンターサイズを変えてみると、2つの対策の効果がはっきり分かれる。
- ブリッジ:2つの関数を差し替えるだけで、同じ計測が実際のエンドポイントでもそのまま動く。
[EVIDENCE] セル3、実行結果そのまま:
arrangement                        input tok    cached  hit rate   cost USD
volatile field at the TOP            252,064       693     0.003     0.7543
volatile field at the END            252,064   246,396     0.978     0.0909

cost ratio (top / end)          : 8.30x
cost delta over 100 turns       : $0.6634
トークン数も、モデルが回答時点で参照できる情報も同じ。ただ1行を先頭から末尾に移しただけで、入力コストが8.3倍も消える。ここで注目すべきは、エラーも警告も出ず、出力品質も一切落ちないことだ。高コスト版も完璧に動作する——だからこそコードレビューでも見逃される。
[EVIDENCE] セル6は、アウトライン執筆中に自分の考えを覆されたセルだ。結論は事前に決めず、実行時に計算させていたので、私の主張と矛盾する結果が出て一度は削除しかけた:
| カウンターサイズ k | リーケージ:日付なし | リーケージ:日付あり | カウンター上の平均失効アイテム数 |
|---|---|---|---|
| 4 | 0.710 | 0.000 | 1.08 |
| 8 | 0.870 | 0.000 | 2.90 |
| 12 | 0.880 | 0.000 | 4.98 |
| 20 | 0.910 | 0.000 | 9.25 |
| 32 | 0.840 | 0.000 | 11.00 |
| 50 | 0.690 | 0.000 | 11.00 |
[OPEN] この表を素直に読むと、私の主張に反する部分も含めて、重要なことが見えてくる。スタンプなしのリーケージ率はkに対して単調増加ではなく、k=20で0.910まで上がり、k=50で0.690まで下がる。最初はこの最後の2行を削ろうかと考えたが、それは自分に都合よく切り取ることになる。理由はこうだ。パントリーには40品目あり、そのうち11が失効済み。k=32になると失効品はすべてカウンターに並び、4列目は11.00で固定される。そこからkをさらに増やしても新しい(新鮮な)品目しか追加されず、スタブのコックは常に4つだけを選ぶ。1回答あたりのリーケージ率は薄まるが、カウンターの汚染は完全に進行している。これはスタブ特有の現象だが、現実のレポートエラーの典型例でもある。つまり、表面上の率は改善しても、実態は悪化している場合があるということだ。ここで残る主張は、列全体が支持するものだけ——スタンプがなければ、どんな予算でもリーケージはゼロにならない。スタンプがあれば、どんな場合も0.000である。
[DESIGN] なぜスタブを使うのか。シミュレータなら、コストがどこで発生し、何がそれを除去するかを2秒で、無料かつAPIキー不要で再現できる。ただし、絶対値は再現しない。ノートブックが出力する数値は、Liuらの位置効果やChromaの劣化カーブの証拠にはならない——それらは元論文だけが証拠となる。8.30倍という値は、スタブトークンに公開リスト価格を掛け算した算術結果であり、比率が発見で、ドル額は単なる例示だ。セル7が正直な橋渡しで、トークナイザとスタブコックを入れ替えても、計測コードは変わらない。
プロジェクト
ゼロから2つ作った。フレームワークも標準ライブラリ以外の依存もなし。どちらもこのセクションを書く前に実行済みなので、以下の数字はすべて予測ではなく実測値だ。
プロジェクト1 — 実生活編:the-fridge-list
projects/02-real-fridge-list/ · python3 fridge_list.py 100
家族の食事プランナー。コンテキストは1ファイルだけ、pantry.json。パントリーを読み、カウンターに12品目を並べ、見えているもので1週間の夕食を組み立てる。自分用のテキストファイルに賞味期限を書く人はいない。だからこそ、これが最初のビルドにふさわしい。パントリーファイルもスタブコックもラボのものとは異なるが、構造は同じなのでリーケージ率はラボの0.880とは異なる。
pantry: 40 items, 11 already expired on 2026-09-11 · N=100 weekly plans · k=12

pantry file                   leakage rate   stale items named   of items named
WITHOUT expiry stamps                0.750                 134              242
WITH expiry stamps                   0.000                   0              372
[EVIDENCE] プランの4分の3は、すでに傷んだ食材で料理するよう家族に指示している。プラン自体は流暢で理にかなっているが、間違っている。予想外だったのは最後の数字だ。スタンプを付けると、プランナーが挙げる食材数は372対242で、減るどころか増えた。
この事実は、多くの人がこの作業を省略したくなる直感をひっくり返す。フィルタリングはカウンターを小さくしなかった。カウンターはどちらも12品目だ。使えない5枠を、すべて使える12枠に置き換えたことで、作れる食事が増えた。キュレーションは引き算ではない。 これは、同じ予算を「使えるもの」に使い直しただけだ——Anthropicの「高シグナルトークン」論が、ここでは冷蔵庫からやってきた。
プロジェクト2 — エンタープライズ編:the-desk-memory
projects/02-enterprise-desk-memory/ · make measure · make gate
サポートデスク用のコンテキストアセンブラ。チケットを入力し、組み立てたコンテキストを出力する。トークン予算と、CIでゲートされた3つの不変条件を持つ。ナレッジベースは144スニペット——バージョン管理されたポリシークローズ、過去の解決例、日付付きの季節メモ——うち30件が失効(16件はポリシーの旧バージョン、14件は期限切れメモ)。
[EVIDENCE] 不変条件を1つずつ外し、N=100チケットずつで検証:
what was removed          budget_overflows   stale_fact_leaks   distinct prefixes   exit
nothing                                  0                  0                   1      0
the budget packer                      100                  0                   1      1
the freshness filter                     0                100                   1      1
the stable prefix                        0                  0                 100      1
make gate 0で終了。make gate-off — フレッシュネスフィルタを外した同じゲートは1で終了。make gate-removed 不変条件を順に外し、その都度失敗することをアサートする。失敗を一度も見たことがないゲートは、希望であってゲートではない。
2行目をよく見てほしい。これは必ずあなたにも起きる。予算パッカーを外しても、どこにもエラーは出ない。1,200トークンのカウンターに対して平均1,420、最悪1,481トークンを組み立てて渡してしまい、実際のプロバイダはどちら側からでも黙って切り捨てる。だから一番必要だった事実が落ちる。そして、これが我々の「瓶」だ。3行目は、カウンターに置かれた旧バージョンの返金条項が、100件中100件で引用されている。見た目は完全にポリシーそのもの。実際、3月時点ではポリシーだった。
30分で作る——契約
エンジニアが尋ねる順に、アセンブラが必要とするものをすべて用意する。入力:チケットとナレッジベース。出力:組み立て済みのコンテキスト1つ。不変条件:日付が付けられないものは入れない、予算に収まらないものは詰めない。ストップルール:予算に達したら止める。プレフィックスを削ってまで詰め込まない。
PINNED_PREFIX = system_prompt + tool_schemas   # byte-identical on EVERY request:
                                               # no clock, no session id, sorted keys
SNIPPET = {                                    # the minimal shape of a memory row
  "id":            str,
  "text":          str,
  "expires":       date | None,                # the field that makes refusal possible
  "superseded_by": id   | None,
}
def assemble(ticket, kb, budget=MAX_CONTEXT_TOKENS):
    pool   = [s for s in kb if is_fresh(s)]           # 1. FILTER — before anything else
    ranked = sorted(pool, key=lambda s: -score(s, ticket))   # 2. SCORE
    out, used = [], n_tokens(PINNED_PREFIX)
    for s in ranked:                                  # 3. PACK, newest-relevant first
        if used + n_tokens(s.text) > budget: continue
        out.append(s); used += n_tokens(s.text)
    return PINNED_PREFIX, out, used

# CI gate (make gate): N=100 tickets
#   budget_overflows             == 0
#   stale_fact_leaks             == 0
#   distinct_prefix_fingerprints == 1     (sha256 of the pinned prefix, per request)
# any line off threshold → exit 1 → the build fails
このブロックに意図的に欠けているもの:回答の正しさメトリクス(下記のhonest gap)、リランキング(順序は変えるが適格性は変えない)、そしてライブモデル。
[設計] このプロジェクトが「デモ」ではなくエンタープライズ仕様だと言える理由が4つある。それぞれに意味がある。
- スコアリングより先にフィルタする。後回しでは意味がない。 パッキング後に古い条項を除外しても、すでに新しい条項が押し出されてしまっている。これはエピソード1のプランゲートと同じ構造だ。ツールを動かす前に検証するから意味がある。後からフィルタしても、ただログをきれいにするだけだ。
- プレフィックスは「意図」ではなく「指紋」で管理する。 ゲートはリクエストごとにピン留めしたプレフィックスのハッシュ値を計算し、100回すべてで完全に同じ値であることを求める。「プレフィックスは安定している」というのは単なる思い込みだが、N=100でsha256を取ればそれは事実になる。誰かが親切心でタイムスタンプを追加しても、そのバージョンだけが生き残る。
- スーパセッションは慣習ではなく、正式なフィールドとして扱う。
superseded_by行を削除せずに退役させれば、監査時に「3月にデスクが何を伝えたか」を後から確認できる。一方、アセンブラは今日それを提供しない。行を消せば監査ができず、日付がなければ正しい答えも出せない。 - オーバーフローは「警告」ではなく「ビルド失敗」として扱う。 プロバイダーは予算超過のコンテキストを黙ってトランケートする。どの事実を顧客が失うかはAPIが勝手に決める。ゼロでゲートすれば、その判断を自分の手に取り戻せる。
[未解決] どちらのプロジェクトも「証明」にはなっていない。どちらのコーパスも合成データで、コックもスタブだ。エンタープライズ構成の現状は「実行可能・ゲート済み」であり、「本番運用・実測済み」ではない。本物にするには、実際のデスクからサンプリングしたナレッジベースと、そのスーパセッション履歴、さらに3つの不変条件の横に「答えの正確性」メトリクスを並べて報告する必要がある。なぜなら、コンテキストが新鮮で小さく安定していても、間違ったコンテキストである可能性があり、この3つの数字だけではそれを検知できないからだ。
同じ話から、5つの選択肢
背骨はひとつ。あとは読者ごとに違う扉がある。今週はひとつだけ決断し、ひとつだけ行動しよう。残りは置いていけ。
| あなたが | このエピソードで変わる決断 | 今週やるべきこと |
|---|---|---|
| 高校生ビルダーなら | コンテキストエンジニアリングとは、パントリーを大きくすることではなく、カウンターに何を出すかを決めることだ。 | Colabラボを2秒で動かし(キー不要)、パントリーとカウンターのモデルを友人1人に説明してみよう。 |
| AIエンジニア | コストはプレフィックスの配置で決まり、正しさは事実に日付が付いているかどうかで決まる。 | システムプロンプト内でリクエストごとに変わる要素をgrepで探し、末尾に移動させる。移動前後でヒット率を計測する。 |
| ファウンダー | 推論コストが利用量より速く膨らむ場合、たいていは価格設定の問題ではなくキャッシュ配置のバグだ。 | チームにプレフィックスキャッシュのヒット率を尋ねる。誰も答えられなければ、それが発見だ。 |
| 経営層 | “Which version of the policy did the agent answer from?” is an audit question with a schema answer.(訳:「エージェントはどのバージョンの方策から回答したのか?」は、スキーマで答えられる監査質問である。) | 次回リリース前に、エージェントが取得できるすべての行に有効期限または後継フィールドを必須とする。 |
| 投資家 | 参入障壁(moat)はウィンドウの大きさではなく、キュレーション層とそのゲートにこそ宿る。 | どんなエージェント系スタートアップにも、キャッシュヒット率と失効事実の混入率を並べて尋ねるべきだ。どちらか一方だけなら、それは見せかけにすぎない。 |
リアリティ・ミッション
今週すでに動かしている何かで、15分だけ使う。
- 実際に稼働しているエージェントの2連続ターンで、送信したバイト列そのものを出力する。「送ったつもり」ではなく、実際にワイヤに流れたものを。
- 2つをdiffし、最初に異なるバイトを見つける。そこから先は毎ターン、永遠に再プリフィルされ続ける。
- そのバイトが時計、ID、ティア、ツールの順序シャッフル、またはフォーマット済み日付なら、文脈の末尾に移動させる。それ以外は何も変えない。
- メモリストアを開き、スキーマにこう問う:その行だけで、まだ真かどうか判別できるか?答えがノーなら、取得の問題ではなくカラム不足だ。
- カラムを追加し、スコアリング前にフィルタする。これまで信じていたものを再実行する。
もし2番目の手順で何も見つからず、エージェントが毎回新規の単発プロンプトを送っているなら、もっと有益なことを学んだ——まだ第1段階で、カウンターは埋まり始めていない。だが、いずれ埋まる。
リサーチ・チャレンジ
これをエージェントに渡し、実行前に予測を事前登録する。予測していなかった結果は、必ず自分に都合よく解釈してしまうからだ。
検証可能な答えを持つリトリーバル型タスクを1つ選び、既知割合の行が後継済みのコーパスを用意する。モデルとタスクは固定し、コンテキスト予算(4段階、必要最小から10倍まで)と鮮度ポリシー(なし・有効期限フィルタ・有効期限+新しさ重み付き再ランク)を独立に変化させる。全12セルで答えの正確度、失効事実の混入率、プレフィックスキャッシュヒット率、コストを報告し、1回答ごとの混入率と1文脈ごとの汚染度も分けて報告する。
事前登録:精度がコンテキスト予算に対して単調に増減するか、また2種類のリーケージ指標が逆方向に動くことがあるか。
自作スタブでは、この2つの指標は大きな予算で乖離する──これはスタブ特有の挙動による。だが、実際のモデルで本当にこうした乖離が起きるかどうかは、まだ誰も公表していない。もし本物の現象として観測できたなら、それは単なる設定ミスではなく、論文化に値する発見だ。
最近の動向
この段階の最新状況。30の先駆的な情報源を毎週ライブで同期し、技術的な信号をもとにまとめている。research-anything (make watch-sync(オーディエンス規模ではなく、技術的なシグナルのみで順位付け。)
同期日:2026-09-11
- arXiv:2609.11728 (2026-09-10) — Reproducibility in the Age of Agentic AI: Context Engineering at the Timescale of a Codebase。公開時点で1日経過:再現可能な研究実践──テスト、コミット履歴、リポジトリ構造、意思決定記録──をコーディングエージェントのコンテキストエンジニアリングとして読み解き、著者は研究者が成果物の検証責任を持ち続けるべきだと主張している。
- arXiv:2608.23992 (2026-08-25) — Hybrid Semantic Tool Discovery for Enterprise MCP Gateway。このエピソードで自分でも測ってみたかった実運用の数字:PayPalでは2,000以上のツールを200以上のサーバーで公開した結果、ユーザーの質問が届く前に140,200トークン(コンテキストウィンドウの70.1%)を消費していた。ダンプを2つの検索ツールに置き換えることで1,300トークン(0.8%)に激減。論文自身も、これはリトリーバルの問題ではなくコンテキストエンジニアリングのボトルネックだと位置づけている。
- arXiv:2608.29016 (2026-08-29) — Towards Fully Automated Medical Imaging Code Generation via Validation-based Context Engineering。コンテキストは手作業ではなく、ドメイン知識ベース・共有メモリ・検証フィードバックから組み立てられ、6つのデータセットと5つのバックボーンモデルで検証。コンテキスト構築が独自のテストを持つコンポーネントへと進化しつつある。
- 古くて重要なもの:arXiv:2005.11401(RAG)、arXiv:2307.03172(Lost in the Middle)、arXiv:2310.08560(MemGPT)、そして2025年の実践者カノン──LangChainの4バケット、ChromaのContext Rot、Manusのキャッシュ率投稿、Anthropicのエンジニアリング投稿。
【補足】動いていない部分。Chromaの劣化カーブを2026年の最新ロングコンテキストモデルで再現した研究は見つからなかった。コンテキストロットに関する最も強い公開証拠はいまだ2025年7月のベンダーレポートと2023年の論文であり、2026年モデルで独立再現されたものはない。効果の大きさは未確定だが、方向性は十分に支持されているとみなすべきだ。また、プロバイダ横断のプレフィックスキャッシュヒット率の公開制御測定も見当たらない。皆が引用するキャッシュ/非キャッシュ10倍差は、あるベンダーのリスト価格が一時点で示したものに過ぎない。
理解度チェック
上に戻らず、自分の理解をここで確認せよ。
- パントリーとカウンターは何が違うか? そして、コンテキストウィンドウを大きくすると広がるのはどちらか?
- システムプロンプトの先頭にタイムスタンプを置くと、同じトークン数でも末尾に置いた場合よりコストが高くなるのはなぜか?
- 「100万トークンのウィンドウがあればリトリーバル問題は解決する」という主張に反証する2つの測定指標を挙げ、それぞれ何を固定したか説明せよ。
- リトリーバーの精度が高くても、メモリストアに有効期限フィールドがなければリーケージがゼロにならないのはなぜか、一文で述べよ。
- 失効事実の混入率が0.000と出ている。この数字が虚偽になりうる最も単純な方法と、必ず併記すべきもう一つの指標を挙げよ。
次回予告
カウンターの問題をすべて潰した。
揮発性のあるフィールドはすべて末尾に移し、プリフィックスは100回のリクエストで常に同じハッシュ値になる。各行には有効期限と後継ポインタを持たせ、日付のないものはアセンブラが弾く。予算を明示し、オーバーフローはゼロで遮断。キャッシュヒット率0.978、リーケージ0.000。これでキッチンは完璧だと、その午後は本気で思う。
そこへ顧客から問い合わせが届く。エージェントはチケットを読み、現行ポリシーの正しい条項だけを取り出し、内容も形式も正しい返信を作る。
そして返金処理を実行する。
2回だ。最初のリクエストがタイムアウトし、返金はリトライしてはいけない処理だと誰も教えていなかった。しかもデスク上限を超える金額で、誰もその上限をエージェントが読める場所に書いていなかった。さらにチケットシステムと請求システムへの書き込み順が食い違い、両者の記録が矛盾した。元に戻そうとしても、取り消す手段はどこにもなかった。
カウンターはきれいだった。事実も新鮮だった。だが、コックが何に手を出していいかは誰も決めていなかった。
エピソード3 — レストランのキッチンへ。ハーネスエンジニアリング:モデルが正しい事実を見ていても、行動できないことがある——そして初回ハーネスが4セル中2つで状況を悪化させたという測定結果が出ている。
次に読むべき記事
エピソード2:Intelligence Engineering Adventures シーズン7 — キッチンラダー。シリーズの出典では、主張ごとに定義・導出・証拠・エンジニアリング判断・未解決問題のタグが付いている。比喩は主張の導入には使えるが、証拠にはならない。各エピソードには無料で使えるColabノートブック(APIキー不要)と、ゼロから作った2つのアプリ(個人用・エンタープライズ型)が付く。ラダーはFengら(arXiv:2608.21156)のもので、私のオリジナルではない。「what moved」セクションは、30の先駆的ソースを毎週ライブで同期し、技術的な中身だけで順位付けしている。この記事には雇用主やクライアントの素材は一切含まれていない。— Paul Jialiang Wu ·futuremake.io
参考文献
- Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F., Liang, P. (2023). Lost in the Middle: How Language Models Use Long Contexts. arXiv:2307.03172 — 要旨ページを2026-09-11に閲覧。位置に関する文はそこから逐語引用。TACL 12 (2024)として出版。TACL 12 (2024);両方の要旨を比較したが内容は完全に一致しており、どちらにも引用が有効。
- Ji, Y. ("Peak") (2025-07-18). Context Engineering for AI Agents: Lessons from Building Manus. manus.im/blog — 2026-09-11に全文読了。KVキャッシュヒット率、プレフィックス内のタイムスタンプ、100:1の入出力比、キャッシュ有無のリスト価格(ラボのコストモデルに使用)の出典。
- Anthropic (2025-09-29). Effective context engineering for AI agents. anthropic.com/engineering — 2026-09-11に閲覧。有限リソースに関する引用、および履歴表で説明したアテンション予算の出典。
- Hong, K., Troynikov, A., Huber, J. (2025-07-14). Context Rot: How Increasing Input Tokens Impacts LLM Performance. Chroma技術レポート, research.trychroma.com/context-rot — 2026-09-11に閲覧。18モデル、タスク難易度は一定、入力長のみを変化。
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. (2026). Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2(2026-08-26改訂)— 本シリーズが採用するラダー構造。「Context Engineering to manage information access」(訳:「情報アクセスを管理するためのコンテキストエンジニアリング」)はアブストラクトからの引用。
- Lewis, P., Perez, E., Piktus, A. ほか(2020)。Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. arXiv:2005.11401(NeurIPS 2020)— 歴史年表における2020年の転換点。アブストラクトページを参照、引用はなし。
- Packer, C., Wooders, S., Lin, K. ほか(2023)。MemGPT: Towards LLMs as Operating Systems. arXiv:2310.08560— 仮想的なコンテキスト管理。アブストラクトページを参照、引用はなし。
- Willison, S.(2025-06-27)。Context engineering. simonwillison.net— 2025年6月の両投稿について私が参照したアーティファクト。オリジナル:Tobi Lütke、Andrej Karpathy。両者ともクライアントサイドでレンダリングされるため、ここでの引用はWillisonによる書き起こしをもとに、それぞれに帰属させている。
- The LangChain Team(2025-07-02)。Context Engineering. langchain.com/blog— write / select / compress / isolate の分類法。2026-09-11に参照、記述のみで引用はなし。
- Barba, L. A.(2026-09-10)。Reproducibility in the Age of Agentic AI: Context Engineering at the Timescale of a Codebase. arXiv:2609.11728 — 「what moved」;要旨ページを2026-09-11に確認。
- Saha, O. ほか(2026-08-25)。エンタープライズMCPゲートウェイ向けハイブリッドセマンティックツールディスカバリー:アーキテクチャと実装。 arXiv:2608.23992 — 「what moved」;140.2k→1.3kトークンの数値は要旨ページより、2026-09-11に確認。
- Zhao, Z. ほか(2026-08-29)。バリデーションベースのコンテキストエンジニアリングによる完全自動医用画像コード生成を目指して。 arXiv:2608.29016 — 「what moved」;要旨ページを2026-09-11に確認。
- Dhage, S.(2026)。予測可能なエージェント型システムのためのハーネスエンジニアリング——決定的実行制約の実証研究。 arXiv:2608.26197 — エピソード1の計測値。ここでプランゲートの形として参照され、エピソード3の予告も兼ねている。
- Anthropic(2024-12-19)。効果的なAIエージェントの構築。 anthropic.com/engineering — シリーズ表におけるハーネスエンジニアリングのランドマーク。
- 本エピソードのラボとプロジェクトは、すべてのセルを公開前に実行済み。gist.github.com/wjlgatech/47eb7973aa5e292524c9c205c73c34d9 —
02_context_budget.ipynb,the-fridge-list,the-desk-memory. - Intelligence Engineering Adventures, Season 7, Episode 1 — プロンプトエンジニアリングは仕様であって呪文ではない——レシピカード、プランゲート、そして本エピソードが基盤とする決定性メトリクスのために。