Serie AI-Native · Ingeniería de Agentes, comparativa: Prompt · Contexto · Harness · Bucle · Grafo
La ingeniería de evaluación es la función de verdad, no un leaderboard
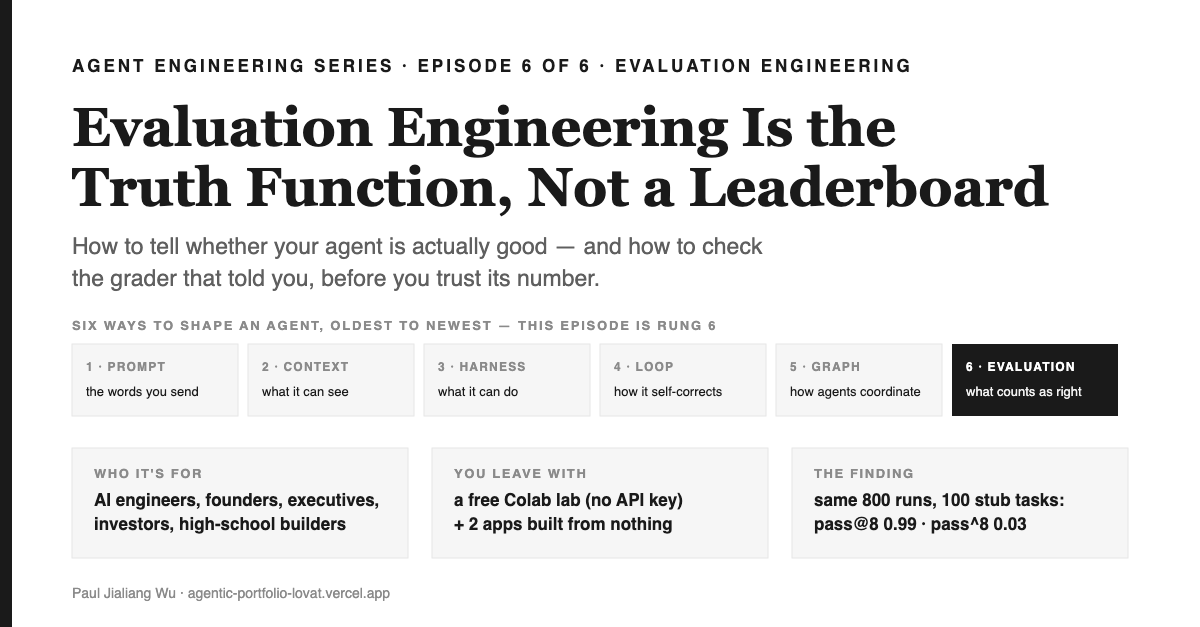
Episodio 6 de 6, y el cierre de la serie. Cada uno de los cinco episodios anteriores terminó con un número — determinismo 1.000, fuga cero, ninguna llamada fuera de sobre — y todos salieron de un evaluador que nadie auditó. Este es el peldaño que evalúa al evaluador, y por eso la sexta fila de la escalera permaneció vacía hasta ahora.
Resumen en 1 minuto — lo esencial que te llevas
De qué va esto. El final de una serie comparativa sobre las seis formas de diseñar un agente de IA — ingeniería de prompts (las palabras que envías), ingeniería de contexto (lo que puede ver), ingeniería de harness (lo que puede hacer), ingeniería de bucles (cómo se autocorrige), ingeniería de grafos (cómo se coordinan los agentes) y ingeniería de evaluación (qué cuenta como correcto). Este episodio: la historia de la ingeniería de evaluación desde HELM en 2022 hasta los benchmarks de jueces del mes pasado, quién la impulsa y los principios que sobreviven a la medición.
Por qué importa. Cada cifra que tu equipo menciona sobre un sistema de IA — precisión, determinismo, tasa de aciertos, "el eval está en verde" — es el resultado que arroja un calificador, y casi nadie se detiene a medir a ese calificador. En el laboratorio de este episodio, un juez obtuvo un kappa de Cohen de 0.585 frente a etiquetas humanas en 80 ejemplos reservados y 0.899 después de dos ajustes sencillos, sin modificar el juez; y el mismo agente, en 800 ejecuciones, muestra pass@8 = 0.99 o pass^8 = 0.03 dependiendo únicamente de la regla de reporte. Para una persona fundadora, esa es la diferencia entre un indicador y un reembolso; para alguien ingeniero, es una compuerta que puedes instalar hoy mismo.
Qué puedes hacer después de leer. Etiqueta manualmente veinte salidas de tu agente y mide el acuerdo de tu calificador contigo antes de confiar en lo que diga. Te llevas un notebook de Colab gratuito (sin API key, solo librerías estándar) y dos aplicaciones creadas desde cero: un reporte de seguimiento de hábitos cuyo calificador me adjudicó una racha del 68% que nunca mantuve, y un banco de pruebas de auditoría cuya compuerta de CI marca exit 1 cuando un ítem no medido se cuenta como acierto.
Season 7 — la espina de la serie
- Ingeniería de prompts — una especificación, no un hechizo episodio 1
- Ingeniería de contexto — un presupuesto, no una ventana más grande episodio 2
- Ingeniería de harness — el envelope, no el agente episodio 3
- Ingeniería de bucles — un árbitro externo, no un reintento episodio 4
- Ingeniería de grafos — una agenda, no un elenco de personajes episodio 5
- Ingeniería de evaluación — la función de verdad, no un leaderboard este episodio
De qué va este episodio y por qué la ingeniería de evaluación es el sexto peldaño
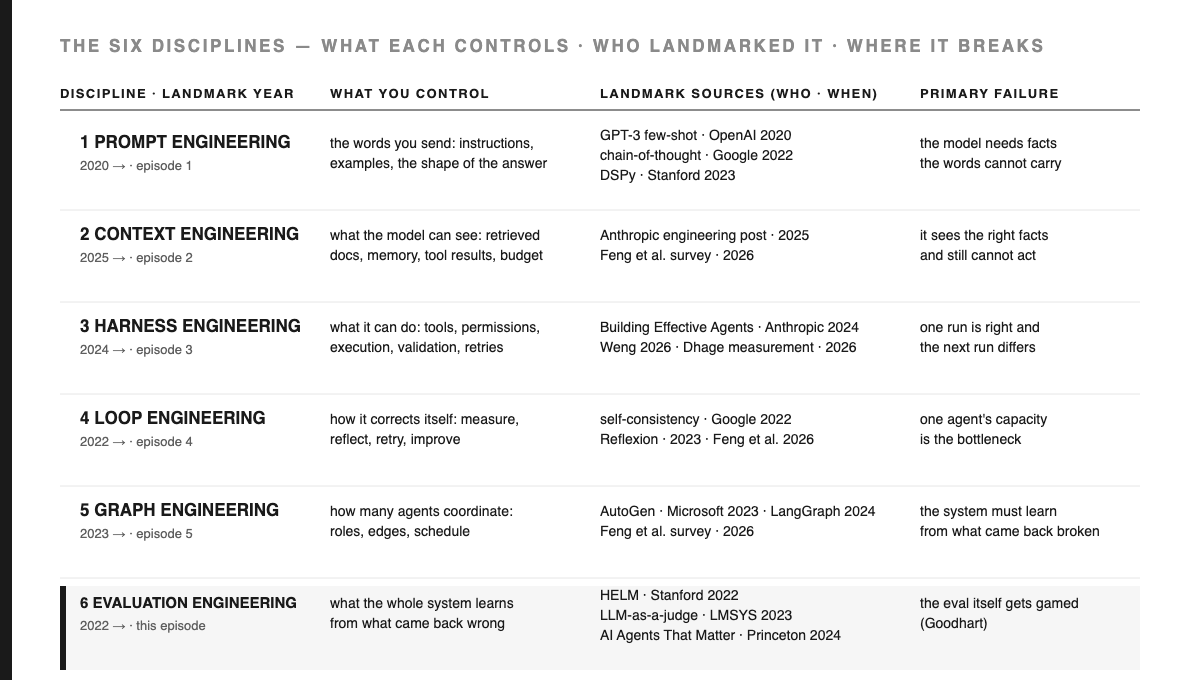
Esta temporada ha comparado seis disciplinas definidas para construir agentes de IA. Cinco de ellas se publicaron y pueden fecharse claramente desde su origen: prompt (2020), loop (2022), graph (2023), harness (2024), context (2025). Feng et al. (arXiv:2608.21156) las ordena según lo que cada una te permite controlar — prompt, context, harness, loop, graph — que es el orden de los episodios de esta temporada, aunque no coincide con el de sus años clave. La sexta fila ha aparecido ??? en todos los episodios desde el primero.
[DISEÑO] Aquí explico el motivo, de una vez y para dejarlo claro. Cuando el Episodio 1 se publicó el 2026-09-03, un revisor externo propuso que la sexta capa pendiente debía ser ingeniería de evaluación — la función de verdad de la que todas las demás capas toman prestado para saber si realmente mejoraron — con gobernanza, economía y organización detrás. El Episodio 1 la dejó registrada como candidata y me dejó la decisión, porque nombrar un peldaño que no has argumentado es justo el tipo de lista superficial que esta temporada existe para evitar. Ahora el argumento está hecho, así que la decisión se toma aquí: el sexto peldaño es la ingeniería de evaluación. Permaneció sin nombre porque una disciplina se gana su lugar al romper la fila inferior, y eso no puede demostrarse hasta que existen las filas de abajo.
Cada episodio le hizo cuatro preguntas a su peldaño: de dónde vino, qué puedes controlar, quién lo impulsa y qué fallo te obliga a subir. Este tiene una quinta, y por eso es el cierre y no un simple apéndice: ¿qué te indicó que alguna de las cinco anteriores realmente funcionaba?
¿Para quién es esto? Un ingeniero de IA cuyo CI marca verde pero cuyos usuarios opinan lo contrario. Un fundador a punto de poner un número de benchmark en una presentación. Un ejecutivo que va a aprobar un agente que moverá dinero. Un estudiante de secundaria que quiere saber qué es "el eval". Prerrequisito: haber creído en un número.
De dónde viene la ingeniería de evaluación y quién la impulsa
[DEF] Un eval es, según la propia definición de Anthropic, "a test for an AI system: give an AI an input, then apply grading logic to its output to measure success" (Traducción: una prueba para un sistema de IA: dale una entrada a la IA, luego aplica lógica de calificación a su salida para medir el éxito) — la definición correcta porque sitúa la lógica de calificación en su interior y no como un accesorio externo. La ingeniería de evaluación es la disciplina de construir esa lógica de calificación para que su resultado sea confiable, y de medir la propia lógica de calificación—justo la parte que casi todos pasan por alto.
| Cuándo | Hito | Quién | Qué cambió |
|---|---|---|---|
| 2022-11 | HELM: Holistic Evaluation of Language Models (arXiv:2211.09110) | Liang et al., Stanford CRFM | Antes de HELM, los modelos se evaluaban en promedio sobre solo el 17.9% de los escenarios clave; después, sobre el 96.0%, bajo condiciones estandarizadas y con siete métricas en vez de solo precisión. La evaluación pasa a ser infraestructura. |
| 2023-06 | Judging LLM-as-a-Judge (arXiv:2306.05685) | Zheng et al., LMSYS / UC Berkeley | Un modelo potente puede calificar respuestas abiertas con un nivel de acuerdo cercano al humano—y arrastra sesgos de posición, verbosidad y auto-mejora que se pueden medir y mitigar. El calificador se convierte en objeto de estudio. |
| 2023-07 | A Survey on Evaluation of Large Language Models (arXiv:2307.03109) | Chang et al. | Organiza el campo en torno a qué evaluar, dónde, y cómo, y sostiene abiertamente que la evaluación debe entenderse como una disciplina independiente. |
| 2023-10 | SWE-bench (arXiv:2310.06770) | Jimenez et al., Princeton | 2,294 tareas extraídas de issues reales en GitHub, evaluadas según si pasan las pruebas automáticas del propio repositorio. Un oráculo de ejecución en vez de una métrica de similitud. El mejor modelo del momento resolvió solo el 1.96%. |
| 2024-03 | Your AI Product Needs Evals (hamel.dev) | Hamel Husain | El texto de referencia para quienes construyen en la práctica. Los productos LLM que fracasan "almost always share a common root cause: a failure to create robust evaluation systems" (Traducción: "casi siempre comparten una causa raíz: no haber creado sistemas de evaluación robustos"), y la solución es una escalera de tres peldaños: de pruebas unitarias, a evaluación humano-modelo, y finalmente pruebas A/B. |
| 2024-06 | τ-bench (arXiv:2406.12045) | Yao et al., Sierra | Presenta pass^k — resuelto en todas las k ejecuciones — porque pasar una sola vez daba resultados engañosos en agentes que nadie podría poner en producción. |
| 2024-07 | AI Agents That Matter (arXiv:2407.01502) | Kapoor et al., Princeton | El costo debe incluirse en la métrica; los conjuntos de validación suelen ser insuficientes o directamente no existir; el benchmark y el despliegue responden a necesidades distintas. Es la crítica más citada a la evaluación de agentes en la práctica. |
| 2023–26 | OpenAI Evals (github.com/openai/evals) y las arenas públicas (lmarena.ai) | OpenAI; LMSYS / LMArena | Las evals pasan a ser un artefacto entregable: un framework donde registras pruebas y un ranking en vivo generado por la comunidad. Ambos son también el lugar donde entra en escena Goodhart. |
| 2026-01 | Demystifying evals for AI agents (anthropic.com/engineering) | Anthropic | Las evals como CI, no como paper: "Automated evals are especially useful pre-launch and in CI/CD, running on each agent change and model upgrade as the first line of defense against quality problems." (Traducción: Las evaluaciones automatizadas son especialmente útiles antes del lanzamiento y en CI/CD, ejecutándose con cada cambio de agente y actualización de modelo como primera línea de defensa ante problemas de calidad.) |
| 2026-08 | Los benchmarks de jueces (arXiv:2608.26623) y la taxonomía de contaminación (arXiv:2608.29463) | Verma et al.; Angulo et al. | Tres semanas antes del cierre de edición: ahora los jueces también son evaluados, y la contaminación se clasifica según la mitigación que logra superar. |
[DISEÑO] Fíjate en lo que no aparece en esa lista: un leaderboard. Los calificadores subieron la misma escalera que los agentes — coincidencia exacta, puntaje de similitud, oráculo de ejecución, modelo — cada paso gana cobertura y sacrifica certeza. Los leaderboards son solo el resultado visible; la disciplina es toda la maquinaria detrás, y solo uno de los dos tiene captura de pantalla.
Quién lo impulsa hoy. Los grupos académicos lideran la crítica — Princeton (Kapoor, Narayanan, Jimenez), Stanford CRFM, LMSYS/LMArena. Los laboratorios llevan la práctica: Anthropic trata las evals como CI, OpenAI entrega un framework donde registras pruebas. Y la capa más reciente es una literatura que crece rápido y cuyo tema entero es el calificador — AgentJudgeBench, los estudios sobre jueces de agentes de voz y móviles. No existía hace dos años, lo que es la señal más clara de que este escalón es real.
El modelo mental: el registro de retiros
Una imagen ha acompañado los seis episodios; aquí está por última vez. Cada cocinero sube la misma escalera — tú mismo, tu familia, una cocina de restaurante, una cadena de comida rápida, la cadena nacional de suministro que alimenta a varias cadenas — y cada ingeniero de IA escala una equivalente: estudiante escolar, desarrollador junior, desarrollador senior, líder técnico de IA, CTO, líder de frontera. El primer peldaño era la tarjeta de recetas. El sexto es el registro de retiros.registro de devoluciones.
Un sistema alimentario nacional no aprende de los platos que salieron bien. Aprende de lo que regresa con problemas: el lote que enfermó a alguien, el proveedor cuyo aceite no era lo que decía la etiqueta. El registro de devoluciones es el único documento en todo el sistema capaz de declarar que un número producido por el resto es falso.
Y tiene una característica que nadie disfruta: un registro de devoluciones vacío solo puede significar dos cosas, y solo una es buena noticia. O la comida es segura, o nadie la está revisando. Desde dentro del registro ambas situaciones se ven idénticas — por eso un tablero en verde no es evidencia de nada.
| Peldaño | Cocina | Quién eres | Qué puedes moldear |
|---|---|---|---|
| 1. prompt | la tarjeta de recetas — cocinar solo para ti | aprendiz | las instrucciones escritas que sigue quien cocina |
| 2. contexto | la despensa — cocinar para la familia | desarrollador junior | lo que hay sobre la mesa y en el refrigerador mientras cocinas |
| 3. harness | la cocina de un restaurante | desarrollador senior | las estaciones, las herramientas a la mano, el pase donde se revisa cada plato |
| 4. loop | la cadena de comida rápida | tech lead de IA | probar, medir, corregir y llevar la mejora a todas las sucursales |
| 5. grafo | la cadena nacional de suministro | CTO | muchas cocinas, un solo itinerario, una sola flota de camiones |
| 6. evaluación | el registro de retiros (recall log) | líder de frontera | lo que todo el sistema alimentario aprende de los errores que regresan |
Dos ejes, no uno. Toda cocina opera las seis capas al mismo tiempo: quien cocina en casa tiene su tarjeta de recetas, su despensa, su estufa, una prueba de sabor, un proveedor — y el recuerdo del platillo que enfermó a alguien. Lo que cambia al subir es cuántas capas puedes intervenir y con cuánta rigurosidad ejecutas cada una: primero a ojo, luego midiendo, después con compuertas, y finalmente autocorrigiendo. Las seis disciplinas son capas (lo que controlas); la senioridad es madurez (cómo las ejecutas). Evaluación no es más avanzada que grafo: un grafo de tres nodos con un golden set calibrado es más maduro que una topología de cuarenta agentes cuyo único eval es una demo que salió bien. Eso se nota más aquí, porque evaluación suele ser la capa que más veces se ejecuta en madurez cero por equipos sofisticados en todo lo demás.
La analogía puede servir para presentar esa idea, pero nunca debe tomarse como evidencia. El anclaje real está en el mapeo 1:1 de abajo.
El vocabulario, atado a su fuente
[DEF] Cuatro palabras hacen el trabajo aquí, y tres suelen usarse para decir justo lo contrario.
- Golden set — entradas con resultados que una persona escribió; no salidas generadas por tu modelo y que solo revisaste superficialmente. La clave: una etiqueta dorada puede contradecir a tu sistema y aun así tener la razón.
- Juez — cualquier lógica de calificación: una comparación de cadenas, una aserción, una batería de pruebas o un modelo al que se le pregunta “¿eso estuvo bien?”. Zheng et al. demostraron que esta última opción es viable y tiene sesgos medibles; ambas partes son esenciales.
- Kappa de Cohen (κ) — acuerdo entre dos etiquetadores más allá del azar. El acuerdo bruto no es la métrica: en la primera celda de este episodio, lanzar una moneda coincidió con una lista fija el 47.7% de las veces, con κ = −0.046. Las bandas convencionales de κ vienen de Landis y Koch (1977), propuestas por sus autores como referencias arbitrarias y no derivadas; el artículo está detrás de un muro de pago, así que aquí se describe y no se cita. Yo uso κ ≥ 0.60 como piso ingenieril porque ahí inicia su banda de “sustancial”, no porque 0.60 sea un hecho universal.
- pass@k vs pass^k — resuelto al menos una vez en k intentos, frente a resuelto en todas las. Yao et al. introdujeron la segunda en τ-bench porque incluso los agentes de llamadas a funciones más avanzados eran "quite inconsistent (pass^8 <25% in retail)" (Traducción: bastante inconsistentes — pass^8 menor al 25% en aplicaciones comerciales).
[ABIERTO] Una frase que deliberadamente no defino: “la eval pasó”. No significa nada hasta que digas con qué golden set, calificado por quién, reportado cómo, con qué k y con qué acuerdo frente a una persona. Si respondes esas cinco, la frase sobra; si no, justo ahí se esconde la ambigüedad.
La afirmación, clasificada
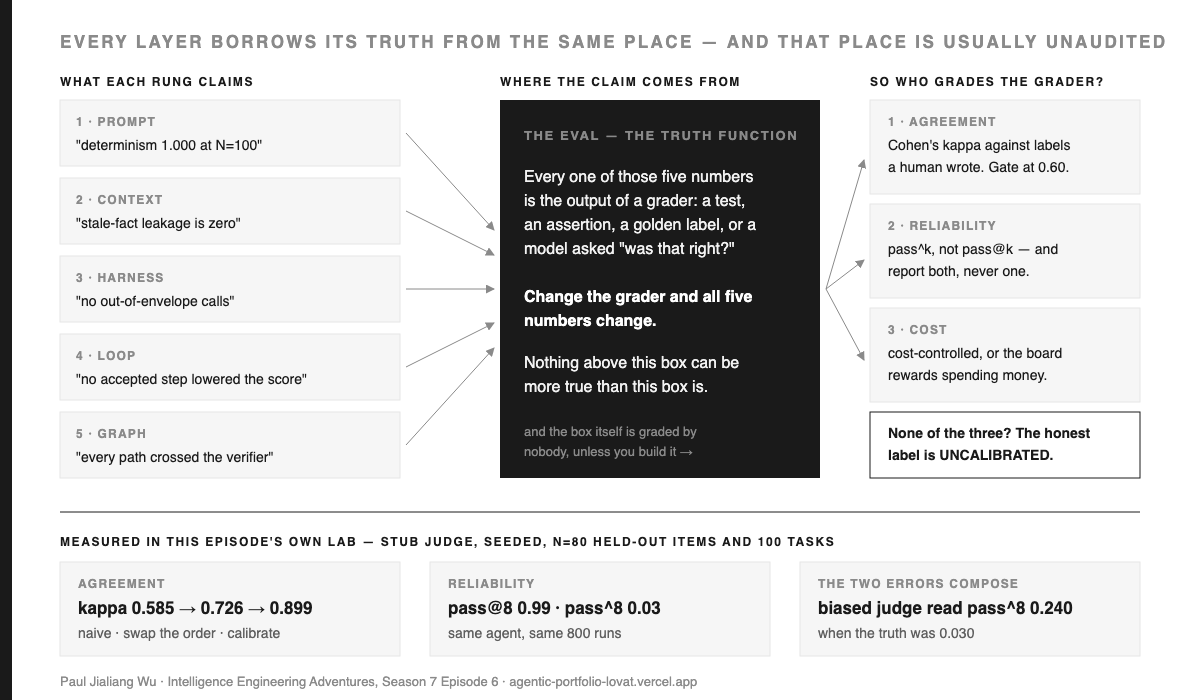
[DEF] La ingeniería de evaluación es la función de verdad. Toda afirmación de las demás capas sobre sí mismas es la salida de esta capa, así que la precisión de tu sistema está limitada por la de tu calificador — igual que el error de una regla limita la precisión de una medición.
[EVIDENCIA] Tres mediciones publicadas lo hacen literal, desde tres ángulos.
Uno — el calificador inclina la balanza, y eso ya se midió. Zheng et al. (arXiv:2306.05685, v4) analizaron "the usage and limitations of LLM-as-a-judge, including position, verbosity, and self-enhancement biases, as well as limited reasoning ability" (Traducción: el uso y las limitaciones de LLM-as-a-judge, incluyendo sesgos de posición, verbosidad y auto-mejora, así como una capacidad de razonamiento limitada), y también midieron la buena noticia: los jueces sólidos "can match both controlled and crowdsourced human preferences well, achieving over 80% agreement, the same level of agreement between humans." (Traducción: pueden igualar tanto las preferencias humanas controladas como las de crowdsourcing, logrando más del 80% de acuerdo, el mismo nivel de acuerdo que hay entre humanos.) El hallazgo está en la combinación: el juez es casi tan bueno como una persona y puede verse influido por el orden en que le muestres las respuestas. Un equipo que solo interiorizó la primera mitad está usando un instrumento sin medir, aunque con buena reputación.
Dos — la regla de reporte es una variable libre que pesa más que la mayoría de las mejoras de modelo. Yao et al. (arXiv:2406.12045) encontraron que los agentes de última generación para llamadas a funciones — sus nombres abstractos gpt-4o — "succeed on <50% of the tasks, and are quite inconsistent (pass^8 <25% in retail)" (Traducción: resuelven menos del 50% de las tareas, y son bastante inconsistentes (pass^8 <25% en aplicaciones reales)), y propusieron pass^k para que la consistencia no pudiera ocultarse al promediar. Nada del agente cambia entre pass@8 y pass^8. Lo que cambia es la pregunta que le haces a los mismos ensayos.
Tres — el benchmark se aleja de lo que realmente importa. Kapoor et al. (arXiv:2407.01502) es el más incómodo de los tres porque ninguno de sus hallazgos trata sobre modelos. Hay "a narrow focus on accuracy without attention to other metrics" (Traducción: un enfoque limitado en la precisión, sin considerar otras métricas), y como resultado "SOTA agents are needlessly complex and costly, and the community has reached mistaken conclusions about the sources of accuracy gains." (Traducción: los agentes SOTA son innecesariamente complejos y costosos, y la comunidad ha llegado a conclusiones equivocadas sobre el origen de las mejoras en precisión.) Y lo más grave: "many agent benchmarks have inadequate holdout sets, and sometimes none at all" (Traducción: muchos benchmarks de agentes tienen conjuntos de validación inadecuados, y a veces ninguno en absoluto), lo que produce agentes "fragile because they take shortcuts and overfit to the benchmark in various ways." (Traducción: frágiles porque toman atajos y sobreajustan al benchmark de varias maneras.)
[DERIVATION] Si juntas los tres, obtienes la regla para la que existe este episodio. Un puntaje afirmado no es una sola medición; es la composición de tres — el comportamiento del agente, el acuerdo del evaluador con una persona, y la regla de reporte sobre ensayos repetidos. Normalmente solo te muestran el primero y te dicen que eso es todo. Si un equipo mejora su agente un 5% y su evaluador nada, ha movido su puntaje una cantidad desconocida en una dirección desconocida.
La taxonomía de contaminación del mes pasado dice lo mismo desde el lado del leaderboard: un puntaje de benchmark es una propiedad conjunta del modelo, el harness, el presupuesto de elicitación, la población muestreada y el estado de contaminación — y "Leaderboards publish the model and the score, so capability and leakage stay observationally equivalent" (Traducción: "Los leaderboards publican el modelo y la puntuación, así que la capacidad y la fuga de información permanecen observacionalmente equivalentes") (arXiv:2608.29463). Solo se publican dos de los cinco insumos. Por eso este episodio lleva este título.
Mapa técnico 1:1
Cada elemento del registro de retiros tiene su equivalente directo en el código.
| Registro de retiros | El sistema | Dónde reside |
|---|---|---|
| el lote que salió defectuoso | un elemento fallido | una fila del golden set |
| el archivo que define qué significa "mal", escrito antes de enviar el lote | las etiquetas doradas | un fixture escrito por una persona |
| el inspector que decide si un lote está mal | el juez | una prueba, una aserción o una llamada a modelo |
| un inspector que nunca ha reprobado una cocina | un calificador degenerado | κ = 0.000 con una tasa de aprobación del 100% |
| un segundo inspector que visita la misma cocina | medición de acuerdo | κ de Cohen frente a las etiquetas humanas |
| visitar un martes y luego un viernes | revisión intercambiando el orden de los elementos | califica en ambos órdenes y promedia los resultados |
| un lote que el inspector no puede decidir ni a favor ni en contra | un elemento sin medir | UNMEASURED — excluido, nunca cuenta como aprobado |
| una comida fallida en ocho visitas | consistencia a lo largo de los intentos | pass^k, no pass@k |
| una cadena que aprende a pasar la inspección | sobreajuste al benchmark | sin conjunto de validación independiente (Kapoor et al.) |
| un registro de retiros vacío | sin señal, o sin pruebas | cobertura: medidos ÷ calificados |
[DEF] Una fila merece su propio párrafo: es la regla fundamental sobre la que se construyen ambos proyectos, y bajo la que ya opera mi propia investigación. Sin evidencia significa no medido, y nunca significa aprobado. Un elemento que el evaluador no puede decidir no es un éxito dudoso; es una ausencia de información, y su registro honesto es un tercer estado. Los sistemas que no contemplan ese estado no se vuelven más precisos: simplemente se vuelven generosos en silencio, favoreciendo a quien reporta.
Compuerta de Predicción
Antes de seguir, comprométete. Tu evaluador coincide con tus etiquetas manuales en 79 de 100 elementos, en el conjunto completo de 100, antes de apartar los 20 de calibración.
Q1. ¿Cuál es su kappa de Cohen, aproximadamente? ¿Y un 79% de acuerdo es suficiente?
Q2. No cambias nada del evaluador, pero le muestras cada elemento dos veces — primero como candidato, luego como candidato en segundo lugar — y promedias. ¿Qué pasa con kappa, y cuántos de los 100 elementos cambian de veredicto entre los dos órdenes?
Q3. Un agente resuelve 100 tareas con probabilidades de éxito por tarea entre 0.25 y 0.95, ejecutadas ocho veces cada una. Ordena de mayor a menor: pass@1, pass@8, pass^8.
Q4. Tu evaluador tiene un sesgo en una dirección fija. ¿Eso afecta más tu medidpass@8 o tu pass^8 más?
Respuestas en la Sala de Fallos. Si la pregunta 4 te pareció evidente, la celda 8 del notebook merece cuatro minutos de tu tiempo.
Sala de Fallos
Rompe el mecanismo a propósito. Un mecanismo que no puedes romper no es una garantía, es solo una afirmación.
Fallo 1 — el promedio que parece correcto sobre una población de veredictos equivocados. El juez ingenuo del laboratorio reporta una tasa de aciertos de 0.720 frente a un valor dorado de 0.510, coincidiendo con el humano en 79 de 100. Ambos parecen aceptables; el kappa es 0.576 (en los 100; 0.585 en los 80 reservados), así que gran parte de ese acuerdo fue puro azar. Un promedio puede estar cerca de la verdad mientras las decisiones individuales están muy mal, y son esas decisiones las que realmente entregas. Una tasa de aciertos sin un número de acuerdo al lado es solo un rumor con decimales.
Fallo 2 — el calificador que nunca falla nada. Yo construí uno a propósito: un juez que devuelve PASS para cada ítem. Tasa de aciertos 1.000, kappa exactamente 0.000. Es el inspector de alimentos que jamás ha reprobado una cocina — un récord perfecto, y justo por eso nunca deberías comer ahí. No es un hombre de paja: es el caso límite de todo calificador cuyo umbral se ajustó hasta que el dashboard se veía bien. Yo he escrito ese calificador, y desde dentro realmente parece progreso.
Fallo 3 — el plato vacío del Episodio 1 sigue en el menú. El Episodio 1 terminó con un agente que devuelve {} siempre y por eso obtiene una Tasa de Reproducibilidad de 1.000. Cinco episodios después, ese mismo plato vacío pasa también la revisión de este episodio, y la propia regla del banco de pruebas lo explica: una respuesta vacía nunca es decidible, así que cada ítem cae en UNMEASURED — y la bandera make negative existe para rechazar es exactamente la que mueve UNMEASURED al numerador. Un {} ya ha pasado por seis cocinas; es el agente más exitoso de la temporada y nunca ha producido una salida. Toda métrica admite una entrada degenerada que la maximiza, y la defensa nunca es una mejor métrica — es una segunda métrica que destruye esa entrada degenerada. Determinismo junto al éxito en la tarea. Tasa de aciertos junto a kappa. Cobertura junto a ambas.
Fallo 4 — corregir un sesgo puede destapar otro y parecer un retroceso. Esto me costó rehacer el laboratorio. Mi primera versión aleatorizaba en qué posición aparecía cada ítem; luego, al intercambiar el orden, el kappa bajó de 0.820 a 0.780 en esa versión descartada, porque el sesgo aleatorio de posición estaba en parte compensando el sesgo de verbosidad. Dos errores en direcciones opuestas pueden parecer precisión. Si una corrección empeora tu métrica, la primera hipótesis es no que la corrección esté mal. Es que tu métrica estaba siendo favorecida por un segundo error.
Fallo 5 — enseñar para pasar la inspección. El argumento original de Goodhart — agregados monetarios, 1975, reimpreso en 1984 — es que una regularidad estadística se descompone cuando se usa como objetivo de control; el eslogan conciso que la mayoría cita es la formulación de Marilyn Strathern de 1997 sobre auditoría universitaria. Ambos están tras un muro de pago, así que aquí se describen en vez de citarse. La versión a escala de agentes está medida: la taxonomía del mes pasado (arXiv:2608.29463) clasifica la contaminación según qué mitigación derrota cada tipo, y un set de prueba privado solo cierra el primero de cinco. Tu golden set se contagia el mismo día que alguien lo lee antes de escribir el agente.
Respuestas. Q1: κ ≈ 0.58 — 79% de acuerdo no es suficiente, porque lanzar una moneda te da cerca del 50% solo por azar. Q2: kappa sube a 0.780 en el conjunto completo de 100 ítems (0.726 en los 80 reservados que reporta el resto de este episodio), y 50 de 100 ítems cambian de veredicto según el orden: la mitad del conjunto evaluado fue decidido solo por la posición en la que se presentó.Q3: pass@8 (0.99) > pass@1 (0.57) > pass^8 (0.03). Q4: pass^k, por mucho — es un AND sobre k evaluaciones, así que un sesgo en una dirección fija se acumula en vez de promediarse. Un juez sesgado por longitud leyó pass^8 como 0.240 cuando la verdad era 0.030.
Notebook
Lab 06 — La función de verdad: deriva del juez y pass^k. 
06_eval_truth_function.ipynb · Colab gratuito · sin API key · solo biblioteca estándar · sembrado en SEED=20260911 · ~2 segundos de CPU · cada celda ejecutada antes de publicar. El gist incluye ambos proyectos también: gist.github.com/wjlgatech/752a9450…
Nueve celdas. La decisión de diseño que lo hace interesante: el juez emite un score, no un veredicto, con los sesgos como desplazamientos aditivos. No es una simplificación didáctica: permite atribuir cada corrección, porque un desplazamiento que puedes nombrar es uno que puedes cancelar y comprobar el residuo.
- Kappa de Cohen, comprobado en dos entradas cuyas respuestas se conocen: identidad (1.000) y una moneda independiente (−0.046, con 47.7% de acuerdo bruto).
- El golden set: 100 ítems con una cualidad oculta, una etiqueta humana y dos propiedades — longitud y posición — independientes de la calidad por construcción.
- El juez: sesgo de posición ±0.30, de verbosidad ±0.12, ruido ±0.08. Veredicto ingenuo κ 0.576, con una tasa de acierto de 0.720 frente a un golden de 0.510.
- Re-evaluación con posiciones intercambiadas. Califica en ambos órdenes y promedia: el desplazamiento es +d en un sentido y −d en el otro, así que se cancela exactamente.50 de 100 elementos cambian de veredicto según el orden; κ sube a 0.780 en los 100 elementos (0.726 en los 80 reservados), y la verbosidad se deja sin tocar a propósito: el residuo demuestra que el ajuste fue quirúrgico.
- El conjunto de calibración — 20 elementos etiquetados a mano, usados no para entrenar sino para estimar el sesgo de longitud manteniendo fija la etiqueta dorada: +0.259 frente a un verdadero +0.240.
- Los tres regímenes sobre los mismos 80 elementos reservados, con compuerta aplicada.
- pass@k frente a pass^k para k = 1, 2, 4, 8 — 100 tareas, 8 ejecuciones cada una.
- Los dos errores combinados: los mismos ensayos calificados por un juez imparcial, uno sesgado y uno calibrado.
- La celda Goodhart: el juez que siempre devuelve PASS, y la
{}última aparición del agente del Episodio 1.
[EVIDENCE] Las dos tablas que sostienen el resto de este episodio, impresas por la corrida:
held-out items: 80   (the 20 calibration items are excluded)
judge                      kappa     agree  measured pass
naive, one pass            0.585     64/80          0.738
+ swapped position         0.726     69/80          0.475
+ calibration set          0.899     76/80          0.537
golden labels (truth)      1.000     80/80          0.537
  gate kappa >= 0.60: naive, one pass        FAIL  (0.585)
  gate kappa >= 0.60: + swapped position     PASS  (0.726)
  gate kappa >= 0.60: + calibration set      PASS  (0.899)

100 tasks, k=8 trials each, per-task success probability drawn in [0.25, 0.95]
  k    pass@k    pass^k       gap
  1     0.570     0.570     0.000
  2     0.750     0.360     0.390
  4     0.900     0.120     0.780
  8     0.990     0.030     0.960
Dos movimientos, sin cambiar el juez, κ de 0.585 a 0.899. Y abajo: el mismo agente, las mismas 800 ejecuciones, reportadas como 0.990 o 0.030. Ambas son ciertas; solo una refleja lo que experimenta una persona usando el sistema.
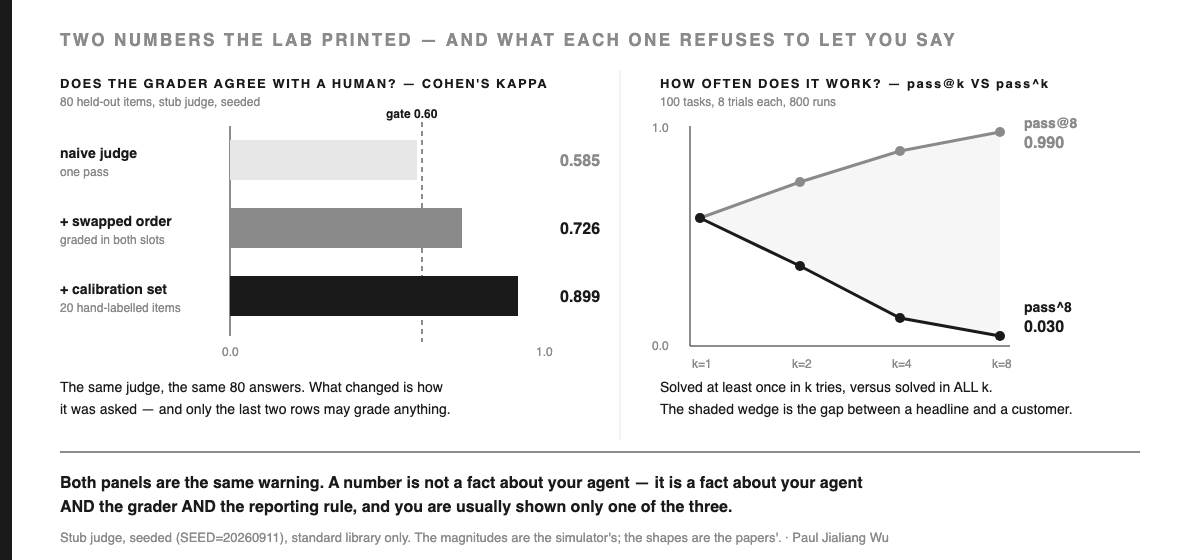
[DESIGN] Por qué usar un stub y no un modelo real. Un simulador reproduce dónde entra el error y qué lo corrige, en segundos, gratis, sin clave. no reproduce magnitudes: nada de lo que imprime es evidencia para el 80% de acuerdo de Zheng et al. ni para el pass^8 menor al 25% de τ-bench, ambos medidos en sistemas reales y solo citables a los artículos. El puente es corto: basta cambiar judge_score() por una llamada a cualquier endpoint compatible con OpenAI y nada más cambia, porque el código de medición no sabe a qué está apuntando.
Proyectos
Dos desarrollos, desde cero — solo con la biblioteca estándar. Ambos se ejecutaron antes de escribir esta sección, así que cada número es medido, no predicho.
Proyecto 1 — vida real:the-report-card
p1_report_card.py · python3 p1_report_card.py
Un registrador de hábitos anota una línea diaria; un juez la revisa y decide si mantuviste el hábito. Etiqueté 60 días a mano. La pregunta no es qué tan bueno es mi agente, sino qué tan confiable es lo que me dijo qué tan bueno era mi agente.
the-report-card - grading the grader of a habit tracker
  golden set        : 60 days labelled by hand
  calibration       : 10 days re-read, 50 days graded
  note-length offset: estimated +0.284, true +0.320

  grader                     kappa    gate   measured streak
  before calibration         0.572    FAIL             0.680
  + swapped batch order      0.797    PASS             0.400
  + 10-day calibration       0.960    PASS             0.440
  my own labels              1.000       —             0.460
[EVIDENCE] La aplicación me aseguró que cumplí el hábito en 68% de los días. En realidad, lo cumplí en 46%. Se equivocó en los días, y se equivocó a mi favor—por eso nunca lo había revisado. Me venía felicitando por un error de redondeo con buenos modales.
Las dos distorsiones son las de Zheng et al., pero en versión casera. El registrador muestra primero lo más reciente, así que la misma nota puntúa más alto arriba de un lote que abajo: sesgo de posición. Una nota con un número — "corrí 5.2 km" — parece más creíble que "salí a correr", haya ocurrido o no: sesgo de verbosidad. Diez días re-leídos a mano estimaron el segundo en +0.284 frente a un verdadero +0.320.
Proyecto 2 — empresa:the-audit-bench
p2_audit_bench.py · make report · make gate · make negative
Un agente de resolución de soporte evaluado con 120 tickets cuyo resultado fue escrito por una persona: 24 reservados para calibración, 96 evaluados. El harness no confía en el juez: lo mide, publica el número y falla la build cuando el juez no es suficientemente bueno o un ítem no medido se cuenta como aprobado.
  kappa, single pass, raw   : 0.455   <- what a one-shot judge gives you
  kappa, calibration, before: 0.577   <- FAILS the 0.60 gate
  kappa, calibration, after : 1.000   on the 22 of 24 calibration tickets the harness could measure
  measured / unmeasured     : 80 / 16   (coverage 0.833)
      order-dependent               14
      inside the uncertainty band    2
  pass rate, measured only  : 0.500
  pass rate, if UNMEASURED were counted as passes: 0.583   <- the number the gate refuses

gate
  PASS  kappa on the calibration set >= 0.60         1.000
  PASS  coverage >= 0.70                             0.833 (80/96 measured)
  PASS  no UNMEASURED item is counted as a pass      0 leaked
  => green
[EVIDENCE] Compara 0.500 y 0.583 lado a lado. La tasa de aprobación honesta es 0.500 sobre los 80 tickets que el harness pudo medir; la halagadora es 0.583, y lo único que cambió fue si 16 tickets indecidibles se contaron discretamente como éxitos. Un salto de 8.3 puntos, gratis para cualquiera que nunca implementa un tercer estado: no hace falta mentir, basta con un tipo de dos valores donde el mundo tiene tres.
make gate termina con 0.make negative reintroduce el defecto y requiere terminar con 1:
gate  (negative test: unmeasured items deliberately counted as passes)
  FAIL  no UNMEASURED item is counted as a pass      16 leaked, first: TCK-1029, TCK-1034, TCK-1035
  => RED          # exit 1
Una compuerta que nunca ha estado en rojo es indistinguible de no tener compuerta—una regla que aprendí en otra temporada, ahora instalada en un banco de pruebas cuyo tema entero es no confiar en los instrumentos.
Constrúyelo en 30 minutos — el contrato
Todo lo que necesita el banco de evaluación, en el orden en que lo pide una persona ingeniera. Entradas: N elementos con resultados escritos por una persona. Salida: exactamente uno de PASS · FAIL · UNMEASURED. Regla base: sin evidencia significa no medido, nunca un pase. Regla de parada: la compuerta falla la ejecución; no hay reintentos.
GOLDEN   = [(item, human_label), ...]        # a human wrote these, not the model
CAL, TEST = GOLDEN[:24], GOLDEN[24:]         # calibration is HELD OUT of the score

def verdict(item, offset):
    a = judge(item, candidate_first=True)    # score, not a verdict
    b = judge(item, candidate_first=False)   # the SAME item, other order
    a, b = a - bias(item, offset), b - bias(item, offset)
    if (a >= T) != (b >= T):      return UNMEASURED, "order-dependent"
    if abs((a+b)/2 - T) < BAND:   return UNMEASURED, "inside the band"
    return (PASS if (a+b)/2 >= T else FAIL), "two orders agreed"

offset = mean(score | long, label=g) - mean(score | short, label=g)   # over CAL, per g

# CI gate (make gate)
#   kappa(verdicts, human_labels) on CAL   >= 0.60   else UNCALIBRATED
#   coverage = measured / graded           >= 0.70   else vacuously green
#   UNMEASURED items counted as passes     == 0      (make negative proves it bites)
# any line below threshold -> exit 1 -> the build fails
Deliberadamente fuera: un modelo en vivo (sustituye judge() por cualquier endpoint), explicaciones por elemento y un tercer juez para desempatar. Ese último es una decisión, no un olvido — un empate es información. Eso indica que este elemento no es decidible por este juez, y UNMEASURED es el registro honesto. Un desempate convierte un desconocido conocido en un conocido desconocido, lo cual es peor.
[DISEÑO] Cuatro propiedades hacen que esto sea apto para empresa y no solo una demo:
- Los elementos de calibración se excluyen del cálculo del puntaje. Un calificador ajustado sobre los elementos que califica no tiene conjunto de validación — justo el defecto que señala Kapoor et al. Los 24 tickets de calibración nunca entran en la tasa de pase.
- La cobertura es una compuerta, no solo un reporte. Sin un piso, un harness puede alcanzar cualquier kappa que quieras declarando casi todo como no medible — una compuerta que aprueba midiendo nada.
- El tercer estado es un tipo, no una convención.
UNMEASUREDlo devuelve la misma función que retornaPASS, así que ningún llamador puede olvidar que existe. Las convenciones se degradan; los tipos no.
[ABIERTO] Lo que ninguno de los proyectos demuestra. Ambos golden sets son sintéticos y ambos jueces son stubs. El kappa de 1.000 del banco de evaluación está sobre 22 elementos — la banda de incertidumbre haciendo su trabajo, no un calificador perfecto, y con n = 22 no puede distinguir excelente de afortunado. Eso es exactamente el 1.000 sin alcance que esta temporada ha advertido dos veces, en mi propio output. Estado honesto: ejecutable y con compuerta, no desplegado ni medido. Lo que lo haría real: tickets de una cola viva con sus resoluciones reales, y un segundo etiquetador humano, así que la kappa entre humanos marca el techo en vez de un 1.000 implícito.
La misma historia, cinco salidas posibles
Un solo eje central, una puerta para cada lector. Toma una decisión y una acción.
| Si eres | La decisión que este episodio cambia | Una acción para esta semana |
|---|---|---|
| un estudiante de preparatoria | "The eval passed" is not a fact until you say who graded it and how often it worked. (Traducción: “La evaluación pasó” no es un hecho hasta que digas quién la calificó y cuántas veces funcionó.) | Ejecuta el laboratorio en Colab (2 segundos, sin clave), luego etiqueta a mano 20 respuestas de cualquier chatbot y calcula la kappa contra sus propias autoevaluaciones. |
| un ingeniero de IA | La precisión de tu agente está limitada por el acuerdo de tu calificador, y tu calificador hoy ni siquiera está medido. | Etiqueta a mano 20 ítems, mide la kappa y añade la compuerta del contrato anterior a un trabajo de CI. |
| un fundador | Un número de benchmark son tres hechos bajo un solo disfraz; el halagador es gratis y el honesto cuesta un golden set. | Pídele a tu equipo pass^k junto a pass@k en tu flujo principal. Si nadie tiene k, ese es el hallazgo. |
| un ejecutivo | La confiabilidad es una pregunta de auditoría: ¿qué fracción de ítems fueron medidos, y quién escribió las etiquetas? | Agrega "cobertura y acuerdo entre etiquetadores" a la próxima revisión de calidad, junto a precisión. |
| un inversionista | La verdadera ventaja está en el golden set y el calificador calibrado, no en el modelo que un equipo renta ni en la fila de leaderboard que compró. | Pide a cualquier startup de agentes la kappa contra etiquetas humanas y pass^k junto a pass@k. Uno sin el otro es puro teatro. |
Misión Realidad
Veinte minutos, aplicado a algo que ya usas.
- Elige una salida de IA en la que realmente confíes: un resumidor, un enrutador, un revisor de código o un registrador de hábitos.
- Reúne 20 resultados reales y etiquétalos tú mismo, antes de ver cualquier puntuación que el sistema se haya asignado. Aprueba o reprueba.
- Obtén los propios veredictos del sistema sobre esos mismos 20 y calcula el kappa de Cohen — seis líneas de cuentas, en la celda 1 del notebook.
- Cuenta cuántos de los 20 no pudiste etiquetar con seguridad. Ese número es tu problema de cobertura.
- Si tu evaluador es un modelo, muéstrale cinco ítems en ambos órdenes y cuenta cuántas veces cambia de veredicto. En mi laboratorio fueron 50 de 100.
Si el paso 2 es el difícil, acabas de aprender lo más valioso: tu equipo no tiene una definición de correcto que sobreviva el contacto con una persona, y ningún trabajo en los otros cinco escalones va a suplirla.
Desafío de investigación
Entrégale esto a un agente y deja registrada tu predicción antes de ejecutarlo.
Toma una familia de tareas con salida verificable y arma un golden set de 100 ítems etiquetados de forma independiente por dos personas. Reporta: kappa inter-humano (el techo); el kappa del juez-modelo contra cada humano; el cambio en ese kappa bajo (a) re-evaluación con posiciones intercambiadas, (b) una corrección de calibración de 20 ítems, (c) ambas. Luego reporta pass@k y pass^k para k = 1, 2, 4, 8 bajo las etiquetas humanas y bajo el juez-modelo por separado, además del costo por cada ítem evaluado.
Deja registrado: si el kappa del juez contra un humano supera el kappa entre los dos humanos, y si el error del juez afecta más a pass^k que a pass@k.
Mi predicción, registrada antes de que lo ejecutes: el kappa inter-humano será el techo real y más bajo de lo que la mayoría espera, y el sesgo del juez distorsionará pass^k por varios múltiplos mientras apenas toca pass@k. Si obtienes lo contrario, eso es un desacuerdo publicable, no un bug en tu configuración.
Qué cambió
Estado de este escalón al momento de publicación, según una sincronización semanal en vivo de 30 fuentes pioneras en research-anything (make watch-sync), ordenadas por señal técnica, nunca por alcance de audiencia. Cada ítem se extrajo de su página de resumen en la fecha de sincronización.
Fecha de sincronización: 2026-09-11.
- arXiv:2609.11067 (2026-09-10) — Cuando el ruido fabrica sesgo.Cinco condiciones de ruido sobre 3,822 respuestas relacionadas con estereotipos: los errores tipográficos y la puntuación incorrecta tienen muchísima más probabilidad de transformar juicios neutrales sobre sesgo social en juicios sesgados que al revés, con una diferencia de hasta 120×. Este hallazgo tenía solo un día al momento de publicación, y lleva el episodio un nivel más profundo: incluso la medición del sesgo es un instrumento con su propio margen de error.
- arXiv:2608.29463 (2026-08-29) — Benchmark Contamination: A Taxonomy Organized by Defeated Mitigation.Cinco tipos de contaminación, clasificados según la mitigación que logran superar; un conjunto de reserva privado solo resuelve el primero. Dos codificadores externos aplicaron el instrumento a 41 documentos y la kappa ponderada por variable osciló entre 0.00 y 0.35 — un artículo sobre medición lo bastante honesto como para publicar su propio bajo acuerdo entre codificadores.
- arXiv:2608.26623 (2026-08-27) — AgentJudgeBench.3,808 instancias, seis jueces desde 20B hasta frontera. La alineación se degrada a medida que aumenta la dificultad de la tarea, 1.5× más rápido si no hay ground truth, y en consultas difíciles sin ground truth los seis convergen en una banda del 77–82% sin importar la escala. Las rúbricas estructuradas suman hasta 6.5 puntos; ni el chain-of-thought ni la temperatura del juez aportan nada.
- arXiv:2608.24314 (2026-08-25) — Benchmarking LLM Judges for Voice-Agent Evaluation.Las mismas interacciones bajo tres configuraciones de evaluación: la confiabilidad del juez resulta depender de la métrica y la configuración, no de una propiedad intrínseca del propio juez. El argumento de calibración, importado del mundo de las telecomunicaciones.
- Un día fuera de la ventana, pero lo incluyo igual: arXiv:2608.11434 (2026-08-11) — MobileJudgeBench, 931 trayectorias anotadas por humanos: un juez base simple suele superar a pipelines diseñados a medida.
[OPEN]Lo que no ha cambiado: no encontré ningún trabajo publicado que mida cuánto cambia un juez calibrado los resultados de un sistema en producción. Todos los resultados anteriores miden al juez contra etiquetas, nunca la consecuencia de que el juez se equivoque. Esa es la brecha que señala el Research Challenge de este episodio, y no logré cerrarla desde la literatura.
Prueba final
Sin hacer scroll.
- Nombra los seis peldaños en orden, y por qué el sexto quedó sin nombre durante cinco episodios.
- Tu calificador coincide con tus etiquetas en 79 de 100 ítems. ¿Por qué eso no basta, y qué número deberías buscar?
- ¿Una puntuación de benchmark reportada es un hecho conjunto sobre cuáles tres cosas, y cuál de ellas es la que normalmente ves?
- ¿Por qué un sesgo fijo en la dirección del juez afecta mucho más a pass^k que a pass@k?
- Un ítem que tu juez no puede decidir: ¿cómo debería registrarse, y qué falla si eliges cualquier otra opción?
- Nombra una entrada degenerada que maximiza una métrica que reportas, y la segunda métrica que la dejaría en evidencia.
Cliffhanger — y así termina la temporada
Armas el golden set y lo etiquetas tú mismo, a mano, un domingo. Tu juez vuelve con 0.899, cómodamente por encima del umbral. Conectas el banco de evaluación a CI, ves cómo la prueba negativa se pone roja, luego verde. Por una tarde crees que resolviste la cocina — que, a estas alturas, es justo el sonido que hace esta serie antes de que algo se venga abajo.
Y entonces alguien lanza una pregunta que tu pila de seis peldaños no sabe responder: ¿debería este agente haber tenido permiso para hacer eso en primer lugar?
No "¿lo hizo correctamente?" — cada peldaño que tienes responde eso. Si la acción fue permitida. Por quién, bajo qué autoridad, registrado dónde. Tu kappa es excelente y no tiene nada que decir, porque un evaluador calibrado te dice si la respuesta coincidió con la etiqueta, pero no si esa etiqueta debió ser el objetivo.
Eso es una costura, no un peldaño — una pregunta para la siguiente X, no para el próximo episodio.Gobernanza es el candidato más fuerte después de la evaluación: quién puede cambiar el golden set, quién autoriza cuando se salta la compuerta, cuál es la trazabilidad cuando un agente actúa; luego economía, luego organización. Candidatos para una temporada futura, en el mismo tono que usó el Episodio 1 para esta: registrado, argumentado después, prometido nunca.
El verdadero cierre de la temporada es más breve. Seis peldaños, una frase cada uno, siempre con la misma estructura: el prompt es una especificación, el contexto es un presupuesto, el harness es un sobre, el loop es un árbitro, el grafo es un calendario, y la evaluación es la función de verdad. Ninguno es un hechizo. Los seis son cosas que dejas por escrito — y el último es el único que puede decirte si los otros cinco valieron la pena. Empieza ahí la próxima vez. Es el peldaño que todos construyen al final, y el que sostenía todo lo demás.
Próximas lecturas
Episodio 6 de Intelligence Engineering Adventures, Temporada 7 — La Escalera de la Cocina, y el cierre de la temporada. Las afirmaciones en la fuente de la serie están clasificadas por tipo — definición, derivación, evidencia, decisión de ingeniería, pregunta abierta — y una metáfora puede introducir una afirmación, pero nunca sirve como evidencia de ella. Cada episodio incluye un notebook de Colab que corre en el nivel gratuito sin API key, más dos aplicaciones hechas desde cero: una personal y otra con enfoque empresarial. La escalera de cinco peldaños es de Feng et al. (arXiv:2608.21156), no mía; el sexto peldaño se nombra aquí, después de que un revisor externo lo propuso el 2026-09-05 y el Episodio 1 lo registró como candidato abierto. La sección "qué se movió" se genera a partir de una sincronización semanal en vivo de 30 fuentes pioneras, ordenadas por señal técnica y nunca por alcance de audiencia. Este artículo no contiene material de ningún empleador ni cliente. — Paul Jialiang Wu · futuremake.io
Referencias
- Kapoor, S., Stroebl, B., Siegel, Z. S., Nadgir, N., Narayanan, A. (2024). AI Agents That Matter. arXiv:2407.01502, enviado el 2024-07-01. — citado textualmente de la página del resumen en arXiv (leído el 2026-09-11): el enfoque estrecho en la precisión, las necesidades de benchmarking mezcladas y los conjuntos de validación insuficientes.
- Zheng, L., Chiang, W.-L., Sheng, Y. et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. arXiv:2306.05685, v4 revisado 2023-12-24. — citado textualmente de la página del resumen en arXiv: los tres sesgos nombrados y la cifra de acuerdo superior al 80%.
- Yao, S., Shinn, N., Razavi, P., Narasimhan, K. (2024). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv:2406.12045, enviado el 2024-06-17. — citado textualmente de la página del resumen en arXiv: pass^k, y pass^8 por debajo del 25% en retail.
- Liang, P., Bommasani, R., Lee, T. et al. (2022). Holistic Evaluation of Language Models. arXiv:2211.09110, v2 revisado 2023-10-01. — resumen leído para las cifras de cobertura de escenarios del 17.9% → 96.0% y las siete métricas.
- Chang, Y., Wang, X., Wang, J. et al. (2023). Una revisión sobre la evaluación de modelos de lenguaje grandes. arXiv:2307.03109, v9 revisado 2023-12-29. — resumen consultado para el marco de qué/dónde/cómo y el argumento de "la evaluación como disciplina".
- Jimenez, C. E., Yang, J., Wettig, A. et al. (2023). SWE-bench: ¿Pueden los modelos de lenguaje resolver issues reales de GitHub? arXiv:2310.06770, v3 revisado 2024-11-11. — resumen consultado para las 2,294 tareas y la cifra del 1.96%.
- Husain, H. (2024-03-29). Your AI Product Needs Evals. hamel.dev/blog/posts/evals/. — citado textualmente del post en vivo (leído 2026-09-11): la causa raíz común de los productos LLM fallidos.
- Anthropic (2026-01-09). Demystifying evals for AI agents. anthropic.com/engineering. — citado textualmente del post en vivo: la definición de eval, y las evals automatizadas en CI/CD.
- OpenAI. Evals. github.com/openai/evals. — repositorio consultado 2026-09-11; descrito, no citado.
- Angulo, J., Yeste, V., Espinos-Morato, H. (2026). Contaminación de benchmarks: una taxonomía organizada por mitigación derrotada. arXiv:2608.29463, enviado 2026-08-29. — citado textualmente de la página de resumen en arXiv: "Leaderboards publish the model and the score, so capability and leakage stay observationally equivalent" (Traducción: Los rankings publican el modelo y la puntuación, así que la capacidad y la fuga permanecen indistinguibles a simple vista).
- Verma, A., Saha, A. K., Subramanian, S., Aluru, S. H. (2026). AgentJudgeBench: Un benchmark de dificultad múltiple para evaluar jueces LLM en llamadas de herramientas agénticas. arXiv:2608.26623, enviado el 27-08-2026. — se consultó el resumen para la banda del 77–82% y el efecto de la rúbrica.
- Purwar, A., Singh, S., Srivastava, K. (2026). Evaluación de jueces LLM para agentes de voz: confiabilidad, calibración y supervisión humana. arXiv:2608.24314, enviado el 25-08-2026. — se consultó el resumen.
- Ryu, D., Lee, J., Hwang, Y., Bak, J. (2026). Cuando el ruido fabrica sesgos: la fragilidad de la medición de sesgo en LLM-as-a-Judge bajo texto ruidoso. arXiv:2609.11067, enviado el 10-09-2026. — se consultó el resumen por la asimetría de 120×.
- Wang, Z., Gu, L., Chi, Z. et al. (2026). Evaluación de jueces LLM para agentes móviles. arXiv:2608.11434, enviado el 11-08-2026. — se consultó el resumen; fechado un día fuera de la ventana de "qué cambió" de este episodio y señalado como tal.
- Goodhart, C. A. E. (1984). Problemas de gestión monetaria: la experiencia del Reino Unido. En Monetary Theory and Practice, Palgrave, Londres. link.springer.com. — el artículo de 1975 reimpreso; de acceso restringido, por lo tanto descrito y no citado textualmente.
- Strathern, M. (1997). 'Improving ratings': auditoría en el sistema universitario británico. European Review 5(3), 305–321. doi:10.1017/S1062798700002660. — fuente del eslogan comúnmente atribuido a Goodhart; acceso restringido, por lo tanto se describe pero no se cita.
- Landis, J. R., Koch, G. G. (1977). The Measurement of Observer Agreement for Categorical Data. Biometrics 33(1), 159–174. doi:10.2307/2529310. — fuente de las bandas convencionales de kappa; acceso restringido, por lo tanto se describe pero no se cita.
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. (2026). Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2, revisado 2026-08-26. — la escalera de cinco peldaños que esta temporada amplía con uno más.
- Dhage, S. (2026). Harness Engineering for Predictable Agentic Systems. arXiv:2608.26197, 2026-08-25. — Medición central del Episodio 1, citada aquí por la métrica de determinismo que marca 1.000 en una respuesta vacía.
- Wu, P. J. (2026-08-06). One Opinion Wearing Ten Hats. futuremake.io. — trabajo propio publicado: un panel es una función de puntuación, y toda función de puntuación se calibra contra algo externo o se etiqueta como no calibrada.
- Wu, P. J. (2026-08-21). The Rubric That Could Not Fail. futuremake.io. — trabajo propio publicado: una puntuación perfecta de 23 sobre 23 que resultó ser el error, y el criterio hostil que llevó a un honesto 25 de 28.
- Wu, P. J. (2026-07-23). Verifica a tu verificador. futuremake.io. — trabajo propio publicado: de aquí sale la regla de harness que fundamenta este episodio — una afirmación solo se verifica si su cita resuelve y la evidencia respalda la fuerza reclamada; de lo contrario, baja a no probada.
- Wu, P. J. (2026-09-11). Lab 06 — La función de verdad: deriva del juez y pass^k, con
the-report-cardythe-audit-bench. gist.github.com/wjlgatech/752a9450…. — todos los números en las secciones Notebook y Proyectos provienen de estas ejecuciones, realizadas el 2026-09-11 antes de la publicación.