AI 原生系列 · 推销智能体化 AI,第二篇(共三篇)
这个销售季怎么卖智能体:有边界、担责任、重证据
一分钟摘要
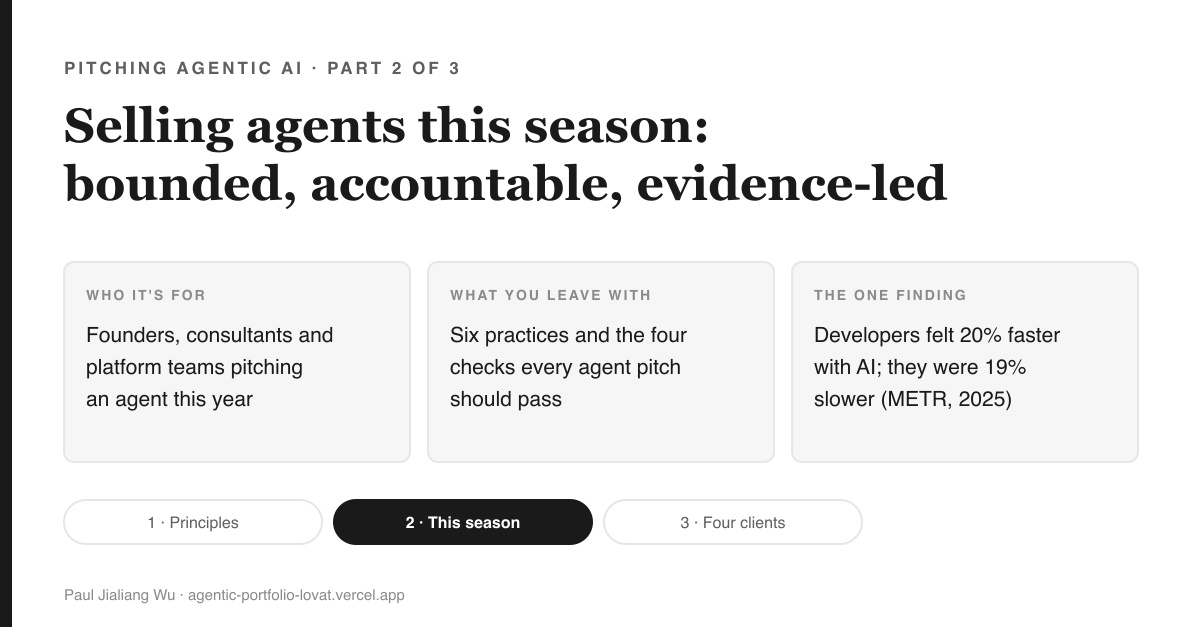
这篇讲什么。 本系列第二篇:这个阶段该怎样推销 AI 智能体,以及每次推销都该通过的四项检查:具体、如实估量、有人担责、提前定好度量标准。
为什么重要。 在一项 2025 年的随机对照试验中,经验丰富的开发者用 AI 工具反而慢了 19%,事后却仍然相信自己快了 20%(METR)。笼统的「生产力提升」承诺,恰恰是证据最撑不住的说法。
读完之后你能做什么。 把你写的四行说法拿去过一遍这四项检查,然后为那个能说「不」的人写一句话:这个智能体能碰什么、谁来批准。
Pitching Agentic AI — 系列脉络
- 比任何推介都更长寿的原则 第 1 集
- 这一季该怎么推介智能体 本集
- 四位客户,四套首发工作流 第 3 集
标签说明:EVIDENCE 代表有据可查,DESIGN 代表推荐做法,OPEN 代表尚未验证,而 LENS 代表我自己的判断。
企业里的 AI 试点常常卡住,而卡住的原因,很大一部分出在立项的范围没划对。2025—26 年的六条实践,都围绕一个念头展开:选一个卡住的工作流,让事先谈好的配对指标去替你完成销售。而那个意外之处在于:关于 AI 编程工具的那些做得最好的试验,彼此的结论并不一致。
本篇内容:眼下该怎么推介一个 AI 智能体
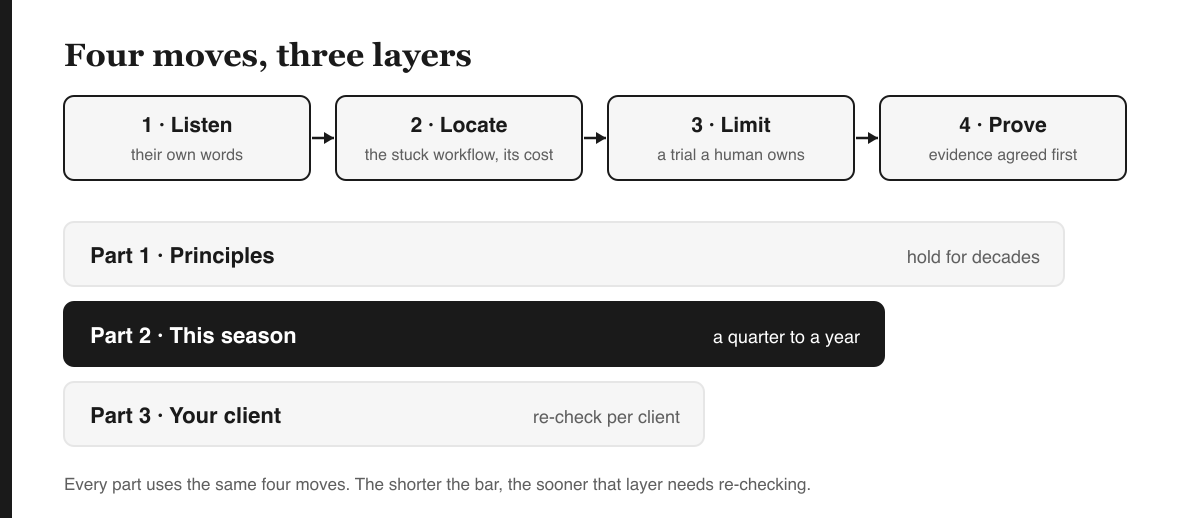
第一篇里的原则几乎不变。而这一层,大约每年都会变一轮:买家怎么买、证据目前怎么说、他们在治理上会问些什么。这一篇写给今年要把智能体推介进企业的任何人——无论你是创业者、顾问,还是内部平台团队。我在 Accenture 工作,下文援引的研究里有一项正来自那里;提到的地方我会说明。这里的一切都是我自己从公开资料中整理出的综合判断。
先下一个赌注
在 2025 年的一项随机对照试验中,经验丰富的开源开发者在自己的代码仓库里完成真实任务,分别用和不用 AI 工具。开始之前,他们预测用了 AI 之后大约能快 24%。而实际用上 AI 之后,他们完成任务所花的时间:
- A. 大约少了 20%。
- B. 耗时基本持平。
- C. 多花了约 19% 的时间。
实践一:先审查资质,再推销
EVIDENCE 企业销售界早就把这套流程规范化了。MEDDIC 是一套从业者们追溯到 1990 年代 PTC 公司的检查清单,它要求明确指标、找到有预算决策权的买家、决策标准、决策流程、痛点所在,以及一位内部支持者。它的起源说法只是业内传闻,细节上并未经过证实,但它之所以流传至今,原因很朴素:一笔没人负责、也没有共识衡量标准的交易,无论演示做得多漂亮,通常都谈不成。
DESIGN 对于一次智能体试点,我会自己再加四个问题。结果有没有明确的负责人?团队能否提供访问权限与上下文信息?有没有留出时间来判断产出质量的评审人?这项工作是否足够可重复,以便界定范围、加以核验?只要缺了一项,就该停下来先补上,而不是硬着头皮往前推。
实践二:在压力之下,先选定一个工作流
DESIGN 卡壳的工程工作,往往逃不出四种样子。我把它们称为「四个 R」:
| 卡壳的工作表现为 | 典型症状 | 一个有边界的首个任务 | |---|---|---| | 等待(Waiting) | 评审与审批排起长队 | 按团队自有清单做一轮初审 | | 返工(Redoing) | 返工、测试不稳定、流水线反复重跑 | 为某一服务排查失败的 CI 运行 | | 重新学习(Relearning) | 人与人之间的上下文丢失、没人懂的老代码 | 以只读方式解释并记录一个遗留模块 | | 重复解释(Re-explaining) | 交接、过期文档、反复被问同样的问题 | 根据一次事故的历史记录起草一份处理手册 |
选一行,针对一个团队就好。不要窄到只是自动补全,也不要宽到全公司自动化——那只是第 7 页 PPT 加了预算而已。
实践三:对每个能点头或摇头的人,说对的话
DESIGN 同一个卡住的工作流,在四种人眼里意味着不同的东西:
- 预算负责人(CTO、工程副总裁):产能、质量、发布信心。
- 平台负责人: 一致性、开发者体验、减少重复排查。
- 进度负责人(产品):更少的承诺延误、更可预测的发布节奏。
- 能说「不」的人(安全、风险、质量):智能体能碰什么、谁来审批、记录了什么。
大多数提案都顾及了前三种人。在我见过搁浅的那些交易里,问题通常出在第四种人身上——从头到尾都没人对他们说清楚一句话。
实践四:只主张证据能撑住的部分
EVIDENCE 回到之前的赌局,答案是C。在 METR 的 2025 年随机对照试验中(16 名经验丰富的开发者,在自己的代码仓库里完成 246 项任务),允许使用 AI 工具反而让任务多花了 19% 的时间,而开发者事后仍然相信 AI 让他们快了大约 20%(Becker et al., METR, 2025)。METR 后来表示,一次重新测试只得到了微弱的信号,因为许多开发者已经不愿意再脱离 AI 工作;METR 现在认为,开发者实际获得的提速可能比以前估计的更明显(METR, Uplift update,2026年2月).
EVIDENCE 另一面的证据:在三家公司(包括我任职的 Accenture)进行的实地实验,覆盖 4,867 名开发者,发现使用 AI 代码补全工具后,完成的任务量(指 pull request 数量,而非笼统的「生产力」)增加了约 26%,经验较浅的开发者提升幅度更大(Cui et al., The Effects of Generative AI on High-Skilled Work, 2024–25)。Google 的 2025 年 DORA 调查覆盖约 5,000 名从业者,发现 AI 使用与更高的吞吐量相关,但同时也与更低的交付稳定性相关:AI 会放大已经存在的东西(DORA 2025 announcement).
DESIGN 只要按场景和年代分别看,这些结果其实并不矛盾:2022—23 年面向广泛人群的代码补全、2025 年初针对成熟代码库中资深开发者的工具、以及整个交付系统——说的根本不是一回事。这正是为什么「开发者生产力」是个错误的承诺,而带有事先约定衡量标准的、针对具体工作流的主张才是诚实的做法。
实践五:把速度信号和质量信号配对使用
EVIDENCE 一个试点项目能否真正走到生产环境,很大程度上取决于它是怎么搭建的。MIT NANDA 2025 年的研究基于访谈、问卷与公开实施案例,报告称 "external partnerships with learning-capable, customized tools reached deployment ~67% of the time, compared to ~33% for internally built tools,"(中译:与具备学习能力、经过定制的工具开展外部合作,部署成功率约为 67%,而内部自建工具的成功率仅约为 33%),报告本身也说明这些数字均由受访者自行呈报,未经第三方核实(MIT NANDA, The GenAI Divide, 2025;此处引用的是该报告在网上流传的一个版本)。报告中常被引用的「95%」,统计的其实是回报为零的组织,而不是失败的试点项目。
EVIDENCE 各家厂商正把定价逐渐转向按结果付费:Intercom 为其 Fin 智能体按每次解决收费 $0.99(Intercom pricing),Salesforce 的 Agentforce 则按对话次数或操作次数计费(Agentforce pricing)。但「结果」具体怎么定义,都是厂商自己说了算。
DESIGN 这就是「验证」这一招见真章的地方。要同时商定速度信号和质量信号,包括达标线是什么、由谁来看:评审周转时间要配上漏网缺陷数,文档撰写时间要配上测试是否原样通过。只看速度是可以被糊弄的——评审一旦求快就会变浅,大家都在庆祝,直到事故复盘会上才现原形。
实践六:让试点的边界回答治理问题
EVIDENCE 买家如今上门时都带着一份治理清单。欧盟《人工智能法案》自2025年8月起已对通用人工智能模型施加相关义务(EU AI Act implementation timeline),而 NIST 的人工智能风险管理框架则是美国通行的参照标准(NIST AI RMF).
DESIGN 一个边界清晰的试点,光凭它的边界就能回答大多数治理问题。讲清楚智能体能碰什么、每项输出由谁审批、记录了什么日志,以及专家何时会检查配置与管控措施。如果「它能碰什么」这个问题的答案要用一整段话才说得完,那这个试点就定得太大了。
推销之前的四项检查
- 具体: 一个工作流,一个团队。
- 诚实估量: 说「或许值得评估」,而不是承诺一场变革。
- 有人担责: 质量与审批的责任,始终由工程师承担。
- 提前定好度量: 一个速度信号加一个质量信号,达标线在开始前就商定好。
这套方法可能在哪里失灵
- 证据还在变化。 METR 自己的结论几个月内就修正过一次。本文提到的任何数字,你读到时都可能已经过时,引用前请先核对日期。
- 「资质审查」也可能变成借口。 「还没准备好」有时候是真的,有时候只是销售在回避一个难啃的客户。把是哪个问题没过关、什么时候会再问一次,都写下来。
- 那第四个人依然会说「不」。 企业多快能定下自己的 AI 政策,眼下还是未知数;小范围试点有帮助,但消除不了这段等待期。
- 四 R 是我个人的观察框架,不是什么定律。 它们归纳的是我见过的卡点工作;你客户的情况未必对得上号,这一点最好早点弄清楚。
这周就能做的事
拿出你在第一篇写下的那四句话,用这四项检验过一遍。然后为那个「有权说不」的人写一句话:智能体能碰什么,谁来审批。如果这句话写不出来,就说明你还没准备好提试点。
下期预告
第三篇会把这一切落到四个出错代价最高的行业上:金融服务、生命科学、工业制造,以及科技与电信。每个行业都会讲清楚痛点、责任人、规则,以及一个合适的起步工作流。
参考资料
- Becker, J., et al. "Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity." METR, arXiv:2507.09089, July 2025.(中译:《衡量 2025 年初 AI 对资深开源开发者生产力的影响》,METR,arXiv:2507.09089,2025 年 7 月。)
- METR. "Uplift update." 24 February 2026.(中译:《提升幅度更新》,METR,2026 年 2 月 24 日。)
- Cui, Z., Demirer, M., Jaffe, S., Musolff, L., Peng, S., Salz, T. "The Effects of Generative AI on High Skilled Work: Evidence from Three Field Experiments with Software Developers." SSRN 4945566 (2024; revised 2025).(中译:《生成式 AI 对高技能工作的影响:来自三项软件开发者现场实验的证据》,SSRN 4945566,2024 年发表,2025 年修订。)
- Google Cloud. "Announcing the 2025 DORA report." 23 September 2025.(中译:《2025 年 DORA 报告发布》,Google Cloud,2025 年 9 月 23 日。)
- MIT NANDA. "The GenAI Divide: State of AI in Business 2025." July 2025.(中译:《生成式 AI 的鸿沟:2025 年企业 AI 应用现状》,MIT NANDA,2025 年 7 月。)
- Intercom,定价页面;Salesforce,Agentforce 定价页面。两者均于 2026 年 10 月查证;价格常有变动。
- EU AI Act implementation timeline (artificialintelligenceact.eu)(中译:《欧盟人工智能法案实施时间表》,artificialintelligenceact.eu);NIST AI Risk Management Framework 1.0, January 2023.(中译:NIST《人工智能风险管理框架》1.0 版,2023 年 1 月。)
- 来源说明:本文的写作契机,是作者在 2026 年参加的一场编码智能体赋能培训;文中的实践方法、表格与检验项,均为作者本人基于上述公开资料的归纳整理。