AI 原生系列 · 推销智能体化 AI,第 3 篇(共 3 篇)
四类客户,四种首发工作流
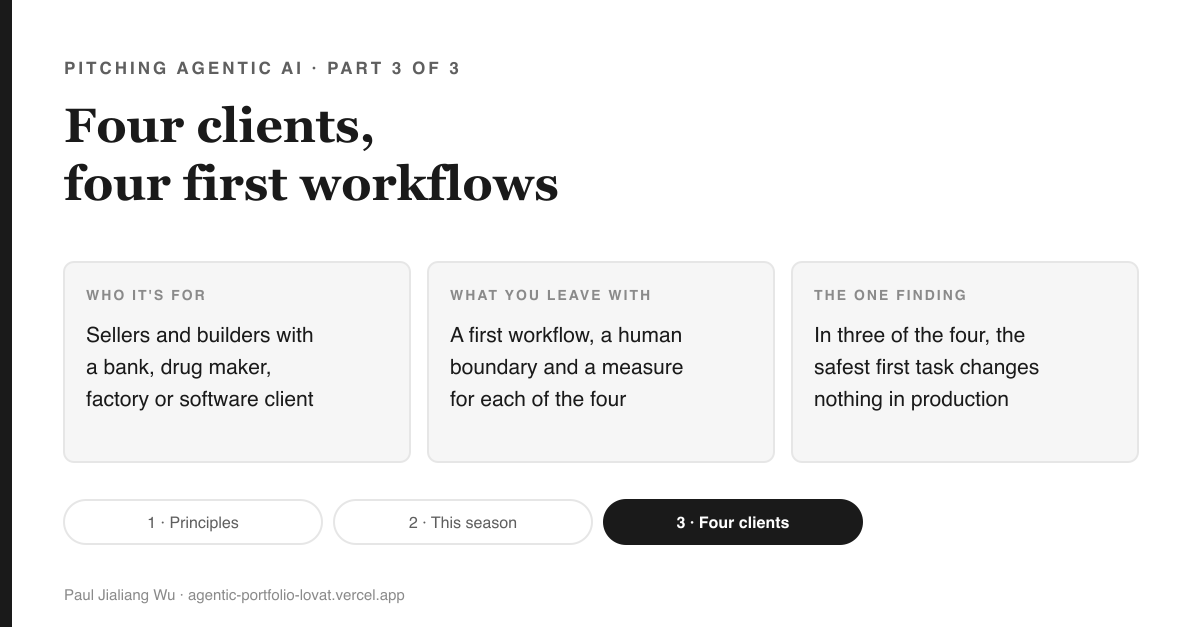
一分钟摘要
这是什么。 本系列第 3 篇:面向四类客户,各自给出一个有边界的首发工作流,以及约束各自的规则,包括 SR 26-2——它在 2026 年 4 月取代了美国银行模型风险管理所依据的 SR 11-7。
为什么重要。 客户之间最大的差异,在于他们绝不能容许出错的地方各不相同。一个把关人能快速批准的试验,胜过一个更出色却批不下来的试验。
读完之后你能做什么。 为你下一位客户填写文章表格中的一行,然后拿给把关人看,问问是什么会让他们无法批准。
Pitching Agentic AI — 系列脉络
- 比任何推介都更长寿的原则 第 1 集
- 这一季该怎么推介智能体 第 2 集
- 四位客户,四套首发工作流 本集
标签说明:EVIDENCE 表示有据可查,DESIGN 表示推荐做法,OPEN 表示尚未验证,LENS 表示这是我自己的判断。
同样这四招,放到银行、制药公司、工厂和软件公司身上,效果各不相同。每一类都会讲到:痛点是什么、谁拿主意、规矩是什么,以及一套为期六周、带人类边界与配对速度—质量指标的首发工作流。惊喜:这四类里有三类,我会把首个任务完全挡在生产环境之外。
本篇内容:四个行业的首发工作流
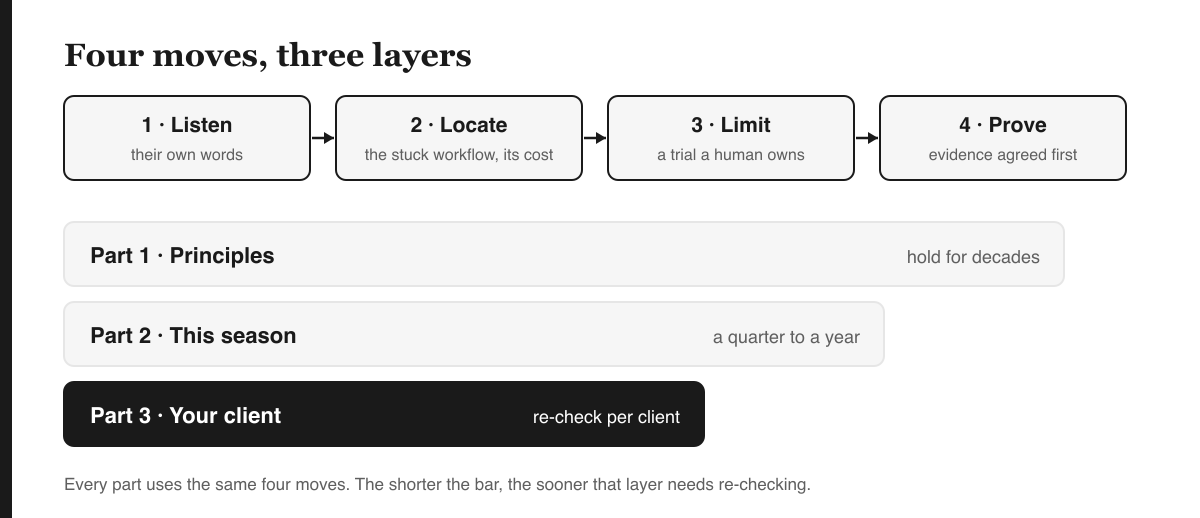
第一、二篇给出了四招(倾听、定位、限定、验证)和四项检查(具体、如实估量、有人负责、提前定好衡量标准)。但这些终究要落地到真实客户身上,而客户之间最大的不同,在于他们绝不允许出错的地方。本篇挑出四个出错代价最高的行业,为每一个提出一套首发工作流:小到六周内就能试完,又足够清楚可辨让人评判好坏,同时守在规矩之内。
这些只是起始假设,并非针对任何具体公司的建议。 各地监管不尽相同,且常常变动;在依赖下文任何一条规则之前,请与客户自己的风险、质量或法务团队核实。
先立一个赌注
在这四类客户(一家银行、一家生命科学公司、一家工业制造商、一家软件公司)中,你会在几家把 AI 智能体的第一个任务完全挡在生产环境之外?
- A. 一家。
- B. 两家。
- C. 三家。
和第一、二部分不同,这次的赌注背后没有研究支撑。这是个判断,我会亮出我自己的答案。
1. 金融服务与保险
痛点。 EVIDENCE 每一个影响决策的模型都需要向模型风险团队提供证据,而这项规定刚刚发生变化。2026 年 4 月,美联储发布了 SR 26-2,这是与 OCC、FDIC 联合制定的跨机构指引,"supersedes and replaces" SR 11-7(中译:取代并替代了 SR 11-7),并且"expected to be most relevant to banking organizations with over $30 billion in total assets"(中译:预计对总资产超过 300 亿美元的银行机构最为适用)(Federal Reserve, SR 26-2, 2026)。在欧盟,《数字运营韧性法案》(EU DORA,勿与第 4 节中 Google 的 DORA 指标混淆)自 2025 年 1 月起生效,涵盖 ICT 风险、第三方风险与韧性测试(EIOPA, DORA).
谁来拍板。 买单的是 CIO 或工程负责人,但能不能跑,得由模型风险官、CISO 和供应商风险团队说了算。
首个工作流。 DESIGN 为一个非生产环境的遗留批处理模块编写文档并生成测试。每一处改动都由工程师复核;试验期间不上生产环境。(模型风险团队已经看过第 7 页幻灯片,他们还专门为此写过一份政策。)
度量指标。 第一周先记录如今给一个模块写文档要花多久。六周内持续对比,并与工程师原样接受生成测试的比例配对来看。
说辞。 你说过,现代化改造卡在了锁在旧代码里的知识上(倾听)。反复出现的成本,是一位资深工程师光是读代码就要花上几周(定位)。一个模块,只读,不改,你的工程师给每一条测试把关(限定)。如果文档耗时相比第一周减半,且大多数测试都被采纳,那就值得再试第二个模块(验证)。
OPEN SR 26-2 所附指引是否将编码智能体与决策模型区别对待,这一点我还没搞清楚,属于未决问题。第一次开会就该问模型风险团队,别留到最后。
2. 生命科学与医疗健康
痛点。 EVIDENCE 凡触及受监管记录的软件都必须经过验证,电子记录与电子签名适用 21 CFR Part 11(eCFR, 21 CFR Part 11)。FDA 发布的《计算机软件保证》最终指南(2026 年 2 月),虽是针对器械制造商生产与质量体系软件而写,但在整个生命科学行业被广泛解读为一个信号:转向基于风险的保证,而非穷尽式的脚本化测试(FDA, Computer Software Assurance).
归谁管。 买单的是研发 IT 或质量 IT 负责人;把关的是质量保证部门和验证团队。
首个工作流。 DESIGN 为一款低风险、GxP 相关的内部工具起草验证测试脚本和可追溯性矩阵。QA 审核并签署每一份文件;任何提示词中都不得出现患者数据;试验中产生的任何内容都不进入生产环境;已批准的脚本留存下来,作为下一个工具的证据。
度量指标。 从需求提出到测试脚本获批所需天数,与第一周的基线相比,同时配对记录 QA 在首次审核时的驳回率。
说辞。 你说过,验证是每次工具发布的瓶颈(倾听)。重复出现的成本是每次都要从零起草脚本(定位)。只做一款低风险工具,只起草不上线,QA 签署一切(限定)。如果审批时间下降而首次驳回率没有上升,或许值得再试第二款工具(验证)。
LENS 在这个领域,对记录与签名负责不是一种客套,而是法律要求。先把这句话说在前面,比任何基准测试都更能赢得信任。
3. 工业与制造业
痛点。 EVIDENCE 装机规模庞大:仅中国的工业机器人运营存量,按国际机器人联合会的统计,就已在 2024 年突破 200 万台(IFR, World Robotics 2025),而且依我的经验,这类设备周边的控制软件,寿命往往比写它的人还长。OT 安全自有一套标准体系,即 IEC 62443(ISA, IEC 62443).
归谁管。 工程副总裁或数字化制造负责人负责采购;OT 安全负责人则决定任何东西可以接入什么。
首个工作流。 DESIGN 对遗留的控制或 SCADA 代码进行只读式解释与文档整理,并生成测试——这些测试只能在仿真器或数字孪生中运行。边界是绝对的:任何 AI 写的代码都不得进入安全等级逻辑,那是 IEC 61508 等功能安全标准的管辖范围。
衡量指标。 一名刚接手某条产线的工程师,理解一段控制例程所需的时间,对照上一位新工程师当年花了多久(第一周就把这个数字记下来),再配对比较仿真阶段发现的缺陷数——即任何改动上线前,在仿真环节查出的问题。
说辞。 你说过,这条产线的控制器代码现在只有两个人还看得懂(倾听)。每次改动都得等他们(定位)。只读式讲解,测试只在仿真器里跑,绝不碰安全逻辑(限定;从没有哪个厂长嫌联锁保护太谨慎)。如果新工程师上手速度能快一倍,又没漏掉任何缺陷,那就值得在第二条产线上试试(验证)。
4. 科技、软件与电信
痛点。 EVIDENCE 正如 Google 的 DORA 2025 报告所发现的,AI 能提升吞吐量,却可能降低交付稳定性,于是评审就成了瓶颈(DORA 2025 announcement).
归谁管。 CTO 与平台工程负责人负责采购;产品团队则要为滞后的路线图日期负责。
首个工作流。 DESIGN 为某个服务补齐测试,或按团队自己的检查清单做首轮 pull request 评审,每次合并都由工程师批准。这是四个行业里唯一一个我愿意让第一个任务直接写出可上线代码的行业,因为团队本就掌握着能捕捉错误的那条流水线。
衡量指标。 用 DORA 自家的指标做前后对比:部署频率、变更前置时间、变更失败率与恢复时间(单个服务六周内数据噪声较大,所以要看趋势,不要盯着单一数字)。把评审周转时间与漏网缺陷数配对比较,这样一来,速度就不可能是以评审放水为代价换来的。
说辞。 你说过,评审是发布排队的地方(倾听)。同一份检查清单每个冲刺都要靠人工套用一遍,而且还不一致(定位)。只做一个服务,只做首轮评审,每次合并都由工程师批准(限定)。如果周转时间缩短,而变更失败率没有上升,那就值得再上第二个服务(验证)。
贯穿四者的共同模式
| 行业 | 首个工作流 | 人类边界 | 速度信号 | 质量信号 | |---|---|---|---|---| | 金融服务 | 为一个遗留模块编写文档并生成测试 | 工程师批准每一项测试;不进入生产环境 | 编写文档所需小时数 | 测试被原样采纳的比例 | | 生命科学 | 为一个低风险工具起草验证脚本 | QA 签署每一份文件;提示词中不含患者数据;不进入生产环境 | 从需求到脚本获批所需天数 | QA 首轮评审的驳回率 | | 工业制造 | 解读控制代码;仅在仿真环境中测试 | 仅限仿真环境;不触及安全等级逻辑或生产环境 | 理解一段控制程序所需时间 | 仿真中发现的缺陷数 | | 软件与电信 | 测试回填或首轮评审 | 工程师批准每一次合并 | 评审周转时间、交付周期、部署频率 | 变更失败率、漏网缺陷 |
我对这场赌局的答案是C:四者之中有三个会被完全挡在生产环境之外。DESIGN 在我看来,其中的机制是这样的:把关人最先问的问题,很少是「它有多好」,而是「它最坏能坏到什么地步」。只要把试点挡在生产环境之外,这个问题的答案就是「什么都不会发生」,而「什么都不会发生」正是把关人在证据出现之前唯一能批准的答案。这是一个设计判断,而非测量结果,并且每个案例里最终拍板的都是把关人。在受监管和安全攸关的场合,一个对生产环境不做任何改动的试点,恰恰是把关人能够迅速批准的那种,它积累的证据也会为日后赢得更多。
这可能在哪里失手
- 分类太粗。 一家数字原生银行的行事方式更像软件公司,而不像一家地区性保险公司。要甄别的是客户本身,而不是行业标签。
- 监管的变化比文章更新得快。 SR 26-2 今年刚取代了一份 2011 年的指引;欧盟高风险 AI 的时间表也已经调整过。引用任何一条规则给客户听之前,先核实它当下的状态。
- 「不进生产环境」可能变成死胡同。 如果没有人负责把「解读代码」这一步推进到「安全地修改代码」,试点最终就只会停留在文档层面。开始之前,先指定这个负责人。
- 我们不知道基础转化率。 对于这类试点在各个行业里转化为生产应用的频率,我手头没有可靠的数字。老老实实去数自己的案例,包括那些失败的。
- 第 7 页幻灯片又回来了。(「它还能做合规呢!」)每个行业都会诱使你列出一份专属的能力清单。记住:一个工作流,一支团队,六周时间。
这周就能做的事
挑一个最接近你下一位客户的行业。为他们填好上表中的一行,用客户自己的话来描述痛点。然后把这一行拿给把关人看——不是买家——只问一个问题:「什么会让你不批准这个?」
下一篇
这样,整个系列就完结了:能撑过每一次推销的原则、这一季的具体做法,以及四个行业的首个工作流。「这一季」这一层会随证据更新而变化;第一部分里的原则,是我预期会一直留存下去的部分。
资料来源
- Board of Governors of the Federal Reserve System. SR 26-2, "Revised Guidance on Model Risk Management"(美联储与 OCC、FDIC 联合发布的跨部门指引)。2026 年 4 月 17 日。
- EIOPA. 《数字运营韧性法案》(Digital Operational Resilience Act,欧盟 2022/2554 号条例),自 2025 年 1 月 17 日起施行。
- 美国 eCFR。21 CFR Part 11,电子记录与电子签名。
- 美国 FDA。《Computer Software Assurance for Production and Quality Management System Software》(中译:面向生产与质量管理系统软件的计算机软件保证)。最终指南,2026 年 2 月(文号 FDA-2022-D-0795)。
- International Federation of Robotics(国际机器人联合会)。World Robotics 2025,新闻稿。
- ISA。ISA/IEC 62443 系列标准。IEC 61508,电气/电子/可编程电子安全相关系统的功能安全标准。
- Google Cloud。《Announcing the 2025 DORA report》(中译:发布 2025 年 DORA 报告)。2025 年 9 月 23 日。