AI-Native 系列 · 智能体系统的控制
你给它的身体
一分钟速读——你会收获什么
你不再想着怎么写出更好的指令,而是开始搭建模型工作的“房间”:工具、沙盒、上下文组装、权限,还有只增不减的会话日志。接着你会发现,原本那套术语体系就不够用了——Anthropic 的Scaling Managed Agents直接把 harness 定义成“the loop that calls Claude and routes Claude's tool calls”(中译:调用 Claude 并路由 Claude 工具调用的循环),所以 harness 和 loop 其实不是两层,而是同一个东西的两种视角。实际工程上,这带来一个归因修正:经典的“模型用了 40 分钟后变差了”,其实是 harness 出了问题,只是表面看起来像提示工程掉链子,因为对话记录越堆越长,最早的约束已经被挤出了上下文窗口。
开场白
你不再想着怎么写更妙的小纸条,而是干脆把厨房本身搭起来。
刀就在手边。储藏柜都贴好标签。温度计、垃圾桶、只往外开的门,还有一本钉在操作台上的笔记本,每道菜出锅都记上一笔。
你没让厨师变聪明。你只是换了厨师能做的事——更重要的是,换了厨师能发现的事。这就是 harness 工程,也是现在大部分真正工程工作的主场——提示工程的论文还没给这层命名时就已经在往这儿靠(arXiv:2401.14423),而Promptware Engineering(arXiv:2503.02400)讨论的,其实也是围绕提示的流程,而不是怎么把提示词润色得更漂亮。
然后你去查定义,发现大家画的那张整齐分明的分层图直接崩了。
让分层图失效的定义
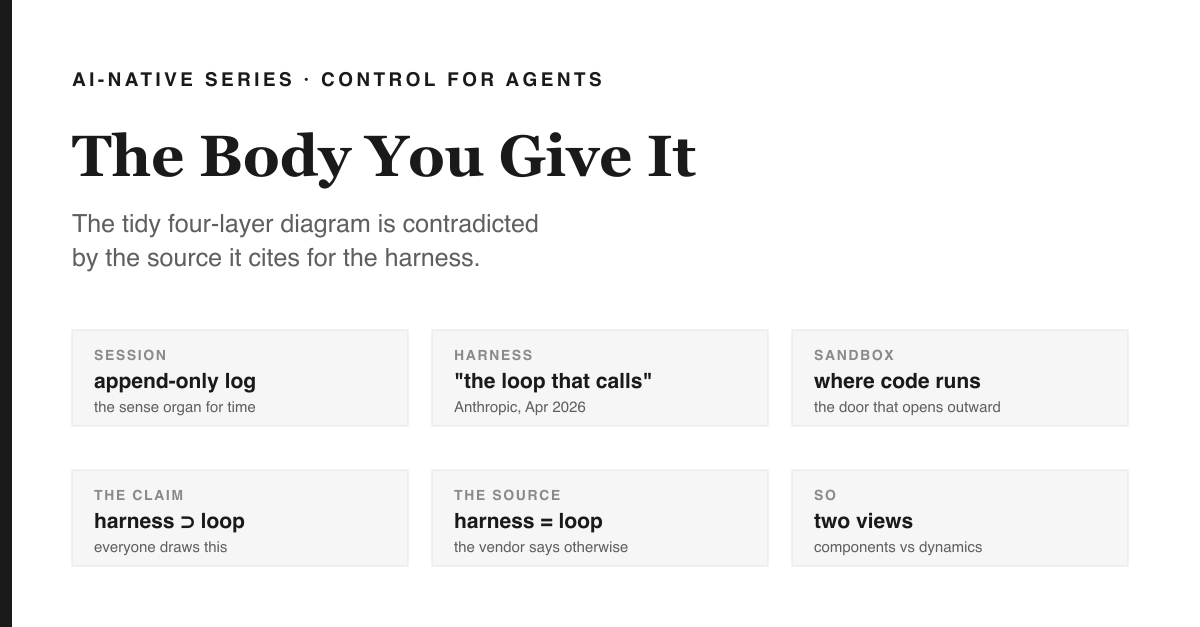
常见的图画成四层嵌套:提示在 harness 里,harness 跑 loop,最上面还有 graph 协调 loop。图画得很清楚,也很容易教,但它最常被引用的原始出处其实并不认同这个分层。
Anthropic 的Scaling Managed Agents(Anthropic, 2026a)把 agent 拆成了三个部分:
“a session (the append-only log of everything that happened)” “a harness (the loop that calls Claude and routes Claude's tool calls to the relevant infrastructure)” “a sandbox (an execution environment where Claude can run code and edit files)”
[DEF]再读一遍中间这句。在厂商自己的定义里,harness就是loop——也就是负责调用模型、分发工具调用的那一套。它不是 loop 的外壳。
[DESIGN]所以「harness 工程」和「loop 工程」其实不是堆叠里的两层,而是同一个东西的不同侧面。harness 关注组件——比如工具、沙箱、上下文组装、记忆、权限、评测;loop 关注动态——什么会重复、观察什么、什么时候停。你可以有个很烂的 loop 配上好用的 harness,也可以有个很棒的 loop 却被贫瘠的 harness 拖后腿,所以这两个词都各有用处。但把一个硬塞进另一个的画法,其实并没有原始资料的支持。
厨房 vs 技术:一一对应表
| 厨房配置 | 技术术语 | 能避免的失误 |
|---|---|---|
| 刀具随手可取 | 工具 schema / 函数定义 | 模型描述了自己做不到的动作 |
| 标好类别的储藏室 | 上下文组装 / 检索 | 信心满满地改错文件 |
| 温度计 | 评测与测试执行 | “看起来完成了” |
| 只能往外开的门 | 沙箱 + 权限模型 | 一不小心把生产环境删了 |
| 钉在操作台上的笔记本 | 会话日志(只追加) | 决策原因丢失 |
| 操作台空间 | 上下文窗口预算 | 最新的指令把最早的约束挤出窗口 |
观点分门别类
[DESIGN] 真正让长时间运行的任务出问题的,其实就是 harness 这一层——这是厂商自己对自家设计的说法,是设计报告,不是实测数据。Anthropic 的 Effective harnesses for long-running agents(Anthropic, 2026b)这篇文章,专门讨论了那些在提示工程层根本看不到的故障:状态交接、进度追踪、上下文管理和压缩、初始化、增量式会话。这些都不是提示能修好的,怎么改词都没用。
[OPEN] OpenAI 的 Harness engineering 文章和 Unrolling the Codex agent loop(OpenAI, 2026)从另一家厂商的角度讲了同样的转向:真正有工程价值的,是整个环境,以及用户输入 → 指令 → 模型调用 → 工具执行 → 重复的全流程转化,而不是单靠指令本身。(这两个链接用脚本访问时都返回 403——是反爬虫,不是页面不存在。我没读过这两页的正文,所以这个观点标记为 open 而不是 evidenced。)
[DESIGN] Building Effective AI Agents(Anthropic, 2026c)划出了整个领域反复争论的那条分界线:工作流 是预设好的编排路径;智能体 则是模型动态掌控流程和工具使用的系统。记住这个区别——第四集会专门讲讲,当你把两者混为一谈时会发生什么。
[OPEN] 目前还没有公开、可比的 harness 质量指标。我们能测任务的整体成功率,但要把提升归因到上下文组装、工具设计,还是循环的终止规则,依然没人能说清——这其实就是第 1 集留下的归因难题,只是换了个层级。
预测关卡
往下看之前,先做个判断。
有个 agent,拥有 20 万 token 的上下文,每次工具调用的结果都会被 harness 原样追加。它前 40 分钟一切顺利,之后却开始犯第 5 分钟时不会犯的错——包括重复做已经完成的事。
问题: 说说原因。到底是模型变差了、提示衰减了,还是 harness 出了问题?
如果你选了“模型变差了”,那你正好踩中了本领域最常见的归因误区。模型其实一模一样。最早声明的约束已经被对话记录挤出了上下文窗口,agent 现在只能在自己指令的一个被截断版本上优化。这是 harness 的锅,只是表面看起来像提示出了问题——所以“压缩”才是 harness 的核心需求,而不是锦上添花的小功能。
失效现场
故意拆掉一块试试:工具全留着,把 session log 删掉。
给 agent 全部工具权限、合格的 sandbox,每轮都用全新上下文,但不保留任何追加记录。你会看到:它会重复做已经完成的事,否定自己之前的决策,而且——关键就在这——它永远不会察觉,因为“察觉”这件事需要把现在和过去做对比。
结论:session log 不是简单的存储空间,它其实是时间的感知器官。拿掉它,你不是让 agent 变慢了,而是让它根本没法形成循环。这也正是第 3 集要讲的内容,厂商定义里 session 和 harness 并列也因此有了道理。
实验——15 分钟
测一测大家都没测过的东西:上下文组装的成本.
- 挑一个 agent 任务,每轮都记录:指令,指令 token 数,检索到的上下文,对话记录,以及本轮是否成功。
- 把这三项在整个运行过程中画成图。大多数系统里,指令 token 基本平稳,检索部分高低起伏,对话记录则一路递增,最后占据主导。
- 现在用最简单的截断法,把对话记录限制在窗口的 50%,再跑一遍。请注意失败模式的变化,而不仅仅是失败率——最简单的截断通常会让“慢且对”变成“快且自信地错”。
你要看的关键数字是:哪一轮对话记录的 token 数第一次超过指令 token 数。从那之后,你的 prompt 在上下文里就成了小股东。
实战演练
拿一个你真正在跑的 agent,把它的 harness 按六个标题写满一页:工具、沙箱边界、上下文组装、记忆/会话、权限、评估。任何一个你没法直接从代码(不是设计意图)里填出来的部分,就是你系统里没人管的地带。在我自己的引擎里,这个练习把一堆零散的 flag 变成了一份能审查的文件,顺带产出的解析闸门也是另一篇文章的主角,我在自己的清单上拿了 100 分.
研究挑战
用一个 agent 来补齐缺失的 harness 评价指标。模型和循环都不变,只切换三种上下文组装策略(完整对话记录、最近窗口、总结并钉约束)在同一任务集上跑。报告成功率和对话记录 token 数超过指令 token 数的轮次。要验证的观点是:第二个数字比任何 prompt 微调都更能预测第一个数字。目前[开放问题].
小测验
- 在 Anthropic 自己的拆解里,harness 是什么?(the loop that calls the model and routes its tool calls)(中译:调用模型并路由其工具调用的循环)
- 为什么“harness 是 loop 的容器”只是一个主张而不是定义?
- 举一个表面看像提示工程问题,实则是 harness 层失误的例子。(某个最早声明的约束被对话内容越堆越多,最终被挤出了上下文窗口)
埋个包袱
你有了身体、储藏室、温度计和笔记本。盘子一道道送出去,又一道道端回来,现在你终于能看见它们回来了。于是你顺理成章地开始做一件事:看一眼回来的盘子,调整下,再递出一张新单子。看、调整、再送。看、调整、再送。
你这就搭起了一个反馈回路。很快你会发现,这其实是整季里最古老、被分析得最透彻的结构——而且十九世纪的人早就学会问它的那个问题,而你的 agent 堆栈现在还根本没法表达。
下集预告
第六季第二集Intelligence Engineering Adventures, Season 6 — The Governor Engine。本系列所有论断都按类别标注——定义、推导、证据、工程选择、开放问题——比喻可以用来引入观点,但绝不当作证据。整季都认真对待那张四层结构图,真的去查了原始出处,结果发现它站不住脚:Anthropic 的定义里,harness 就是 loop,而不是 loop 之上的一层。每条论断都标明类别,唯一真正开放的问题也如实标注为 open——目前还没人给 LLM 控制回路提出过稳定性判据。本文不含任何雇主或客户的内容。—— Paul Jialiang Wu · futuremake.io
参考文献
- (Anthropic, 2026a) Scaling Managed Agents: Decoupling the brain from the hands(2026 年 4 月 8 日)—— session / harness / sandbox 的分解;上文已原文引用。https://www.anthropic.com/engineering/managed-agents
- (Anthropic, 2026b) Effective harnesses for long-running agents —— 状态交接、进度追踪、上下文管理与压缩。https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
- (Anthropic, 2026c) Building Effective AI Agents —— 工作流(预设路径)与智能体(模型动态主导流程和工具使用)的对比。https://www.anthropic.com/engineering/building-effective-agents
- (OpenAI, 2026) Harness engineering: leveraging Codex in an agent-first world; Unrolling the Codex agent loop。这两篇在 2026-08-24 用脚本访问时均返回 HTTP 403(反爬虫保护);内容引自官方简介,并非我亲自获取的正文。