AI-Native 시리즈 · 에이전트형 시스템 제어
모델에 부여하는 몸
1분 요약 — 이 글에서 얻을 핵심
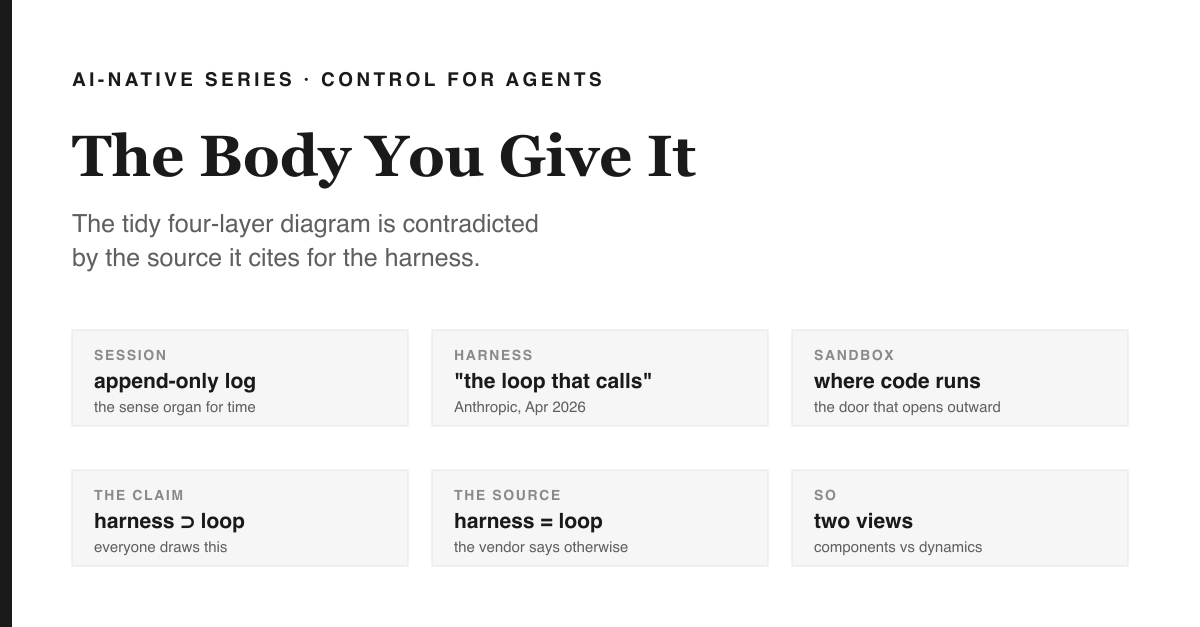
더 나은 지침을 고민하는 단계를 넘어, 이제 모델이 일할 공간 자체를 설계하게 된다. 도구, 샌드박스, 컨텍스트 어셈블리, 권한, 그리고 추가만 가능한 세션 로그. 그런데 여기서 용어의 경계가 무너진다 — Anthropic의 Scaling Managed Agents에서는 하니스를 다음과 같이 정의한다: “the loop that calls Claude and routes Claude's tool calls”(번역: Claude를 호출하고 Claude의 도구 호출을 라우팅하는 루프)즉, 하니스와 루프는 계층적으로 쌓인 두 층이 아니라, 하나의 대상을 구성과 동작이라는 두 시각에서 바라본 것이다. 실질적 의미는 귀속 문제의 재정의에 있다. 흔히 보는 “모델이 40분 뒤에 성능이 떨어졌다”는 현상은, 사실 프롬프트 실패의 증상을 띤 하니스 실패다. 트랜스크립트가 길어지면서 처음 명시한 제약이 컨텍스트 윈도우 밖으로 밀려나 버렸기 때문이다.
주방에서 시작
더 나은 지시문을 고민하는 걸 멈추고, 아예 주방을 짓는다.
칼은 손닿는 곳에. 이름 붙은 저장실. 온도계. 쓰레기통. 바깥으로만 열리는 문. 그리고 모든 요리가 나갈 때마다 그 내용을 적는 노트가 작업대에 못으로 고정되어 있다.
나는 요리사를 더 똑똑하게 만든 것이 아니다. 바뀐 것은 요리사가 할 수 있는 일— 그리고 더 중요한 건, 요리사가 알아낼 수 있는 것이다. 이것이 하니스 엔지니어링이며, 현재 실제 엔지니어링의 중심이기도 하다. 프롬프트 연구가 이름조차 붙기 전부터 이미 파고들던 영역이고(arXiv:2401.14423), Promptware Engineering (arXiv:2503.02400) 역시 더 나은 문구가 아니라 프롬프트를 둘러싼 프로세스 자체를 강조하며 이 층을 지목했다.
그런데 정의를 찾아보면, 모두가 그리던 깔끔한 도식이 무너진다.
도식을 뒤집는 정의
흔히 네 개의 층이 포개진 그림을 그린다. 프롬프트가 하니스에 들어가고, 하니스가 루프를 돌리며, 그 위에서 그래프가 루프들을 조율한다. 이 구조는 보기에도 명쾌하고, 설명하기도 쉽다. 하지만 정작 가장 많이 인용되는 1차 자료는 이 구조에 동의하지 않는다.
Anthropic의 Scaling Managed Agents (Anthropic, 2026a)은 에이전트를 세 부분으로 나눈다:
"세션(일어난 모든 일의 append-only 로그)" "하니스(루프 — Claude를 호출하고 Claude의 도구 호출을 적절한 인프라로 라우팅하는 것)" "샌드박스(Claude가 코드를 실행하고 파일을 편집할 수 있는 환경)"
[DEF]가운데 항목을 다시 보자. 공급자의 정의에서 하니스는 곧 루프다. 즉, 모델을 호출하고 도구 호출을 라우팅하는 그 자체이지, 루프가 안에 들어가는 껍데기가 아니다.
[DESIGN] 즉, "하니스 엔지니어링"과 "루프 엔지니어링"은 계층 구조의 두 단이 아니라, 동일한 대상을 바라보는 두 시각이다. 하니스는 구성 요소— 도구, 샌드박스, 컨텍스트 어셈블리, 메모리, 권한, 평가 등—를 가리킨다. 루프는 동작의 흐름— 무엇이 반복되고, 무엇을 관찰하며, 언제 멈추는지를 뜻한다. 허술한 루프를 얹은 하니스를 만들 수도 있고, 부실한 하니스 위에 훌륭한 루프를 올릴 수도 있다. 이 때문에 두 용어를 모두 구분해 쓰는 것이 실무적으로 의미가 있다. 그러나 둘 중 하나가 반드시 다른 것의 내부에만 존재한다는 식의 도식은, 실제 출처에서는 근거를 찾을 수 없다.
주방-기술 대응표
| 주방 요소 | 기술적 명칭 | 막아주는 실패 유형 |
|---|---|---|
| 손이 닿는 칼 | 도구 스키마, 함수 정의 | 모델이 실제로 할 수 없는 행동을 말로만 설명하는 문제 |
| 라벨이 붙은 저장실 | 컨텍스트 어셈블리, 인출 | 잘못된 파일에서 자신만만하게 작업하는 오류 |
| 온도계 | 평가, 테스트 실행 | "겉보기로는 완료됨" |
| 밖으로만 열리는 문 | 샌드박스, 권한 모델 | 실서비스 데이터를 삭제하는 수정 |
| 작업대에 못으로 고정된 기록장 | 세션 로그(추가만 허용) | 결정의 근거가 사라짐 |
| 작업대 공간 | 컨텍스트 윈도우 예산 | 가장 최근의 지시가 가장 먼저 주어진 제약을 밀어내는 상황 |
주장 분류
[DESIGN] 장시간 지속되는 작업이 실제로 무너지는 곳은 하니스다. 이는 공급자가 직접 밝힌 설계 보고서에 근거한 것으로, 측정값이 아니라 설계상의 진술이다. Anthropic의 Effective harnesses for long-running agents (Anthropic, 2026b)은 프롬프트 층에서는 드러나지 않는 실패들—상태 인계, 진행 추적, 컨텍스트 관리 및 압축, 초기화, 점진적 세션—을 중심으로 구성되어 있다. 이들은 프롬프트의 문제가 아니며, 어떤 문구 수정으로도 해결되지 않는다.
[OPEN] OpenAI의 Harness engineering 글과 Unrolling the Codex agent loop (OpenAI, 2026)은 다른 공급자 관점에서 동일한 전환을 설명한다. 진짜 엔지니어링의 쟁점은 환경과, 사용자 입력 → 지시 → 모델 호출 → 도구 실행 → 반복으로 이어지는 변환 전체이지, 지시 하나만이 아니다. (두 URL 모두 스크립트로 접근하면 403을 반환한다. 이는 부재가 아니라 봇 차단 때문이다. 본문을 직접 읽지 못했으므로, 이 주장은 증거가 아니라 open으로 분류한다.)
[DESIGN] Building Effective AI Agents (Anthropic, 2026c)은 이 분야가 계속해서 다시 긋는 경계선을 명확히 한다: 워크플로우는 미리 정해진 조정 경로이고, 에이전트는 모델이 프로세스와 도구 사용을 동적으로 통제하는 시스템이다. 이 구분을 기억하라. 4화 전체가 바로 이 둘을 혼동할 때 무슨 일이 벌어지는지 다룬다.
[OPEN] 하니스의 품질을 객관적으로 비교할 수 있는 지표를 공식적으로 발표한 사례는 아직 없다. 전체 작업의 성공률은 측정할 수 있지만, 그 성과가 컨텍스트 어셈블리, 도구 설계, 루프의 중단 규칙 중 어디에서 비롯된 것인지 분리해내는 문제는 여전히 풀리지 않았다. 이 미해결의 귀착점은 1화에서 한 단계 위로 남겨둔 바로 그 기여도 할당 문제와 같다.
예측 구간
아래를 읽기 전에, 먼저 스스로 답을 정해보라.
어떤 에이전트가 20만 토큰짜리 컨텍스트와, 모든 도구의 결과를 매번 그대로 덧붙이는 하니스를 갖고 있다고 하자. 이 시스템은 40분 동안은 아무 문제 없이 동작하다가, 5분 시점에는 없던 실수를 내기 시작한다. 이미 끝낸 작업을 다시 반복하기도 한다.
문제: 이 현상의 원인을 명명하라. 모델의 성능 저하인가, 프롬프트의 붕괴인가, 아니면 하니스의 문제인가?
"모델이 나빠졌다"라고 답했다면, 당신은 이 분야에서 가장 흔한 기여도 할당 오류를 범한 것이다. 모델 자체는 변하지 않았다. 가장 먼저 명시된 제약이 대화 기록이 길어지면서 컨텍스트 윈도우 밖으로 밀려났고, 에이전트는 이제 자기 지침의 잘려나간 버전만을 기준으로 최적화를 시도한다. 이는 프롬프트 실패처럼 보이지만, 실제로는 하니스의 실패다. 그래서 컴팩션이 하니스의 핵심 과제가 되는 것이지, 단순한 편의 기능이 아니다.
실패 실험실
이번엔 의도적으로 망가뜨려보자: 모든 도구는 그대로 두고, 세션 로그만 삭제한다.
에이전트에게 모든 도구 접근 권한과 훌륭한 샌드박스, 그리고 매 턴마다 새 컨텍스트를 제공하되, 추가만 가능한 세션 기록은 남기지 않는다. 그러면 어떤 일이 벌어지는가? 이미 끝낸 작업을 반복하고, 스스로 내린 과거 결정을 뒤집는다. 그리고—여기가 핵심이다—절대 알아차리지 못한다. 왜냐하면, 지금과 이전을 비교해야만 '알아차림'이 가능하기 때문이다.
진단: 세션 로그는 단순한 저장소가 아니라, 시간을 감지하는 감각 기관이다. 이것이 없으면 에이전트가 느려지는 것이 아니라, 아예 루프 자체를 가질 수 없게 된다. 바로 이것이 3화로 이어지는 연결점이며, 공급자 정의에서 세션과 하니스가 나란히 놓이는 이유다.
실험 과제 — 15분
아무도 신경 쓰지 않는 비용을 직접 재보자: 컨텍스트 어셈블리 비용.
- 에이전트의 한 작업을 계측한다. 턴마다 기록할 항목: 지침, 명령어 토큰 수, 인출된 컨텍스트, 트랜스크립트, 그리고 해당 턴의 성공 여부.
- 세 가지 요소의 변화를 전체 실행 구간에 걸쳐 그래프로 나타낸다. 대부분의 시스템에서는 명령어 토큰 수는 일정하게 유지되고, 인출 컨텍스트는 들쭉날쭉하며, 트랜스크립트는 꾸준히 증가해 결국 전체를 압도하게 된다.
- 이번에는 트랜스크립트가 컨텍스트 윈도우의 50%를 넘지 않도록 단순 절단(naive truncation)으로 제한한 뒤 다시 실행한다. 이때 실패 양상이 어떻게 달라지는지에 주목해야 한다. 단순 절단을 적용하면 대개 '느리지만 정확한' 상태가 '빠르면서도 확신에 차게 틀리는' 상태로 바뀐다.
여기서 관찰해야 할 값은 트랜스크립트가 명령어 토큰 수를 넘어서는 턴 인덱스다. 이 시점 이후로는 프롬프트가 전체 컨텍스트에서 차지하는 비중이 소수로 전락한다.
현실 과제
실제로 운용 중인 에이전트를 하나 선정한다. 그 하네스의 구조를 도구, 샌드박스 경계, 컨텍스트 어셈블리, 메모리/세션, 권한, 평가의 여섯 항목으로 나누어 한 페이지에 정리한다. 코드에서(의도가 아니라) 직접 확인할 수 없는 항목이 있다면, 그 부분은 시스템 내에서 아무도 관리하지 않는 영역이다. 내 엔진에서는 이 연습을 통해 흩어져 있던 플래그들이 검토 가능한 파일로 모였고, 이 과정에서 등장한 parse gate는 별도의 글에서 다뤘다. I Scored 100% on My Own Checklist.
연구 챌린지
에이전트를 활용해 아직 정의되지 않은 하네스 품질 지표를 만들어본다. 모델과 루프는 동일하게 두고, 컨텍스트 어셈블리만 세 가지 전략(전체 트랜스크립트, 최신성 윈도우, 요약 및 제약 고정)으로 바꿔가며 동일한 작업군에 적용한다. 성공률 과 트랜스크립트가 명령어를 넘어서는 턴 인덱스를 함께 기록한다. 검증할 주장: 두 번째 수치가 어떤 프롬프트 수정보다 성공률을 더 잘 예측한다. 현재 [OPEN].
종료 테스트
- Anthropic의 자체 구조 분해에서 하네스란 무엇인가? (the loop that calls the model and routes its tool calls)(번역: 모델을 호출하고 도구 호출을 라우팅하는 루프)
- "루프가 실행되는 하네스"가 정의가 아니라 주장인 이유는 무엇인가?
- 프롬프트의 문제처럼 보이지만, 실제로는 하니스에서 비롯된 실패 사례를 하나 들어보라. (트랜스크립트가 길어지면서 처음에 명시한 제약이 컨텍스트에서 밀려난 경우)
막간
이제 나는 몸, 저장실, 온도계, 그리고 작업대에 못 박힌 노트가 있다. 접시는 나갔다가 다시 돌아온다. 그리고 나는 그 접시가 돌아오는 장면을 직접 본다. 그러면 나는 자연스럽게 이런 행동을 반복한다: 돌아온 접시를 살펴보고, 조정하고, 새 주문을 보낸다. 읽고, 조정하고, 보낸다. 읽고, 조정하고, 보낸다.
나는 방금 피드백 루프를 만들었다. 그리고 곧 깨닫게 된다. 이것이 이번 시즌에서 가장 오래되고, 가장 깊이 분석된 대상임을. 그리고 19세기가 이 피드백 루프에 대해 던진 단 하나의 질문이, 지금 내 에이전트 스택에서는 아직 표현조차 할 수 없는 질문임을.
→ 3화 — 거버너
이어 읽기
6화 Intelligence Engineering Adventures, Season 6 — The Governor Engine. 이 시리즈의 모든 주장에는 정의, 도출, 증거, 엔지니어링 선택, 오픈 퀘스천 등 분류 태그가 붙는다. 비유는 주장을 소개할 수는 있지만, 결코 증거가 될 수 없다. 이 시즌은 네 가지 라벨이 붙은 도식을 실제 주요 1차 자료와 대조할 만큼 진지하게 검토하지만, 그 도식은 살아남지 못한다. Anthropic의 정의에 따르면 하니스는 루프 그 자체이지, 그 위에 쌓인 별도의 계층이 아니다. 모든 주장은 분류 태그로 구분되고, 진정으로 미해결된 문제는 open으로 명시된다 — 아직 LLM 제어 루프의 안정성 기준을 발표한 이는 없다. 이 글에는 어떤 고용주나 클라이언트의 자료도 들어 있지 않다. — Paul Jialiang Wu · futuremake.io
참고문헌
- (Anthropic, 2026a) Scaling Managed Agents: Decoupling the brain from the hands (2026년 4월 8일) — 세션 / 하니스 / 샌드박스 분해; 위에서 원문 인용.https://www.anthropic.com/engineering/managed-agents
- (Anthropic, 2026b) Effective harnesses for long-running agents — 상태 이관, 진행 상황 추적, 컨텍스트 관리와 압축.https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
- (Anthropic, 2026c) Building Effective AI Agents — 워크플로우(미리 정해진 경로)와 에이전트(모델이 직접 프로세스와 도구 사용을 제어)의 구분.https://www.anthropic.com/engineering/building-effective-agents
- (OpenAI, 2026) Harness engineering: leveraging Codex in an agent-first world; Unrolling the Codex agent loop. 두 페이지 모두 2026-08-24에 스크립트로 접근하면 HTTP 403(봇 차단)이 반환됨; 본문을 직접 읽은 것이 아니라 요약 설명을 인용함.