Serie AI-Native · Control para sistemas agénticos
El entorno que le das
Resumen en un minuto: lo que aprenderás
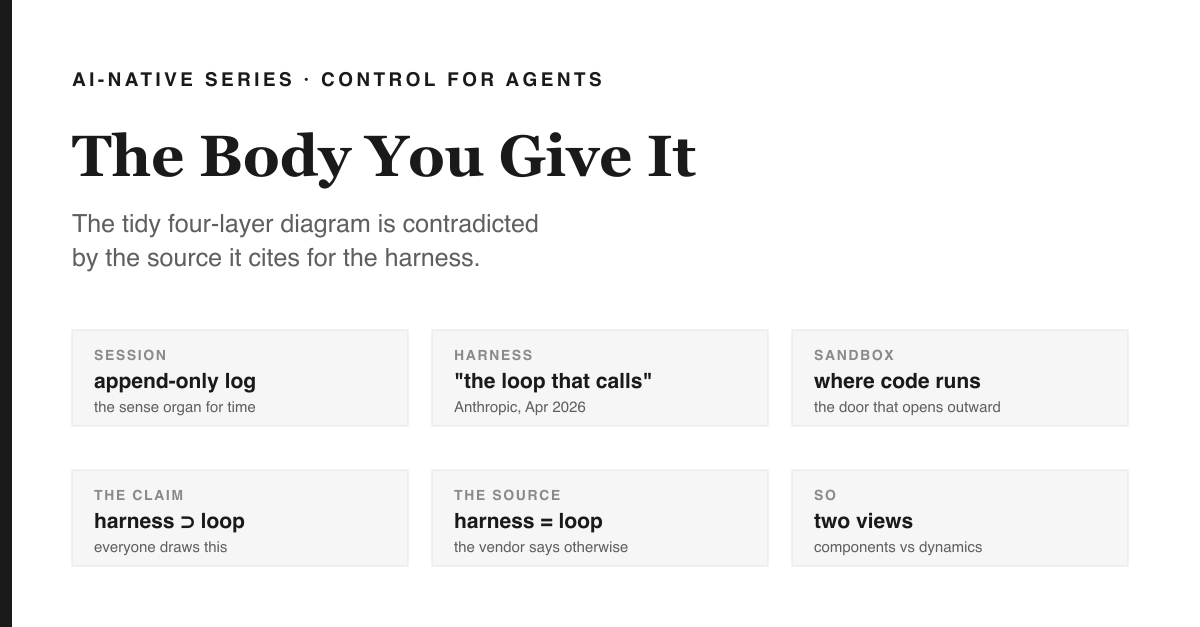
Dejas de intentar escribir mejores instrucciones y empiezas a construir la sala donde el modelo trabaja: herramientas, sandbox, ensamblaje de contexto, permisos y un registro de sesión de solo agregado. Y entonces el vocabulario se rompe — Anthropic's Scaling Managed Agents lo define así: “the loop that calls Claude and routes Claude's tool calls” (Traducción: el bucle que llama a Claude y enruta las llamadas de herramientas de Claude), así que harness y loop no son dos capas, sino dos perspectivas sobre el mismo objeto. El resultado práctico es que se aclara la atribución: el clásico “el modelo empeoró después de 40 minutos” es en realidad un fallo del harness que se manifiesta con síntomas de fallo de prompt, porque el crecimiento de la transcripción expulsó la primera restricción declarada de la ventana de contexto.
A puerta fría
Dejas de buscar mejores instrucciones. En vez de eso, construyes la cocina.
Cuchillos al alcance. Una despensa etiquetada. Un termómetro. Un cubo de basura. Una puerta que solo se abre hacia afuera. Un cuaderno clavado a la mesa donde se anota cada plato que sale.
No has hecho que el cocinero sea más inteligente. Has cambiado lo que el cocinero es capaz de hacer — y, más importante aún, lo que el cocinero es capaz de descubrir. Esto es ingeniería de harness, y ahí es donde vive hoy la mayor parte de la ingeniería real — esa capa a la que la literatura de prompts ya se estaba asomando antes de tener nombre propio (arXiv:2401.14423), y la misma que Promptware Engineering (arXiv:2503.02400) señaló cuando argumentó a favor de procesos alrededor de los prompts, en vez de solo mejores palabras.
Luego buscas la definición, y el diagrama ordenado que todos dibujan se desmorona.
La definición que desarma el diagrama
La versión habitual muestra cuatro capas: un prompt dentro de un harness, un harness ejecutando bucles, y un grafo que coordina los bucles. Es limpio, es didáctico, y su fuente más citada no está de acuerdo.
Scaling Managed Agents de AnthropicScaling Managed Agents (Anthropic, 2026a) descompone un agente en tres partes con nombre:
"una sesión (el registro de solo agregado de todo lo que ocurrió)" "un harness (el loop que llama a Claude y enruta las llamadas a herramientas de Claude a la infraestructura correspondiente)" "un sandbox (un entorno de ejecución —sandbox— donde Claude puede correr código y editar archivos)"
[DEF] Lee de nuevo la del medio. En la propia definición del proveedor, el harness es el loop — es decir, lo que llama al modelo y enruta sus llamadas a herramientas. No es un contenedor en el que el loop esté contenido.
[DISEÑO] Así que la "ingeniería de harness" y la "ingeniería de bucles" no son dos capas apiladas una sobre otra, sino dos perspectivas sobre el mismo objeto. Harness nombra los componentes — herramientas, sandbox, ensamblado de contexto, memoria, permisos, evaluaciones. Loop nombra la dinámica — lo que se repite, lo que se observa, cuándo se detiene. Puedes tener un harness con un loop desastroso, o un buen loop sobre un harness limitado; por eso vale la pena conservar ambos términos. Pero dibujar uno estrictamente dentro del otro es una afirmación que las fuentes no respaldan.
Equivalencias técnicas
| Cocina | Nombre técnico | Fallo que previene |
|---|---|---|
| Cuchillos al alcance | esquemas de herramientas / definiciones de funciones | el modelo narra una acción que no puede ejecutar |
| Despensa etiquetada | ensamblado de contexto / recuperación | trabajo seguro en el archivo equivocado |
| Termómetro | evaluaciones y ejecución de pruebas | "parece terminado" |
| Puerta que solo abre hacia afuera | sandbox + modelo de permisos | una corrección que borra producción |
| Cuaderno clavado en la mesa de trabajo | el registro de sesión (de solo agregado, append-only) | perder la razón detrás de una decisión |
| Espacio en la mesa de trabajo | presupuesto de ventana de contexto | cuando la instrucción más reciente desplaza la restricción más antigua |
Las afirmaciones, clasificadas
[DISEÑO] El harness es donde realmente se rompe el trabajo de larga duración — según la propia descripción de diseño del proveedor, que es un informe de diseño y no una medición. Anthropic: Effective harnesses for long-running agents (Anthropic, 2026b) está organizado precisamente en torno a los fallos que son invisibles en la capa de prompts: transferencia de estado, seguimiento del progreso, gestión y compactación del contexto, inicialización y sesiones incrementales. Esos no son problemas de prompt y ningún cambio de redacción los soluciona.
[ABIERTO] OpenAI: Harness engineering y Unrolling the Codex agent loop (OpenAI, 2026) describen el mismo cambio pero desde la perspectiva del otro proveedor: la superficie interesante de ingeniería es el entorno y la transformación de entrada de usuario → instrucciones → llamada al modelo → ejecución de herramienta → repetir, no solo la instrucción. (Ambas URLs devuelven 403 a un script simple — bloqueo de bots, no ausencia. No he leído el texto de ninguna de las dos páginas, por eso esta afirmación está marcada como abierta y no como evidenciada.)
[DISEÑO] Building Effective AI Agents (Anthropic, 2026c) traza la línea que todo el campo sigue redibujando: workflows son rutas de orquestación predefinidas; agents son sistemas donde el modelo controla dinámicamente el proceso y el uso de herramientas. Quédate con esa distinción — el Episodio 4 es enteramente sobre qué pasa cuando finges que uno es el otro.
[OPEN] Nadie ha publicado una métrica comparable para la calidad del harness. Podemos medir el éxito de la tarea de principio a fin, pero atribuir una mejora a la ingeniería de contexto, al diseño de herramientas o a la regla de parada del loop sigue sin resolverse — y es el mismo problema de atribución que quedó abierto en el Episodio 1, solo que una capa más arriba.
Puerta de predicción
Haz tu apuesta antes de seguir leyendo.
Un agente tiene una ventana de contexto de 200,000 tokens y un harness que agrega literalmente cada resultado de herramienta. Funciona perfecto durante 40 minutos, y luego empieza a cometer errores que no tenía en el minuto 5 — incluyendo repetir trabajo que ya había completado.
Apuesta: nombra el mecanismo. ¿Es el modelo que se degrada, el prompt que se deteriora, o el harness el que falla?
Si apostaste por "el modelo empeoró", acabas de cometer el error de atribución más común del campo. El modelo es idéntico. La restricción que se declaró primero fue expulsada de la ventana por la transcripción, y ahora el agente está optimizando contra una versión truncada de sus propias instrucciones. Esto es una falla del harness con síntomas de falla de prompt — por eso la compactación es una preocupación central de la ingeniería de harness, no un lujo.
Sala de fallos
Rómpelo a propósito: conserva todas las herramientas, elimina el registro de sesión.
Dale al agente acceso completo a las herramientas, un buen sandbox y un contexto fresco en cada turno, sin registro de solo agregado. Observa lo que pasa: repite trabajo ya hecho, se contradice con decisiones anteriores y — aquí está la pista — nunca se da cuenta, porque notar requiere comparar el ahora con el antes.
Diagnóstico: el registro de sesión no es almacenamiento, es el órgano sensorial del tiempo. Si lo quitas, no has hecho que el agente sea más lento; lo has dejado incapaz de tener un loop en absoluto. Y justo ahí está el pase al Episodio 3, y por eso la definición del proveedor pone sesión y harness uno al lado del otro.
Laboratorio — 15 minutos
Mide lo que nadie mide: costo de ensamblado de contexto.
- Instrumenta una tarea de agente. Registra, por turno: tokens de instrucción, tokens de contexto recuperado, tokens de transcripción, y si el turno tuvo éxito.
- Grafica los tres componentes a lo largo de la ejecución. En la mayoría de los sistemas, la instrucción se mantiene estable, la recuperación muestra picos, y la transcripción crece de forma monótona hasta que domina.
- Ahora limita la transcripción al 50% de la ventana usando un truncamiento ingenuo y vuelve a ejecutar. Observa el cambio en el patrón de fallo, no solo en la tasa — el truncamiento ingenuo suele transformar un "lento y correcto" en un "rápido y confiadamente equivocado".
El número que buscas es el índice de turno en el que la transcripción supera a la instrucción. A partir de ese punto, tu prompt pasa a ser un accionista minoritario en su propio contexto.
Misión Realidad
Toma un agente que realmente ejecutes. Escribe su harness en una sola página bajo seis apartados: herramientas, límite del sandbox, ensamblaje de contexto, memoria/sesión, permisos, evaluaciones. Cualquier apartado que no puedas completar directamente desde el código — no desde la intención — es una parte huérfana de tu sistema. En mi propio motor, ese ejercicio fue lo que convirtió un revoltijo de flags en un archivo revisable, y la compuerta de análisis que surgió de ahí es el tema de un artículo aparte, Saqué 100% en mi propia lista de verificación.
Desafío de investigación
Usa un agente para construir la métrica de harness que falta. Fija el modelo y el loop; varía solo el ensamblaje de contexto entre tres estrategias (transcripción completa, ventana de recencia, resumir y fijar restricciones) en la misma batería de tareas. Reporta la tasa de éxito y el índice de turno donde la transcripción supera a la instrucción. La hipótesis a probar: el segundo número predice el primero mejor que cualquier edición del prompt. Actualmente [OPEN].
Prueba de salida
- En la propia descomposición de Anthropic, ¿qué es un harness? (the loop that calls the model and routes its tool calls) (Traducción: el loop que llama al modelo y enruta las llamadas a herramientas)
- ¿Por qué "harness dentro del cual corre el loop" es una afirmación y no una definición?
- Menciona un fallo que parece un problema de prompt pero en realidad es un problema de harness.(una restricción declarada que es expulsada del contexto por el crecimiento de la transcripción)
Continuará
Tienes un cuerpo, una despensa, un termómetro y un cuaderno. Los platos salen y regresan, y ahora puedes ver cómo regresan. Así que empiezas a hacer lo obvio: lees el plato que vuelve, ajustas, envías otra nota. Leer, ajustar, enviar. Leer, ajustar, enviar.
Acabas de construir un bucle de retroalimentación, y estás a punto de descubrir que este es el objeto más antiguo y profundamente analizado de toda la temporada — y que la única pregunta que el siglo XIX aprendió a hacer sobre él es una pregunta que tu stack de agentes aún no puede expresar.
Lee también
Episodio 2 de Intelligence Engineering Adventures, Temporada 6 — El Motor Gobernador. Las afirmaciones en la fuente de la serie están etiquetadas por clase — definición, derivación, evidencia, decisión de ingeniería, pregunta abierta — y una metáfora puede introducir una afirmación pero nunca sirve como evidencia. La temporada toma en serio el diagrama de cuatro etiquetas y lo contrasta con sus fuentes primarias, y no sobrevive: la definición de Anthropic convierte el harness en el loop, no en una capa superior. Cada afirmación está etiquetada por clase, y el único problema realmente abierto se declara como tal — nadie ha publicado un criterio de estabilidad para un bucle de control de LLM. Este artículo no contiene material de ningún empleador ni cliente. — Paul Jialiang Wu · futuremake.io
Referencias
- (Anthropic, 2026a) Scaling Managed Agents: Decoupling the brain from the hands (8 de abril de 2026) — la descomposición en session / harness / sandbox; citado textualmente arriba.https://www.anthropic.com/engineering/managed-agents
- (Anthropic, 2026b) Effective harnesses for long-running agents — transferencia de estado, seguimiento del progreso, gestión de contexto y compactación. https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
- (Anthropic, 2026c) Construir agentes de IA efectivos — flujos de trabajo (rutas predefinidas) frente a agentes (proceso y uso de herramientas controlados por el modelo). https://www.anthropic.com/engineering/building-effective-agents
- (OpenAI, 2026) Harness engineering: leveraging Codex in an agent-first world; Unrolling the Codex agent loop. Ambos devolvieron HTTP 403 ante una consulta automatizada el 24/08/2026 (protección anti-bots); citado a partir de la descripción del brief, no de texto que yo haya leído.