AI-Native 系列 · ANDON · 智能体化 PR 审查与 CI/CD · 第 5 集(共 5 集)
负向测试:闸门只有见红过才算真正装好
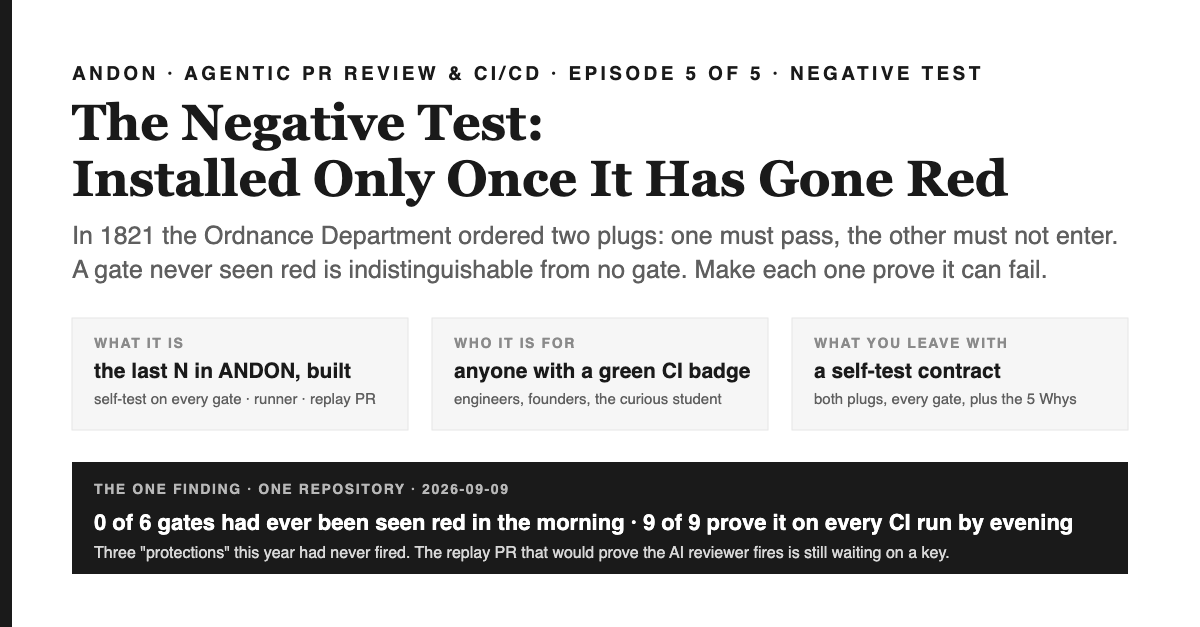
智能体化 PR 审查与 CI/CD,第 5 集,也是最后一集。1821 年,美国军械部下令每支滑膛枪管配两根塞子,一根必须能通过,一根必须不能通过,因为只会显示“通过”的量规毫无意义。大多数持续集成流水线里,充斥着只会显示通过的量规。本集是 ANDON 里的第二个 N,即负向测试。讲述了某仓库的早晨,六道闸门无一见红,以及傍晚,每道闸门都带上了自测用的两根塞子,runner 拒绝任何缺少这对塞子的闸门;三道从未触发的保护措施;还在等密钥的 replay PR;以及本赛季的记分板。
1 分钟重点 —— 你能带走什么
本集是什么。 第 5 集,出自 ANDON,这是智能体化 PR 审查与 CI/CD 五集系列的最后一集。本集聚焦于这样一条规则:负向测试,作为自测契约,直接内建进真实仓库:每道闸门都自带一个必须通过的内置夹具和一个必须失败的内置夹具,CI 里的 runner 会枚举所有闸门,任何闸门缺少这对夹具就直接报红;同时还会有一个 replay PR,重新引入一个已知缺陷,只有当 AI 审查员能准确报红后,才允许它被信任为绿色。
为什么重要? 对工程师来说:一扇从未触发过的闸门和一扇根本无法触发的闸门没有区别,而这个仓库里有三道保护其实属于后者。对创始人来说:Google 测量过,"84% of transitions from Pass -> Fail are from 'flaky' tests"(中译:84% 的通过转失败都是“不稳定测试”),这正是同一个量具的另一种失效:没人信的红灯等于没人看的闸门。对学生来说:1821 年那对塞子,就是整个思路的两块钢。
读完你可以做什么? 给你依赖的每一道闸门都加上自测,确保有一对塞子。加一个 runner,拒绝任何没有这对夹具的闸门,并把 runner 也纳入闸门体系。留一个真实历史缺陷的 replay PR,直到你的审查员能抓住它。最后,像开头一样收尾:所有尚未可展示的数据都标记为“未测量”。
ANDON — 系列脉络
- A · 评估——PR 洪水是量出来的,不是凭感觉 第 1 集
- N·永不沉默——给仓库装上 Jidoka 第 2 集
- D · Data, not prose——不会漂移的规则 第 3 集
- O · Only in the envelope——爆炸半径是一份路径清单 第 4 集
- N · 负向测试 —— 闸门必须先报红,才能上线 本集
本集讲什么,以及为什么负向测试要放在最后
前四集搭建了一台决策机器:没有主观判断的闸门、有第三种“无法运行”状态、规则以数据为本、还有限定 bot 合法操作范围的 envelope。每一项其实都是在承诺:坏情况来临时,这段代码会怎么表现。本集要讲的,是唯一能验证这些承诺的方法——故意让坏情况通过,看闸门是否真的会报红。它之所以放在最后,是因为它是对前面所有内容的检验,也是仓库里被违反最久、最容易被忽视的一条规则。
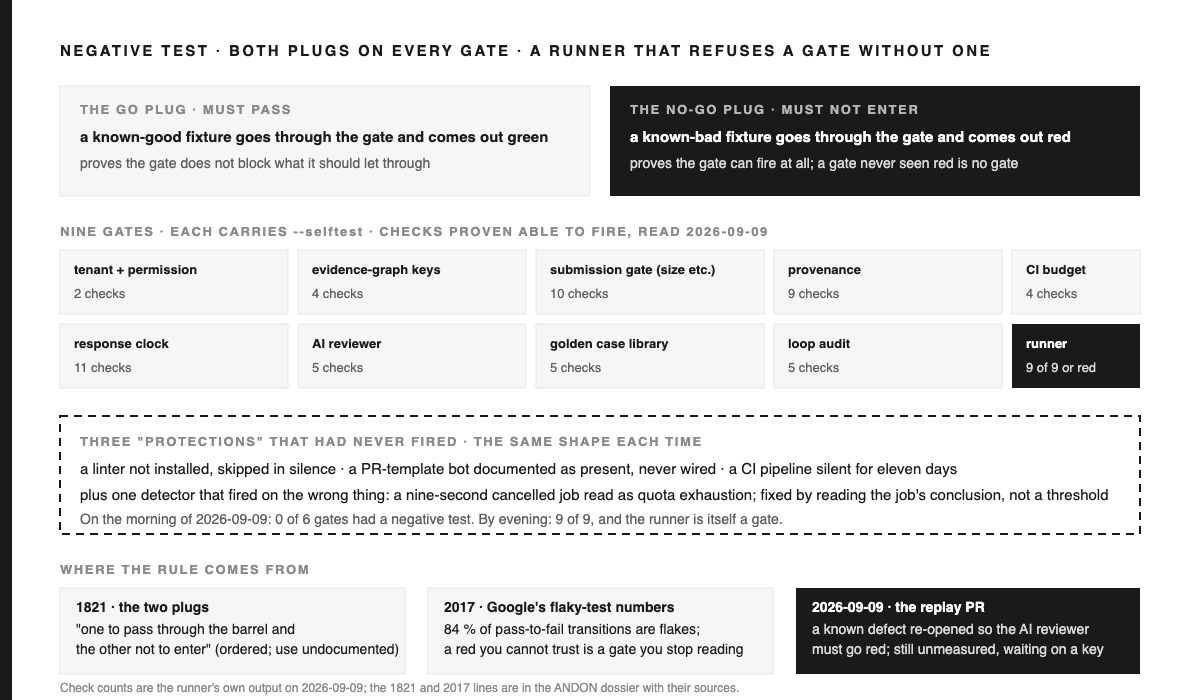
早晨的统计就是全部论据。2026-09-09 这天早上,在第 1 集的洪水闸门还没上线前,仓库的 CI 里有 6 个闸门脚本,但没有一个有负向测试。它们从未被证明能触发。lessons 文件记录了前几周的三起同类型事件:一个未安装的 linter 被静默跳过,一个文档里写着“已接入”但实际上根本没接线的 PR 模板 bot,还有一个连续 11 天都没发声的 CI 流水线。每次,所谓的“保护”其实从未做过保护应做的事,但没人能分辨,因为它产出的绿灯和一个真正工作的闸门一模一样。
所以本集的规则是:只有当一道闸门在故意触发下变红,并且能变红的证明随闸门一同交付,这道闸门才算真正安装完成。.
这条规则最早的版本:一根塞子必须能通过,另一根必须不能通过。
“通止规”比控制图、检查表和安灯绳都要早。根据斯普林菲尔德兵工厂的史料,Bomford 在 1821 年为军械部制定的滑膛枪检验规范中要求:"two plugs for the bore diameter, with one to pass through the barrel and the other not to enter"(中译:每根枪管都要配两根塞子,一根必须能通过枪管,另一根必须不能插进去) [1。必须用两根塞子,而不是一根。因为能通过 go 塞的枪管,只能说明它不算太小,只有 no-go 塞插不进去,才能证明它不算太大。只有一根塞子的量规等于只做了一半的测试。档案中特别注明了这个日期的警示,本集也保留了:这些塞子是下令采购于 1821 年;但档案没有显示它们真的投入使用,最早有据可查的一对,也不等同于最早实际用过的一对。
两端的传承,其实都在用不同的金属表达同一个道理。Honoré Blanc 于 1785 年 7 月在 Vincennes,Roser 的复原记载了:"disassembled 50 locks, picked pieces for 25 locks at random, and … assembled them again"(中译:拆解了 50 把锁,从中随机挑出 25 把的零件,再……重新组装) [2:演示本身就是测试,随机挑选的意义在于装配工无法只挑那些一定能装配成功的零件。1896 年,瑞典步枪厂的武器检验员 Carl Edward Johansson 发明了组合量块组 [3:这是一套可以校验检具本身的标准件,让量规也有了量规。所有这些做法,都是用“必须能通过的标准件”和“必须能拒绝的标准件”来替代“看起来没问题”,而且标准件的选择方式保证检验员无法挑选有利样本。
第一集里的厨房场景还有最后一环。每盘菜都要称重的秤之所以值得信任,是因为开餐前会先放上一个已知重量的砝码,确认读数准确,然后还会递给检查员一盘故意少五十克的菜,必须被退回。只会通过的检查员,可能什么都放行。自检,就是这套已知砝码和短斤缺两的盘子,每次开餐都要做一遍。
| 厨房 | 代码仓库 |
|---|---|
| 开餐前放在秤上的已知砝码,读数必须准确 | go 塞:每道闸门都必须通过的内置已知良品夹具 |
| 故意少五十克的盘子,检查员必须退回 | no-go 塞:每道闸门都必须拒绝的内置已知不良夹具 |
| 开餐前的检查清单,所有秤都检查过,否则厨房不开门 | runner:枚举每道闸门,运行自检,任何闸门缺失或自检失败就整体报红;runner 本身也是一道闸门 |
| 上个月被退回的一道菜,再做一遍,看新厨师能不能发现问题 | replay PR:重现已知历史缺陷,AI reviewer 必须变红 |
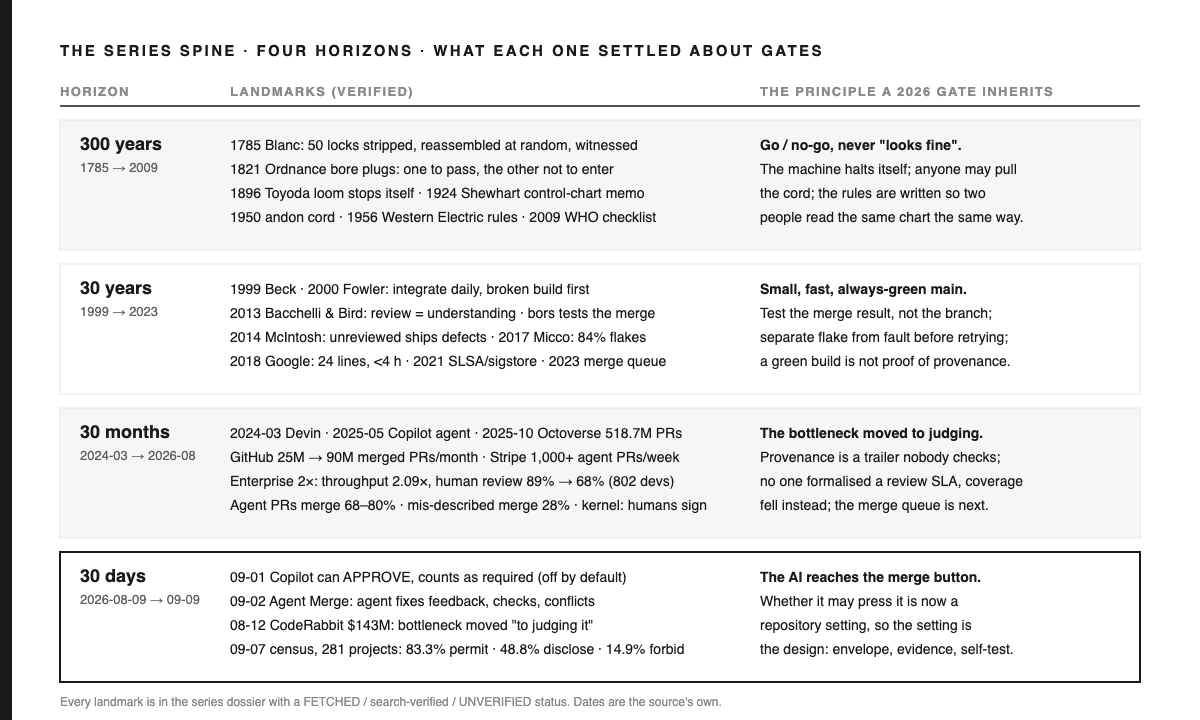
三十年后的版本:一个你无法信任的红灯,就是一道你会直接忽略的闸门。
软件工程的记录还揭示了同一个量具的另一种失效方式。一个永远不会触发的闸门是一种问题;一个在没有任何问题时也会触发的闸门,则是同一问题的另一面——最终都会让人对闸门视而不见。Google 2017 年对自家持续集成的测量是业界的标杆数据:"84% of transitions from Pass ->"84% of transitions from Pass -> Fail are from 'flaky' tests"(中译:84% 的通过转失败,都是由“不稳定测试”引起的),以及"Almost 16% of our 4.2M tests have some level of flakiness"(中译:我们 420 万个测试中,近 16% 存在一定程度的不稳定) [4。一年前,同一作者还报告过"about 1.5% of all test runs reporting a 'flaky' result."(中译:大约 1.5% 的测试运行报告了“不稳定”结果) [5。2014 年那篇归纳原因的实证研究发现:"The top three categories of flaky tests are Async Wait, Concurrency, and Test Order Dependency."(中译:不稳定测试的前三大类别是异步等待、并发和测试顺序依赖),并且"Most flaky tests (78%) are flaky the first time they are written."(中译:大多数不稳定测试(78%)在首次编写时就已经不稳定) [6。Google 的后续研究还发现:"larger tests are more flaky"(中译:测试规模越大,不稳定性越高) [7,这其实就是第 4 集里体积闸门从另一个角度的体现。
在 Google 这种体量下,每天要处理"more than 50,000 unique changes and running more than four billion individual test cases"(中译:每天超过 5 万次独立变更、执行 40 亿个单独测试用例),应对不稳定测试的办法只能靠基础设施。Chromium 的提交队列把重试规则写得很直接:8"If the retry succeeds, then the failure is ignored."(中译:如果重试成功,则本次失败被忽略)。而对小型仓库来说,答案和 1821 年那对塞子一样:你得知道每个闸门在已知坏输入和已知好输入下分别会做什么,这样红灯就是红灯,绿灯就是绿灯。自测机制让闸门自身的信号足够可靠,无需依赖重试。 [9这里还得补上一条历史注脚,因为它关乎检查表的起源,也颠覆了一个广为流传的故事。1935 年 Model 299 坠机事故,通常被认为催生了飞行前检查表,其实是因为阵风锁被遗忘未解除,而航空安全报告里记载,究竟是谁忘了解除阵风锁,
"is not clear."(中译:并不清楚)。检查表正是为了解决“无法确认”而诞生的,自测机制的意义也在于此。 [10构建方案:每个闸门都配双塞子、自测 runner 和 replay PR
1. 自测契约
现在,所有 CI 和 gate target 里的九个闸门都支持 self-test 标志。加上这个标志运行时,闸门不会读取仓库内容,而是在内存里自造测试用例:比如缺少租户过滤的路由查询、带 agent 标记但没有 trace trailer 的提交信息、没有理由的豁免策略、包含被取消的零步骤 job 的 workflow job 集合、以及 id 被改动的规则表。每个用例都各自运行检查,并分别断言:已知坏用例必须能检测出问题,已知好用例则必须什么都不报。它会输出本次跑了多少个检查,任何断言失败就非零退出。这个契约在仓库的 lessons 文件里用一句话写明:只测一个方向的测试等于没测。
2026-09-09 晚上,runner 的实际输出:tenant-and-permission 闸门证明能触发 2 个检查,evidence-graph 闸门 4 个,submission 闸门 10 个,provenance 闸门 9 个,CI-budget 检测器 4 个,response clock 11 个,AI reviewer 5 个,golden case 库 5 个,loop audit 5 个。九个闸门,每一个现在都在每次 CI 里自己被验证能报红。
2. runner 本身也是一个闸门
闸门带着 self-test 但没人去跑,等于又变成了文档。所以 runner 把闸门列表作为数据,依次跑每个闸门的 self-test,遇到列表里有闸门缺失、缺标志或断言失败就直接报红。runner 既在本地 gate 命令里,也在 CI 里,它就是仓库自带 review 规则的机器实现:每个闸门必须证明自己能触发。runner 无法发现没被列进列表的闸门;列表的完整性由 loop audit 的结构性标准(点名这九个闸门)和 review 规则共同保证。loop audit 本身也是带着 self-test 写好、同一个 PR 加进列表的。
3. 检测器误报
1821 年规则的另一半,在 2026-09-09 的清单里现身了。仓库有个检测器,专门监控 Actions 的运行历史,查配额耗尽的指纹——在这个方案下表现为 job 步骤数为零。回溯最近 60 次运行,它只触发过一次:2026-09-05 有次 push 到 main,迁移 job 步骤数为零,因为下一个 push 在 9 秒后就顶掉了它,按并发规则处理。检测器的指纹误把这次取消当成了配额耗尽。修复不是加阈值。job 自带结论字段,被取消的 job 会明说自己被取消了;现在检测器会先读结论,把 cancelled、skipped 和 neutral 的 job 都排除在指纹之外,self-test 里也加了一个必须不能触发的 cancelled 零步骤 job。检测器误报,就像 no-go 塞偶尔能插进去一样,团队只要见过一次误报就不会再信它。lessons 文件还记录着更早一次配额耗尽其实没人发现。
4. replay PR
AI reviewer 和其他闸门一样有 self-test,但它的 self-test 只测不需要模型的部分:比如 evidence filter、tier classifier、brief renderer。模型本身的判断只能靠真实案例来验证。所以前文的 build 专门开了个 PR,把仓库历史里一个已知、已修复的缺陷(曾经允许投诉在没过 closure gate 的情况下被关闭)重新引入,并标记为“do not merge”。reviewer 针对这个缺陷的规则已经有了;这个 PR 就是它的 no-go 塞。写这篇文章时,replay PR 从 2026-09-06 起一直开着,只有一个 brief,401 状态下未测;仓库里 11 个 brief 都是同样的情况,因为每次跑 key 都被拒。它故意保持开启,有书面理由豁免 response clock,直到 reviewer 真正报红一次。前文承诺要说结果的那句,现在只能说:还没到。
同一天晚上更新。 大约 20:00 UTC,有效 key 到了仓库,reviewer 在 replay PR 上重新跑了一遍。它报红了:四个 block 级别的发现,每个都带文件和行号,点名了 bypass、被移除的白名单、缺失的 close audit 和被删的测试,并要求人工处理而不是直接通过。no-go 塞没有插进去。loop audit 的“AI has measured a PR”那一行下次跑就变绿了;“Tier-1 has merged once”还在等计划落地。
五问:为什么闸门只有红过才算装好
| # | 为什么? | 因为 | 证据 |
|---|---|---|---|
| 1 | 为什么一个从未报红的闸门给的绿灯没有意义? | 因为一个永远不会触发的闸门,产出的绿灯和一个什么都没发现的闸门完全一样,输出里没有任何区别。 | 同一个仓库里有三道保护从未触发过;每个都被认为在工作,直到被实际检查。 |
| 2 | 为什么证明必须和闸门一起交付,而不是只做一次? | 因为闸门会变;装好时做的证明,对它第五次被编辑后毫无意义,而那个改坏它的编辑不会自带警告。 | runner 每次 CI 都会跑所有列出的 self-test;loop audit 带着 self-test 和它在列表里的位置一起进了同一个 PR。 |
| 3 | 为什么要 go 塞和 no-go 塞都要有? | 因为一个什么都拦的闸门和一个什么都不拦的闸门一样快被人无视;go 塞才让红色有意义。 | Google: 84 percent of pass-to-fail transitions were flakes [(中译:Google:84% 的通过转失败都是“不稳定测试”)4]; 预算检测器在已取消任务上的误报 |
| 4 | 为什么 runner 本身也必须是一个闸门? | 因为没人去跑的自测只是一句写在文件里的话;第三集的规则说,规则必须能 diff,第二集的规则说,检查如果只在 merge 决策看不到的地方运行,就等于没运行。 | runner 既在本地 gate 命令里,也在 CI 里。只要列表里有闸门缺失、缺 flag,或自测失败,就直接红灯退出。 |
| 5 | 为什么要让 replay PR 保持开启且不计量? | 因为唯一无法用 fixture 测试判断的闸门就是模型本身,唯一诚实的状态只有“已在已知缺陷上变红”或“还没有”;如果关掉 PR,就把“还没有”变成了沉默。 | replay PR 目前只有一个 brief,401 状态下未计量;有书面理由豁免 response clock |
核心一句话:只有当同一个闸门在最近一次变更后,已被已知坏输入成功触发红灯时,它的绿灯才算作证据,这个“被看到变红”必须是闸门自身的一部分。
30 分钟构建:自测契约
三十分钟是给照搬实现的读者预留的预算,不是我实际测过的时间。
| 要素 | 规范 |
|---|---|
| 自测 flag | 每个闸门都要支持 --selftest。它在内存中构造 fixture,不读取仓库内容,并双向断言:已知坏 ⇒ 必须有 finding;已知好 ⇒ 必须无 finding。 |
| 输出 | 一行:检查项数量,全部证明能触发。任何断言失败就非零退出。 |
| runner | gate 路径列表作为数据。每个都跑自测;文件缺失、缺 flag 或非零退出 ⇒ 红灯。runner 既在本地 gate target 也在 CI 里。 |
| 检测器指纹 | 匹配形状前先读取平台自带的 conclusion 字段;排除 cancelled、skipped 和 neutral。把导致你学会这点的误报加进自测,作为必须不能触发的 fixture。 |
| replay PR | 一个重新引入真实已修复缺陷的 PR,标记 do-not-merge,有书面理由豁免 response clock,只有 reviewer 变红后才能关闭。 |
| 不变量 | 每个闸门、每次运行都必须满足:已知坏例 ⇒ 检出问题,已知好例 ⇒ 不检出问题。 |
| 停止规则 | 只要有列表中的闸门缺少这一对插头,或自测未通过,本次 CI 全部报红;没有任何内容能合并。 |
| 报告 | 循环审计的结构标准统计带自测的闸门数量,功能标准实际运行 runner;两者每次 CI 都会读取。 |
| 有意省略 | 闸门不做不稳定测试重试;没有共享 fixture 库;平台只在内存 fixture 层做最小 mock。每一项都避免让自测测别的东西而不是闸门本身。 |
# The contract is two assertions per rule, inside the gate itself.
def selftest():
    bad  = fixture_with(agent_marker=True, trace_trailer=False)   # must fire
    good = fixture_with(agent_marker=True, trace_trailer=True)    # must not
    assert check(bad),      "the gate never fires: not installed"
    assert not check(good), "the gate fires on a good input: will be ignored"
    print("selftest: 2 checks, all proven able to fire")

# The runner refuses a gate without one.
GATES = ["scripts/check_tenant_perm.py", "scripts/check_provenance.py", ...]   # data
for g in GATES:
    rc = run([python, g, "--selftest"])
    if rc != 0: fail(f"{g}: no self-test, or it failed")
同一原则,五种角色
| 读者 | 唯一的判断 | 唯一的行动 |
|---|---|---|
| 学生 | 一个你从没见它失败过的检查,不算检查。 | 挑一个“永远通过”的检查,给它一个必定失败的例子,看看结果。 |
| 工程师 | 每个闸门、每次运行都要带上两根插头。 | 把--selftest加进你今天最信任的闸门,配一个已知坏例和一个已知好例。 |
| 创始人 | 统计一下你们有多少闸门真的被见过变红。 | 本周就要这个数字。如果是零,README 上的徽章只是装饰。 |
| 高管 | 1821 年那两根插头成对出现,是有原因的。 | 请问你们有哪些控制措施有负向测试的文档,哪些只是“被认为没问题”? |
| 投资人 | 一个团队如果持续保持 replay PR 开启且未计量,就是在如实报告现状。 | 要求他们展示一次 gate 在团队自家 CI 历史中被故意触发报红的记录。 |
模式、反模式与第一性原理
有效的模式。 fixture 全部在内存中、正反两向、直接内置在闸门里。gate 列表作为数据交给 runner,runner 本身也是一个闸门。先读取结论再匹配形态。把一次误报变成 fixture。replay PR 持续保持开启并豁免,直到模型真的报红。
被替换掉的反模式。 没装时静默跳过的 linter;文档写着有但实际没接线的 bot;指纹会误判取消的检测器;六个“以为能用”但其实从未见过失败的闸门。
机制,命名如下。 自测把“闸门可用”从对过去的假设变成每次运行都能量化的事实,runner 则把“每个闸门都有自测”从约定变成红灯。
第一性原理,一句话。 你对闸门的信任度,应与你上次故意见它失败的时间成反比。
本季总览:一张表和记分板
ANDON 这一季是五条规则、一个仓库、一天的搭建,对照四重视角的记录。下表列出这五条,每条的字母、分集主旨,以及仓库中与之对应的实现,让你能直接对照代码而不是凭记忆。
| 字母 | 规则 | 主旨 | 仓库里的实现 |
|---|---|---|---|
| A | 用数字衡量 | 洪水用数据衡量,不靠体感;机器闸门是秤,不是厨师 | dossier 的实时测量;机器闸门只决定脚本能决定的事 |
| N | 永不沉默 | 无法运行的闸门会发“unmeasured”;response clock 用 cron 定时跑 | 审核员的第三种状态;SLA bot;循环审计的 P 标准 |
| D | 数据,而不是文字描述 | 规则必须可 diff;文档由规则渲染并校验 | 三个 JSON 文件;渲染器;手动验证为红的漂移检查 |
| O | 只在 envelope 内 | bot 可合并的路径清单;deny 优先;五个条件同时满足 | 自动合并 envelope;分层分类器;溯源和体积 gate |
| N | 负向测试 | gate 只有在故意被触发为红后才算安装,且验证要随 gate 一起交付 | 每个 gate 的自测;runner;replay PR |
| 赛季记分板 | 2026-09-09 早晨 | 2026-09-09 傍晚 |
|---|---|---|
| 最早未收到首次响应的开放 PR | 57 小时,3 个 PR | 还是那 3 个;已打标签,记分板上,依然无人回复 |
| 有自测证明能变红的 gate 数 | 6 个里有 0 个 | 9 个里有 9 个,由自身也是 gate 的 runner 强制执行 |
| 自 9 月 1 日以来带 trace trailer 的 agent 协助提交数 | 未测量 | 21 个里有 11 个;新提交由溯源 gate 强制要求 |
| 循环审计标准未测量 | 没有审计 | 2 / 23:AI 尚未评测任何 PR;Tier-1 尚未合并任何一个 |
| AI 简报已发布 / 静默 | 3 / 0 | 11 / 0,全部因密钥被拒绝而未测 |
这三行,就是本季最坦率的失败。第一行正是本季命名要解决的问题,结果并没有:三位联合创始人的 PR 整个季度都没人类回复。机器当天就贴上了标签,维护者始终没回应——这是人的选择,不是系统设置。后两行其实是同一问题的两种表现:一个密钥被拒,另一个计划还没进仓库。系列构建的所有机制,即使没有这两项,也能正常分类、发布、标记、审计和拒绝。系列里的任何机制,都不会自称已经评测或合并了 PR,除非真的发生。这是第一条规则,也是最后一条。
现实任务
第 4 集曾承诺,到第 5 集时,每道闸门都要通过自测证明能变红,replay PR 要么已经让 reviewer 首次测出问题,要么还在等密钥,文章会说明是哪种。第一个目标已实现:9 个闸门,CI 每次都能自测报红。第二个目标在发稿时还是“未测”状态,replay PR 上有一条未测简报,和仓库里另外十条一样;到晚上密钥到位,reviewer 在它上面报红,如前所述。本季的任务,没有下集可承接,就是记分板上的三行。第一行是人的任务,不是机器的:回复那三位联合创始人的 PR,记分板就会显示标签被移除。密钥轮换后,replay PR 的下一条简报会被测;reviewer 会在已知缺陷上报红,或者系列的核心论断就此被推翻,dossier 会记录是哪种。计划进仓后,一条命令装好分支保护,下一个 envelope 内的纯文档 PR 要么自动合并,要么 audit 会说明原因。
延伸阅读
第 5 集,ANDON · 智能体化 PR 审查与 CI/CD,最终章。所有数字都限定了作用范围;厨房只是模型,不是实测。自测、runner、检测器和 replay PR 都在私有仓库里;它们的结构已在合约中复刻,无需依赖访问权限。全季引用的四重视角 dossier,已记录在 portfolio 的 plans 目录下。
参考文献
- Raber、Malone、Gordon、Cooper,《Conservative Innovators and Military Small Arms: Springfield Armory 1794–1968》,NPS 1989/2006,第 138 页(Stubblefield 和 Lee 致 Bomford,1821-12-04,NARA RG 156/21)。npshistory.com
- Roser,《230 Years of Interchangeable Parts》,AllAboutLean,2015-07-08。allaboutlean.com
- Science Museum Group, Johansson 量块套装,约 1900 年,馆藏编号 co59398。collection.sciencemuseumgroup.org.uk
- Micco, The State of Continuous Integration Testing at Google,ICST 2017 主旨演讲。aster.or.jp
- Micco, Flaky Tests at Google and How We Mitigate Them, 2016-05-27. testing.googleblog.com
- Luo, Hariri, Eloussi, Marinov, An Empirical Analysis of Flaky Tests,FSE 2014。mir.cs.illinois.edu
- Listfield, Where do our flaky tests come from?, 2017-04-17. testing.googleblog.com
- Software Engineering at Google,第 23 章,持续集成,2020 年。abseil.io
- Chromium,Commit Queue 文档。chromium.googlesource.com
- Flight Safety Australia,一次只做一件事:清单的简史, 2018-11-12. flightsafetyaustralia.com