AI-Native 시리즈 · ANDON · 에이전트형 PR 리뷰와 CI/CD · 5화 중 5화
네거티브 테스트: 게이트는 반드시 한 번이라도 실패(레드)를 경험한 뒤에만 설치된다
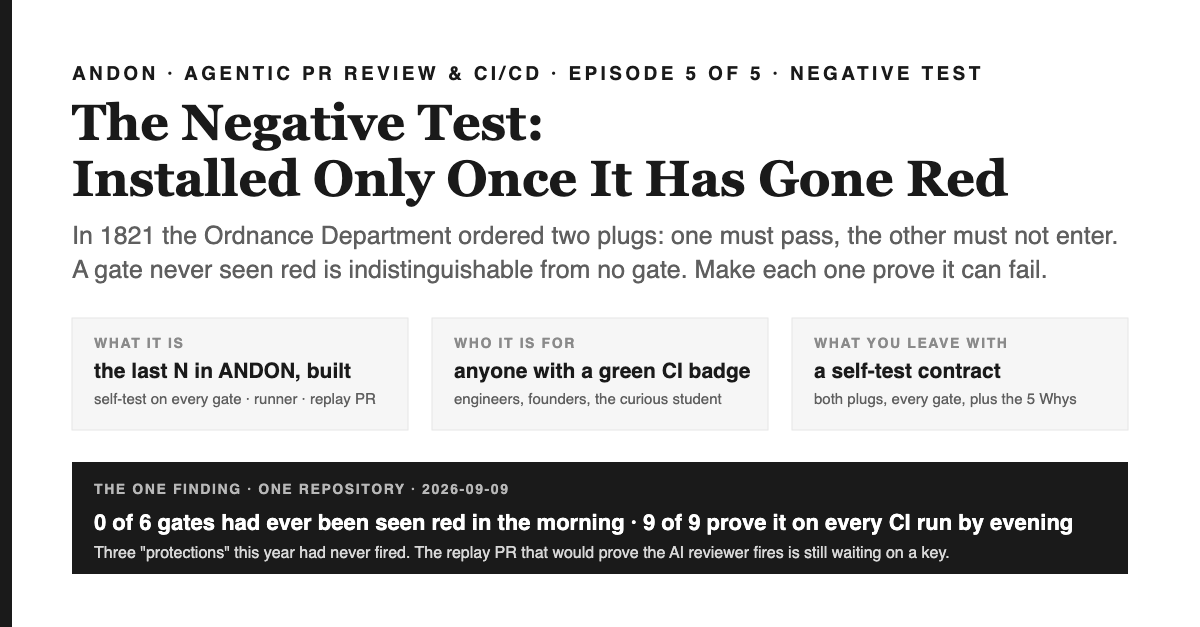
에이전트형 PR 리뷰와 CI/CD, 5화, 마지막 편이다. 1821년 미국 병기국은 머스킷 총신마다 두 개의 측정 플러그를 지시했다. 하나는 반드시 통과해야 하고, 하나는 절대 들어가면 안 된다. 오직 "통과"만을 말하는 계측기는 아무것도 알려주지 않는다. 대부분의 지속적 통합 파이프라인에는 통과만을 기록한 계측기가 가득하다. 이번 화는 ANDON의 두 번째 N, 즉 네거티브 테스트다. 한 저장소의 아침, 여섯 개의 게이트 중 단 하나도 실패(레드)를 낸 적이 없던 시점과, 저녁에는 모든 게이트가 두 개의 측정 플러그로 셀프 테스트를 갖추고, 실행기(러너)가 플러그 없는 게이트를 거부하게 된 시점, 한 번도 발동한 적 없는 세 가지 보호장치, 아직 인증키를 기다리는 리플레이 풀 리퀘스트, 그리고 시즌 스코어보드를 다룬다.
1분 요약 — 이 글을 읽고 얻어갈 것
이 글은 무엇인가. ANDON 5화 ANDON, 에이전트형 PR 리뷰와 CI/CD를 다루는 5부작 시리즈의 마지막 편이다. 이번 편의 규칙은 네거티브 테스트로, 실제 레포지토리에 내장된 셀프 테스트 컨트랙트다. 모든 게이트에는 반드시 통과해야 하는 내장 픽스처와 반드시 실패해야 하는 내장 픽스처가 함께 들어간다. CI에서는 모든 게이트를 하나씩 점검하며, 이 두 가지 테스트가 없는 게이트가 있으면 전체를 불합격(레드) 처리한다. 그리고 리플레이 풀 리퀘스트는 이미 알려진 결함을 다시 열어, AI 리뷰어가 실제로 불합격(레드)을 내야만 합격(그린)을 신뢰할 수 있도록 한다.
왜 중요한가. 엔지니어에게: 한 번도 발동된 적 없는 게이트는 애초에 발동할 수 없는 게이트와 구별할 수 없다. 실제로 이 레포지토리의 보호 장치 세 개가 바로 그런 무용지물이었다. 창업자에게: Google은 패스에서 실패로 전환된 경우의 84%가 플레이크(Flaky)였음을 측정했다. 이는 같은 게이지의 또 다른 실패다. 아무도 신뢰하지 않는 레드는 아무도 읽지 않는 게이트일 뿐이다. 학생에게: 1821년의 두 플러그는 이 아이디어의 본질을 두 조각의 강철로 보여준다.
읽고 나서 할 수 있는 일. 의존하는 모든 게이트에 반드시 통과하는 테스트와 반드시 실패하는 테스트(두 플러그)를 갖춘 셀프 테스트를 추가하라. 이 쌍이 없는 게이트는 거부하는 점검 스크립트(러너)를 만들고, 그 러너 자체도 게이트로 포함시켜라. 실제로 발생했던 결함을 리플레이하는 PR을 하나 열어두고, 리뷰어가 그 결함을 잡을 때까지 닫지 마라. 그리고 시즌의 시작처럼, 아직 측정할 수 없는 수치는 '미측정'으로 표시하며 마무리하라.
ANDON — 시리즈 줄기
- A · Assess — PR 홍수는 측정되는 것이지 느껴지는 것이 아니다 1화
- N · 침묵하지 않음 — 저장소를 위한 지도카 2화
- D · Data, not prose — 어긋날 수 없는 규칙 3화
- O · 경계선 내부에서만 — 영향 범위는 경로 목록으로 정한다 4화
- N · 네거티브 테스트 — 게이트는 반드시 실패(레드)를 경험한 뒤에만 설치된다 이번 화
이번 에피소드에서 다루는 내용과, 왜 네거티브 테스트가 마지막에 오는지
앞선 네 개의 에피소드는 판단하는 기계를 만들었다. 의견 없는 게이트, '실행 불가'라는 세 번째 상태, 데이터로 살아 있는 규칙, 그리고 봇이 머지할 수 있는 범위를 제한하는 봉투. 이 모든 것은 나쁜 상황이 닥쳤을 때 코드가 실제로 어떻게 동작할지에 대한 주장이다. 이번 편은 그 주장이 진짜임을 확인하는 유일한 방법, 즉 일부러 나쁜 케이스를 통과시켜 게이트가 실제로 실패(레드)를 내는 것을 직접 확인하는 데 관한 이야기다. 마지막에 오는 이유는, 앞서 만든 모든 것의 최종 시험이기 때문이고, 또 레포지토리가 가장 오래 어기고도 눈치채지 못했던 단 하나의 규칙이기 때문이다.
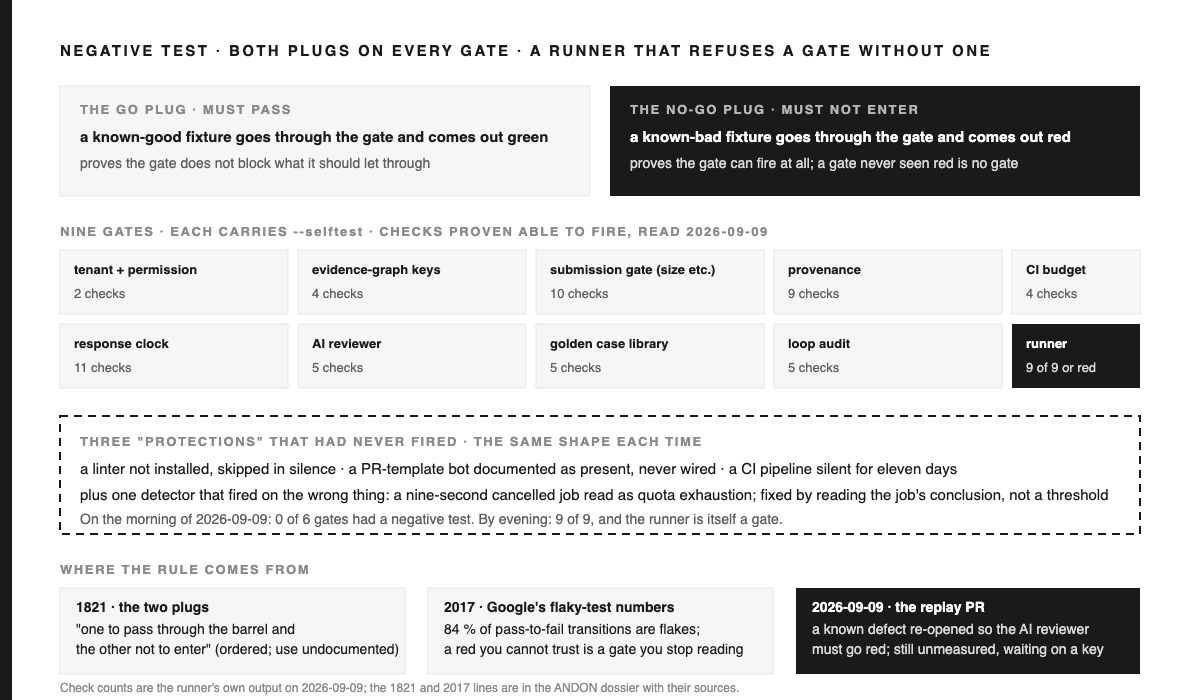
아침의 숫자가 곧 모든 논거다. 2026-09-09, 에피소드 1의 플러드 게이트가 만들어지기 전, 이 레포지토리의 CI에는 게이트 스크립트가 여섯 개 있었지만, 네거티브 테스트가 적용된 것은 하나도 없었다. 단 한 번도 실제로 발동된 적이 없었다. 기록 파일에는 직전 몇 주간 반복된 세 가지 사례가 남아 있다: 설치되지 않아 조용히 건너뛴 린터, 문서에는 있다고 되어 있지만 실제로는 연결된 적 없는 PR 템플릿 봇, 그리고 11일 동안 아무 반응이 없던 CI 파이프라인. 이 모든 경우, 보호 장치라고 불렸던 것이 실제로는 한 번도 보호 역할을 한 적이 없었고, 아무도 눈치채지 못했다. 왜냐하면 그들이 내놓는 합격(그린) 신호는 실제로 작동하는 게이트가 내놓는 신호와 똑같이 보였기 때문이다.
그래서 이번 편의 규칙은 다음과 같다:게이트는 반드시 의도적으로 한 번이라도 실패(레드 신호)를 낸 뒤에만 설치된다. 그리고 그 게이트가 실제로 실패할 수 있다는 증거가 함께 제공되어야 한다..
이 규칙의 가장 오래된 형태: 하나는 반드시 통과해야 하고, 다른 하나는 반드시 들어가지 못해야 한다.
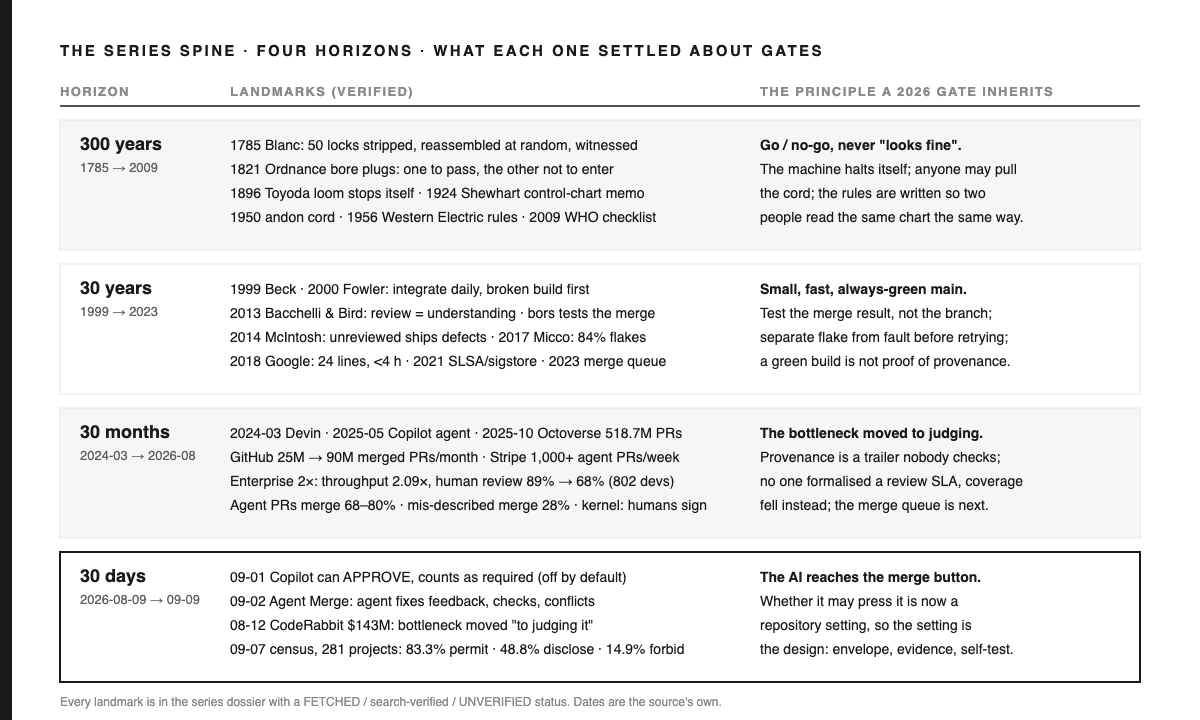
합격/불합격(Go/No-Go) 게이지는 관리도, 체크리스트, 안돈 코드보다도 오래된 개념이다. Springfield Armory의 기록에 따르면, 1821년 Bomford가 Ordnance Department의 머스킷 검사 지침에서 다음과 같이 지시했다. "two plugs for the bore diameter, with one to pass through the barrel and the other not to enter" (번역: 총열 구경에 맞는 플러그 두 개를 준비하되, 하나는 총열을 통과해야 하고, 다른 하나는 들어가지 못해야 한다) [1]. 플러그는 반드시 두 개여야 한다. 합격 플러그가 들어가면 총열이 너무 작지 않다는 뜻이고, 불합격 플러그가 들어가지 않으면 너무 크지 않다는 뜻이다. 플러그가 하나뿐인 게이지는 반쪽짜리 테스트에 불과하다. 이 에피소드가 강조하는 주의사항도 기록에 남아 있다. 즉, 이 플러그들은 1821년에 지시되었으나 실제 사용 기록은 남아 있지 않으며, 최초로 문서화된 한 쌍이 실제로 사용된 첫 사례와 동일하다는 근거는 없다.
역사의 양쪽 흐름 모두 금속만 다를 뿐 같은 원리를 말한다. 1785년 7월 Vincennes에서 Honoré Blanc가 Roser의 재구성에 따르면, "disassembled 50 locks, picked pieces for 25 locks at random, and … assembled them again" (번역: 자물쇠 50개를 분해하고, 그중 25개의 부품을 무작위로 골라 다시 조립했다) [2]: 이 시연 자체가 곧 테스트였고, 무작위 선택의 목적은 조립자가 통과할 부품만 고를 수 없게 하는 데 있었다. 그리고 1896년, 스웨덴 소총 공장의 무기 검사관 Carl Edward Johansson이 조합형 게이지 블록 세트를 발명했다 [3]: 검사 도구 자체를 검증할 수 있는 기준점이 생긴 것이다. 즉, 게이지에도 게이지가 필요하다는 뜻이다. 이 모든 사례는 '겉보기에 괜찮다'는 주관적 판단 대신, 반드시 통과해야 할 기준과 반드시 거부해야 할 기준을 도입해, 검사자가 임의로 샘플을 고를 수 없게 만든다.
1화의 주방 그림에는 마지막 조각이 있다. 모든 접시를 재는 저울이 신뢰받는 이유는, 서비스 시작 전에 누군가가 미리 알고 있는 무게를 올려 수치를 확인하고, 이어서 검사자에게 일부러 50g 부족한 접시를 건네 반드시 반려하도록 하기 때문이다. 한 번도 접시를 반려해 본 적 없는 검사자는 사실상 모든 것을 통과시키고 있을 수도 있다. 셀프 테스트란, 주방이 열릴 때마다 반복되는 이 '알려진 무게'와 '부족한 접시'의 과정이다.
| 주방 | 저장소 |
|---|---|
| 서비스 시작 전 저울에 올리는, 반드시 정확히 측정되어야 하는 기준 무게 | 합격 플러그: 모든 게이트가 반드시 통과해야 하는 내장 정상 케이스(픽스처) |
| 일부러 50g 부족하게 만든 접시, 검사자가 반드시 반려해야 하는 것 | 불합격 플러그: 모든 게이트가 반드시 실패해야 하는 내장 비정상 케이스(픽스처) |
| 모든 저울이 점검되었음을 확인하는 오프닝 체크리스트, 아니면 주방은 열리지 않는다 | 테스트 러너: 모든 게이트를 나열하고, 각 게이트의 셀프 테스트를 실행하며, 쌍이 없거나 실패하는 게이트가 있으면 전체를 실패(레드)로 처리한다. 이 러너 자체도 하나의 게이트다. |
| 지난달 반려된 요리를 다시 만들어, 새 요리사가 이를 잡아내는지 확인하는 것 | 리플레이 PR: 과거에 이미 알려진 결함을 다시 열어, AI 리뷰어가 반드시 실패(레드 신호)를 내도록 만드는 것 |
30년의 교훈: 신뢰할 수 없는 실패(레드)는, 더 이상 읽히지 않는 게이트다.
소프트웨어의 기록은 같은 게이지에서 비롯된 또 다른 실패 사례를 보여준다. 한 번도 실패(레드)를 낸 적 없는 게이트가 문제라면, 아무 문제도 없는데도 실패를 내는 게이트 역시 반대 방향의 같은 문제다. 둘 다 결국 신뢰를 잃고 무시당한다. Google이 2017년 자체 CI에서 측정한 수치가 대표적이다: "84% of transitions from Pass ->"84% of transitions from Pass -> Fail are from 'flaky' tests"(번역: 통과에서 실패로 전환된 사례의 84%가 '플레이키' 테스트 때문이었다), 그리고 "Almost 16% of our 4.2M tests have some level of flakiness"(번역: 전체 420만 건의 테스트 중 거의 16%가 어느 정도의 불안정성을 보였다) [4] 1년 전, 같은 저자는 다음과 같이 보고했다: "about 1.5% of all test runs reporting a 'flaky' result."(번역: 전체 테스트 실행 중 약 1.5%가 '플레이키' 결과를 기록했다) [5] 2014년, 원인을 분석한 실증 연구에서는 "The top three categories of flaky tests are Async Wait, Concurrency, and Test Order Dependency."(번역: 플레이키 테스트의 주요 세 가지 원인은 비동기 대기, 동시성, 테스트 순서 의존성이다) 그리고 "Most flaky tests (78%) are flaky the first time they are written."(번역: 플레이키 테스트의 78%는 처음 작성될 때부터 이미 불안정하다) [6] Google의 후속 연구에서는 "larger tests are more flaky"(번역: 규모가 큰 테스트일수록 플레이키하다) [7는 사실도 밝혀졌다. 이는 에피소드 4에서 다룬 사이즈 게이트가 다른 각도에서 다시 등장한 셈이다.
Google처럼 "more than 50,000 unique changes and running more than four billion individual test cases"(번역: 하루에 5만 건이 넘는 고유 변경과 40억 건이 넘는 개별 테스트 케이스 실행)이 매일 이뤄지는 규모에서는,8 플레이키 문제의 해법은 인프라다. Chromium의 커밋 큐는 재시도 규칙을 명확히 밝힌다: "If the retry succeeds, then the failure is ignored."(번역: 재시도가 성공하면, 그 실패는 무시된다) [9] 소규모 레포지토리라면 1821년의 플러그 원칙과 똑같은 해답이 적용된다. 즉, 모든 게이트가 '알려진 불량 입력'과 '알려진 정상 입력'에 대해 각각 어떻게 반응하는지 반드시 확인해야 한다. 그래야 실패 신호(레드)는 진짜 실패이고, 통과 신호(그린)도 진짜 통과임을 믿을 수 있다. 셀프 테스트는 바로 이 신호를 재시도 없이 신뢰할 수 있게 해주는 장치다.
여기에 한 가지 역사적 일화가 더 있다. 체크리스트의 기원에 관한 이야기인데, 익숙한 서사를 뒤집는다. 1935년 Model 299 추락 사고—즉, 사전 비행 체크리스트의 발명으로 흔히 언급되는 그 사고—는 거스트 락이 해제되지 않은 채 남아 있었기 때문에 발생했다. 항공 안전 보고서에는 누가 락을 해제하지 않았는지에 대해 "is not clear."(번역: 명확하지 않다) [10]고 기록되어 있다. 체크리스트는 바로 '확인할 수 없었다'는 문제에 대한 대응이었다. 셀프 테스트 역시 같은 이유로 필요하다.
구현: 모든 게이트에 두 개의 측정 플러그, 실행기, 그리고 리플레이 PR
1. 셀프 테스트 규약
이제 게이트 타겟과 CI에 있는 모든 게이트, 총 아홉 개가 셀프 테스트 플래그를 지원한다. 이 플래그로 실행하면 게이트는 저장소를 전혀 참조하지 않는다. 대신 메모리 내에서 자체 픽스처를 만든다. 예를 들어, 테넌트 필터가 빠진 쿼리를 가진 라우터, 에이전트 마커는 있지만 트레이스 트레일러가 없는 커밋 메시지, 사유 없는 예외가 포함된 정책, 취소된 0단계 워크플로 잡이 들어 있는 잡 세트, ID 하나만 바뀐 규칙 테이블 등이 있다. 각 픽스처에 대해 자체 체크를 실행하고, 양 방향 모두에서 기대 결과를 단언한다. 즉, 잘못된 픽스처에서는 반드시 발견이 나와야 하고, 정상 픽스처에서는 아무것도 나오지 않아야 한다. 몇 개의 체크를 실행했는지 출력하고, 단언이 하나라도 실패하면 0이 아닌 값으로 종료한다. 이 규약은 저장소의 교훈 기록 파일에 한 문장으로 적혀 있다. 한 방향으로만 하는 테스트는 테스트가 아닌 것과 같다.
2026-09-09 저녁, 러너의 출력에서 읽은 카운트: 테넌트-퍼미션 게이트는 2개의 체크가 실패 가능함을 증명했고, evidence-graph 게이트는 4개, 제출 게이트는 10개, provenance 게이트는 9개, CI-예산 디텍터는 4개, 응답 시계는 11개, AI 리뷰어는 5개, 골든 케이스 라이브러리 5개, 루프 감사 5개다. 아홉 개의 모든 게이트가 이제 매번 CI를 돌릴 때마다 스스로 실패(레드)하는 모습을 보여줬다.
2. 러너도 하나의 게이트다
게이트가 셀프 테스트를 갖고 있지만 아무도 실행하지 않으면, 그건 또다시 문장에 불과하다. 그래서 러너는 게이트 목록을 데이터로 들고, 각 게이트의 셀프 테스트를 실행한다. 목록에 없는 게이트, 플래그가 없는 게이트, 단언에 실패한 게이트가 있으면 전체를 실패(레드)로 종료한다. 러너는 로컬 게이트 명령과 CI에 모두 포함되어 있으며, 저장소의 리뷰 규칙 중 하나를 기계적으로 구현한 것이다. 즉, 모든 게이트는 반드시 실패할 수 있음을 증명해야 한다는 규칙이다. 러너는 목록에 한 번도 올라간 적 없는 게이트는 감지하지 못한다. 목록의 완전성은 루프 감사의 구조적 기준(아홉 개 게이트의 이름)과 리뷰 규칙에 의해 보장된다. 루프 감사 자체도 셀프 테스트와 함께 작성되어 같은 PR에서 목록에 추가되었다.
3. 잘못된 대상을 감지한 디텍터
1821년 규칙의 다른 절반이 2026-09-09의 인벤토리에서 드러났다. 저장소에는 Actions 실행 이력을 감시하는 디텍터가 있는데, 쿼터 소진의 지문을 찾는다. 이 계획에서 쿼터 소진은 0단계 잡으로 나타난다. 최근 60회 실행을 돌려보니, 한 번 오탐이 있었다. 2026-09-05 main 브랜치로의 푸시에서 마이그레이션 잡이 0단계였는데, 이는 9초 뒤 다음 푸시가 들어오면서 동시성 규칙에 따라 대체됐기 때문이다. 디텍터의 지문이 취소와 일치했다. 해결책은 임계값 조정이 아니었다. 잡에는 자체 결론이 있고, 취소된 잡은 그 사실을 명시한다. 이제 디텍터는 결론 필드를 읽어, 취소·스킵·중립 잡을 지문에서 제외한다. 셀프 테스트에는 반드시 실패(발화)하지 않아야 하는 취소된 0단계 잡 픽스처가 포함된다. 오탐이 있는 디텍터는 가끔 들어가는 no-go 플러그와 같고, 한 번이라도 그런 모습을 본 팀은 더 이상 신뢰하지 않는다. 교훈 기록 파일에는 이전 쿼터 소진이 실제로 감지되지 않았던 사실이 남아 있다.
4. 리플레이 PR
AI 리뷰어도 다른 게이트처럼 셀프 테스트를 갖고 있지만, 이 셀프 테스트는 모델이 필요 없는 부분만 다룬다. 즉, evidence 필터, tier 분류기, brief 렌더러 등이다. 모델 자체의 판단은 실제 사례로만 테스트할 수 있다. 그래서 전편 기사에서 저장소 이력에 있던, 이미 고쳐진 결함(클로저 게이트를 통과하지 않고 컴플레인이 닫히던 우회로)을 다시 도입하는 PR을 열고, "do not merge"로 표시했다. 해당 결함에 대한 리뷰어의 규칙은 존재하며, 이 PR이 그에 대한 no-go 플러그다. 2026-09-06부터 열려 있던 리플레이 PR에는 401에서 미측정된 brief 하나가 달려 있다. 저장소의 11개 brief 모두 같은 이유로, 인증키가 매번 거부되기 때문이다. 이 PR은 의도적으로 계속 열려 있고, 응답 시계에서 서면 사유로 면제되어 있다. 리뷰어가 한 번이라도 실패(레드)를 기록할 때까지 닫지 않는다. 어떤 결과가 나왔는지 밝히겠다고 약속했던 기사는 이렇게 말한다: 아직 둘 다 아니다.
같은 날 저녁, 업데이트. 약 20:00 UTC에 유효한 인증키가 저장소에 도달했고, 리뷰어가 리플레이 PR에서 다시 실행됐다. 결과는 실패(레드)였다. 네 개의 블록 단위 발견이 각각 파일과 라인과 함께 기록되었고, 우회로, 제거된 화이트리스트, 누락된 클로즈 감사, 삭제된 테스트를 지적했다. 그리고 승인 대신 사람의 확인을 요청했다. no-go 플러그는 들어가지 않았다. 루프 감사의 "AI has measured a PR" 행은 다음 실행에서 성공(그린)으로 바뀌고, "Tier-1 has merged once"는 여전히 계획을 기다린다.
다섯 번의 왜: 게이트는 반드시 실패(레드)를 경험한 뒤에만 설치된다
| # | 왜? | 왜냐하면 | 증거 |
|---|---|---|---|
| 1 | 한 번도 실패(발화)하지 않은 게이트의 그린은 왜 무가치한가? | 실패할 수 없는 게이트가 내놓는 그린은, 아무것도 발견하지 못한 게이트의 그린과 완전히 똑같기 때문이다. 출력에서 둘을 구분할 방법이 없다. | 한 저장소의 세 가지 보호장치는 한 번도 실패(발화)한 적이 없었다. 각각은 점검 전까지는 정상 작동한다고 믿었다. |
| 2 | 왜 증거는 게이트와 함께 실려야 하고, 한 번만 하면 안 되는가? | 게이트는 변한다. 설치 시점에 한 번 증명한 것은 다섯 번째 수정 이후의 게이트에 대해 아무 말도 해주지 못한다. 그리고 게이트를 망가뜨리는 수정은 스스로를 알리지 않는다. | 러너는 매번 CI에서 모든 셀프 테스트를 실행한다. 루프 감사는 셀프 테스트와 목록 내 위치를 같은 PR에서 함께 실었다. |
| 3 | 왜 두 플러그(Go/No-Go) 모두여야 하고, No-Go만으로는 안 되는가? | 모든 입력에 실패(발화)하는 게이트는 아무것도 실패하지 않는 게이트만큼이나 빨리 무시된다. Go 플러그가 있어야 레드가 의미를 갖는다. | Google: 패스에서 실패로 전환된 사례의 84%가 플레이키 테스트였다[4]; 예산 감시자의 취소된 작업에서 발생한 오탐지 |
| 4 | 왜 러너 자체가 하나의 게이트여야 하는가? | 아무도 실행하지 않는 셀프 테스트는 그저 파일 속의 문장일 뿐이다. 3화의 규칙은 '규칙이란 diff할 수 있는 것'이라 했고, 2화의 규칙은 '병합 결정이 바라보지 않는 곳에서 실행되는 체크는 체크가 아니다'라고 했다. | 러너는 로컬 게이트 명령과 CI 모두에 들어 있다. 목록에 있는 게이트가 없거나, 플래그가 없거나, 실패하면 전체를 실패(레드)로 종료한다. |
| 5 | 왜 리플레이 PR을 계속 열어두고, 아직 측정되지 않은 상태로 남겨야 하는가? | 모델의 판단만은 인위적으로 픽스처링할 수 없는 유일한 게이트다. 이 경우 정직한 상태는 '알려진 결함에서 실제로 실패(레드)를 낸 적이 있다'와 '아직 아니다' 둘뿐이다. PR을 닫아버리면 '아직 아니다'가 곧 침묵이 되어버린다. | 리플레이 PR의 브리프 하나, 401로 미측정 상태; 응답 시계에서 서면 사유로 면제됨 |
한 문장으로 요약하면,게이트의 그린(통과)은, 같은 게이트가 마지막으로 바뀐 뒤에 알려진 불량 입력에서 실제로 레드(실패)를 낸 적이 있을 때만 증거가 되며, 그 확인 과정이 게이트의 일부여야 한다.
30분 만에 구축하기: 셀프 테스트 컨트랙트
30분은 이 컨트랙트를 복사해 적용하는 독자를 위한 예산일 뿐, 내가 실제로 측정한 시간은 아니다.
| 항목 | 명세 |
|---|---|
| 셀프 테스트 플래그 | 모든 게이트는 --selftest를 허용한다. 픽스처는 메모리에서 만들고, 저장소에는 아무것도 건드리지 않는다. 양방향 단언: known-bad ⇒ finding, known-good ⇒ no finding. |
| 출력 | 한 줄: 몇 개의 체크가 모두 실제로 발동 가능함이 증명되었는지. 어떤 단언이라도 실패하면 0이 아닌 값으로 종료. |
| 러너 | 게이트 경로 목록을 데이터로 가진다. 각 항목에 대해: 셀프 테스트 실행; 파일 없음, 플래그 없음, 0이 아닌 종료값이면 ⇒ 레드(실패). 러너는 로컬 게이트 타깃과 CI에 있다. |
| 감지기 지문 | 플랫폼의 자체 결론 필드를 먼저 읽고, 그 후에 형태를 매칭한다. 취소, 건너뜀, 중립 상태는 제외한다. 이 오탐지 사례를 셀프 테스트의 '발동하지 않아야 하는' 픽스처로 추가한다. |
| 리플레이 PR | 실제 고쳐진 결함을 다시 도입하는 PR 하나를 만들고, do-not-merge로 표시하며, 응답 시계에서 서면 사유로 면제하고, 리뷰어가 실제로 레드(실패)를 낸 후에만 닫는다. |
| 불변 원칙 | 모든 게이트는, 모든 실행마다: known-bad이면 반드시 finding이 나오고, known-good이면 finding이 없어야 한다. |
| 중단 규칙 | 목록에 있는 게이트 중 쌍(통과/실패 테스트)이 없거나, 둘 중 하나라도 실패하면 전체 CI가 실패(레드) 처리되고, 이후에는 아무 것도 머지되지 않는다. |
| 리포팅 | 루프 감사의 구조 기준은 셀프 테스트가 있는 게이트의 수를 세고, 기능 기준은 러너가 실제로 실행되는지 확인한다. 이 둘 모두가 매번 CI 실행마다 확인된다. |
| 의도적 생략 | 게이트에 대해 flaky 테스트가 발생할 때 재시도하지 않는다. 픽스처 라이브러리를 공유하지 않는다. 인메모리 픽스처 외에는 플랫폼을 모킹하지 않는다. 이 중 어느 하나라도 셀프 테스트가 게이트 자체가 아닌 다른 대상을 검증하는 구실이 될 수 있기 때문이다. |
# The contract is two assertions per rule, inside the gate itself.
def selftest():
    bad  = fixture_with(agent_marker=True, trace_trailer=False)   # must fire
    good = fixture_with(agent_marker=True, trace_trailer=True)    # must not
    assert check(bad),      "the gate never fires: not installed"
    assert not check(good), "the gate fires on a good input: will be ignored"
    print("selftest: 2 checks, all proven able to fire")

# The runner refuses a gate without one.
GATES = ["scripts/check_tenant_perm.py", "scripts/check_provenance.py", ...]   # data
for g in GATES:
    rc = run([python, g, "--selftest"])
    if rc != 0: fail(f"{g}: no self-test, or it failed")
같은 원리, 다섯 가지 관점
| 독자 | 단 하나의 판단 | 단 하나의 실천 |
|---|---|---|
| 학생 | 실패하는 모습을 한 번도 본 적 없는 체크는, 사실상 체크가 아니다. | "항상 통과"만 하는 무언가에 반드시 실패해야 하는 케이스를 넣어보라. 어떤 일이 벌어지는지 직접 확인하라. |
| 엔지니어 | 모든 실행마다, 각 게이트에 통과/실패 테스트(두 개의 플러그)를 내장하라. | 오늘 가장 신뢰하는 게이트에 --selftest 를 추가하라. 하나의 known-bad, 하나의 known-good 픽스처를 반드시 포함해서. |
| 창업자 | 실제로 실패(레드)한 적이 있는 게이트가 몇 개인지 세어보라. | 이번 주에 그 숫자를 물어보라. 0이라면, README의 배지는 장식에 불과하다. |
| 임원 | 1821년 두 개 한 쌍의 플러그가 요구된 데에는 다 이유가 있다. | 당신이 가진 통제 수단 중 실제로 네거티브 테스트가 문서화된 것은 무엇이고, 단지 작동한다고 믿고 있는 것은 무엇인지 물어보라. |
| 투자자 | 리플레이 PR을 열어두고 아직 측정되지 않은 상태로 유지하는 팀은, 결과를 정직하게 보고하는 팀이다. | 팀의 자체 CI 기록에서, 게이트가 일부러 실패(레드)하는 장면을 직접 보여달라고 요청하라. |
패턴, 안티패턴, 그리고 첫 번째 원칙
유효했던 패턴. 게이트 내부에서 메모리 내 픽스처를 양방향(성공/실패)으로 사용한다. 게이트 목록이 데이터로 관리되고, 그 목록을 순회하며 스스로도 하나의 게이트 역할을 하는 러너. 형태를 매칭하기 전에 결론부터 읽는다. 거짓 양성 사례는 픽스처로 전환해 테스트에 포함한다. 모델이 실제로 실패(레드)할 때까지 리플레이 PR을 열어두고 예외로 처리한다.
이 방식이 대체한 안티패턴. 설치되지 않았을 때 조용히 건너뛰는 린터. 문서상 존재한다고 되어 있으나 실제로 연결된 적 없는 봇. 취소된 작업과 지문이 일치해 오탐을 내는 디텍터. 한 번도 실패(레드)한 적 없는 여섯 개의 게이트가 제대로 작동한다고 믿었던 것.
정의된 메커니즘. 셀프 테스트는 '게이트가 작동한다'는 과거의 신념을, 매 실행마다 실제로 측정하는 것으로 바꾼다. 러너는 '모든 게이트가 셀프 테스트를 가진다'는 관습을, 실제로 실패(레드) 신호를 내는 규칙으로 전환한다.
첫 번째 원칙, 한 문장으로. 게이트를 신뢰하는 정도는, 최근에 그 게이트가 일부러 실패하는 모습을 직접 본 시점에 비례한다.
한 표로 보는 시즌, 그리고 스코어보드
ANDON은 다섯 가지 규칙, 하나의 저장소, 그리고 네 개의 시간축 기록을 상대로 하루 동안 구축한 결과다. 여기 다섯 가지 규칙을 각 알파벳, 에피소드의 명제, 그리고 저장소 내에서 그 규칙을 구현한 실체와 함께 정리했다. 이제 시리즈 전체를 기억이 아니라 코드로 검증할 수 있다.
| 알파벳 | 규칙 | 명제 | 저장소 내 구현 |
|---|---|---|---|
| A | 숫자로 평가하라 | 홍수는 체감이 아니라 측정된다; 기계 게이트는 셰프가 아니라 저울이다 | 도시의 실시간 측정값; 스크립트가 결정할 수 있는 것만 결정하는 기계 게이트들 |
| N | 침묵하지 않는다 | 실행할 수 없는 게이트는 '미측정'을 게시한다; 응답 시계는 크론으로 동작한다 | 리뷰어의 세 번째 상태, SLA 봇, 루프 감사의 P-기준 |
| D | 문장이 아니라 데이터 | 규칙은 diff로 검증할 수 있어야 한다. 문서는 그 규칙에서 렌더링되고, 실제로 검증된다. | 세 개의 JSON 파일, 렌더러, 수작업으로 실패(레드)를 증명한 드리프트 체크 |
| O | 오직 엔벨로프 내부에서 | 봇이 머지할 수 있는 경로 목록이 곧 경계다. 거부가 우선하며, 다섯 조건이 동시에 적용된다. | 자동 머지 엔벨로프, 티어 분류기, 출처 및 크기 게이트 |
| N | 네거티브 테스트 | 게이트는 반드시 한 번이라도 의도적으로 실패(레드)를 경험한 뒤에만 설치된다. 그리고 그 증거가 함께 제공된다. | 모든 게이트의 셀프 테스트, 실행을 강제하는 러너, 리플레이 PR |
| 시즌 스코어보드 | 첫 번째 아침, 2026-09-09 | 마지막 저녁, 2026-09-09 |
|---|---|---|
| 첫 응답이 없는 가장 오래된 오픈 PR | 57시간, PR 세 개 | 동일한 세 개; 라벨이 붙어 보드에 남아 있고, 여전히 미응답 |
| 실패(레드)를 증명하는 셀프 테스트가 있는 게이트 | 6개 중 0개 | 9개 중 9개, 자체적으로 게이트 역할을 하는 러너가 강제 |
| 9월 1일 이후 트레이스 트레일러가 포함된 에이전트 보조 커밋 | 측정되지 않음 | 21개 중 11개; 신규 커밋에는 출처 게이트가 요구함 |
| 루프 감사 기준 미측정 | 감사 자체가 존재하지 않았음 | 2 of 23: AI가 PR을 측정하지 않았고, Tier-1도 아직 머지된 적이 없다 |
| AI 브리프 게시 / 침묵 | 3 / 0 | 11 / 0, 모두 거부된 인증키에서 미측정 |
이 중 세 행은 이번 시즌의 정직한 실패다. 첫 번째 행이 바로 시즌의 이름이 된 이유였으나, 실제로는 변화가 없었다. 공동 창업자 세 명의 PR은 시즌 내내 인간의 응답 없이 남았다. 기계는 하루 만에 라벨을 붙였지만, 관리자는 끝내 답하지 않았다. 이는 단순한 설정 문제가 아니라, 사람의 행동이다. 나머지 두 행은 같은 실패가 서로 다른 방향에서 드러난 것이다. 하나는 거부된 인증키, 다른 하나는 아직 저장소에 도달하지 않은 계획이다. 시리즈가 만든 모든 자동화는 이 둘 없이도 분류, 게시, 라벨링, 감사, 거부를 정확히 수행한다. 하지만 이 둘이 충족되기 전까지, 시리즈의 어떤 기능도 PR을 측정했다거나 머지했다고 주장하지 않는다. 이것이 첫 번째 규칙이었고, 마지막 규칙이기도 하다.
현실 미션
에피소드 4는 에피소드 5에 이르면 모든 게이트가 자체 셀프 테스트로 실패(레드)를 낼 수 있음이 증명될 것이라 약속했고, 리플레이 PR은 리뷰어가 실제로 결함을 잡아내거나, 여전히 인증키를 기다릴 것이라 했으며, 본문에서 어느 쪽인지 밝히겠다고 했다. 첫 번째는 완수됐다: 9개 중 9개, 모든 CI 실행마다 그렇다. 두 번째는 기사 마감 시점까지도 두 번째 경우였다. 저장소 내 다른 10개와 마찬가지로 리플레이 PR에는 미측정 브리프가 하나 있었고, 저녁이 되어 인증키가 도착하자 리뷰어가 해당 PR에서 실패(레드) 신호를 냈다(위에 기록됨). 시즌의 미션은 더 이상 다음 에피소드로 넘길 수 없으니, 스코어보드의 세 행이 곧 미션이다. 첫 번째 행은 기계가 아닌 사람의 몫이다: 공동 창업자 세 명의 PR에 답하면, 보드에서 라벨이 사라질 것이다. 인증키가 교체되면, 리플레이 PR의 다음 브리프가 측정될 것이다. 리뷰어가 알려진 결함에서 실패(레드)로 반응하거나, 시리즈의 핵심 주장 자체가 틀렸음이 드러날 것이고, 도시는 그 결과를 기록할 것이다. 계획이 저장소에 도달하면, 한 번의 명령으로 브랜치 보호가 설치되고, 다음 문서 전용 PR은 자동으로 머지되거나, 감사가 그 이유를 밝힐 것이다.
다음 읽을 거리
에피소드 5의 ANDON · 에이전트형 PR 리뷰 및 CI/CD, 마지막 편. 모든 수치는 해당 위치에서 범위가 정해진다. 주방은 모델일 뿐, 실제 측정값이 아니다. 셀프 테스트, 러너, 디텍터, 리플레이 PR은 모두 비공개 저장소에 존재한다. 그 구조는 컨트랙트에 재현되어 있으므로 접근 권한에 의존하지 않는다. 시즌이 인용한 4-지평선 도시는 포트폴리오의 plans 디렉터리에 기록되어 있다.
참고문헌
- Raber, Malone, Gordon, Cooper, Conservative Innovators and Military Small Arms: Springfield Armory 1794–1968, NPS 1989/2006, p. 138 (Stubblefield and Lee to Bomford, 1821-12-04, NARA RG 156/21). npshistory.com
- Roser, 230 Years of Interchangeable Parts, AllAboutLean, 2015-07-08. allaboutlean.com
- Science Museum Group, Set of Johansson gauge blocks, c. 1900, object co59398. collection.sciencemuseumgroup.org.uk
- Micco, The State of Continuous Integration Testing at Google, ICST 2017 기조연설. aster.or.jp
- Micco, Flaky Tests at Google and How We Mitigate Them, 2016-05-27. testing.googleblog.com
- Luo, Hariri, Eloussi, Marinov, An Empirical Analysis of Flaky Tests, FSE 2014. mir.cs.illinois.edu
- Listfield, Where do our flaky tests come from?, 2017-04-17. testing.googleblog.com
- Software Engineering at Google, 23장, Continuous Integration, 2020. abseil.io
- Chromium, Commit Queue 문서. chromium.googlesource.com
- Flight Safety Australia, 한 번에 하나씩: 체크리스트의 짧은 역사, 2018-11-12. flightsafetyaustralia.com