AI-Nativeシリーズ · ANDON · エージェント型PRレビュー/CI/CD · 第2話(全5話)
リポジトリ自働化:沈黙しないPRゲート
エージェント型PRレビュー/CI/CDの第2話。1896年、織機は糸が切れたとき自ら停止する術を得た。だが多くのCIパイプラインはいまだにその教訓を学んでいない。実行できなかったゲートは、何も見つけなかったゲートと見分けがつかず、どちらも緑になる。このエピソードはANDONのNにあたる。2状態ではなく3状態を持つゲート、応答クロックはGitHubのcronで動き、誰かの記憶には頼らない。そして設計が拾いきれなかった唯一の失敗――声なきままのそれ――を記録する。
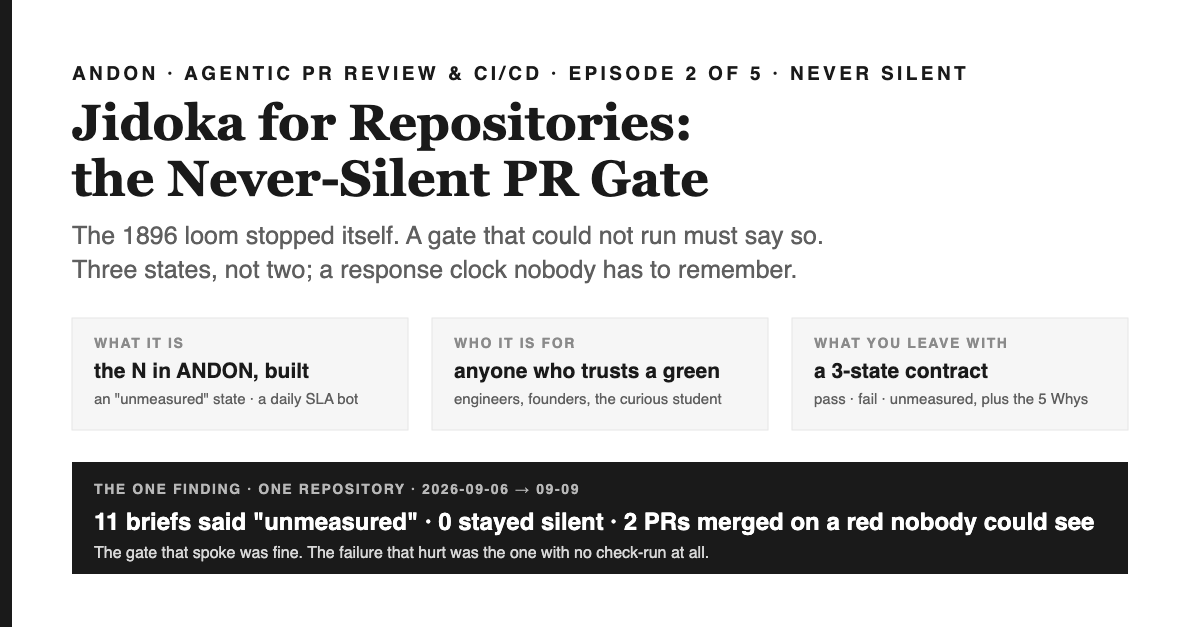
1分でつかむ要点――このエピソードで得られるもの
本稿の内容ANDONANDON全5話のエージェント型PRレビュー/CI/CDシリーズ第2話。今回のテーマは「沈黙しない」。実際のリポジトリに「沈黙しないPRゲート」として実装されている。3状態(pass, fail, unmeasured)を持つAIレビュアー、PRにラベルを付けてダッシュボードを毎日自動で上書きする応答クロック、そして状態がまったく出なかった失敗を正直に報告する。沈黙しない。これは実際のリポジトリに実装された沈黙しないPRゲートだ。AIレビュアーが「合格」「不合格」「未計測」の三つの状態を持ち、プルリクエストにラベルを付与し、ダッシュボードを毎日自動で上書きする応答クロック、そして「状態すら記録されなかった失敗」を正直に報告する仕組みで構成されている。
なぜ意味があるのか エンジニアにとって:2状態ゲートは「実行不能」を「何も見つからなかった」と同じ扱いにし、黙殺が日常になる。ファウンダーにとって:企業データではヒューマンレビューのカバレッジが89%から68%に落ち、スループットは2倍になった。つまり、失われるシグナルこそ沈黙するゲートが隠すものだ。学生にとって:これは品質管理の最古の原則――「自分で止まる機械」――を最新の課題に応用したものだ。
読後にできること すべての自動判定に「三つの状態」と、それぞれの状態を必ず投稿する出力を持たせる。GitHubのcronで応答クロックを動かし、ポリシーファイルと「常に上書きされる」ダッシュボードを用意する。そして本エピソードで得たマージルール――「ワークフローランの結論でマージし、チェックリストでは絶対にマージしない」――を採用する。なぜなら、チェックランのない失敗はリスト上では見えないからだ。
ANDON — シリーズの背骨
- A · Assess ― PR洪水は「感じる」ものではなく「測る」もの 第1話
- N · Never silent ― リポジトリの自働化 この回
- D・Data, not prose(散文ではなくデータ) — ドリフトしないルール 第3話
- O・エンベロープの内側だけ――被害範囲はパスリストで決まる 第4話
- N · Negative test ― ゲートは意図的に赤になって初めて設置される 第5話
本エピソードの内容と、「沈黙しないPRゲート」がなぜ2番目に来るのか
第1回では「洪水」を測定した。2023年1月から2026年半ばにかけて、GitHub上のマージ済みプルリクエストは3倍以上に増え、自己計測したある企業では一人あたりのスループットがベースラインの2.09倍に達し、ヒューマンレビュー付きPRの割合は89%から68%に低下した[1, 2]。その結論は「機械ゲート」――意見を持たず、スクリプトで決められることだけを判断する秤――だった。本エピソードは、その秤が「測れない」ときにどうするか、を扱う。
こうした事態は珍しくない。AIレビューアには認証情報が必要だが、その認証情報は期限切れになったり、貼り付けミスやローテーションで使えなくなることがある。プルリクエスト本文を読むゲートは、プッシュイベントでは本文が存在しないため入力を得られない。ワークフローファイルがパースエラーを起こすこともあれば、ダッシュボードを書き込むボットがダッシュボード機能自体が無効化されているのに気づくこともある。こうした場合、2状態(合格・不合格)のゲートは「何も実行されず、何も失敗しなかった」時に自動的に合格を出す。PRの画面には緑色が表示される。だが文献によれば、PRの読者は今やほぼ唯一の人間であり、2026年の調査ではAI生成PRの大半が人間によるレビューを受けておらず、レビューが行われてもほとんどがボットによるものだった[3]。さらに、11,048件のエージェント型PRを手作業で調べたところ、5.5%には一切の可視的なやり取りの痕跡がなかった[4].
だからこそ、このエピソードのルールは明快だ。ゲートには3つの状態があり、3つ目は必ず「声」を上げる。実例として使うのはエピソード1と同じプライベートな品質管理リポジトリで、AIレビューアの最初の11回の実行はすべて3つ目の状態となり、応答クロックが初稼働し、同じ日に「いかなる状態も出さない失敗」のまま2件のPRがマージされた。最後の「なぜを5回問う」では、なぜ3つ目の状態は「不在」ではなく投稿コメントでなければならないのかを掘り下げる。その答えは1896年の織機に遡る。
このルールの原点:自ら止まる機械
トヨタが自社の生産方式を語るとき、必ず織機から始まる。豊田佐吉が1896年に開発した動力織機には、同社の説明によれば"a new weft-breakage automatic stopping device (developed in 1896)"(訳:「1896年に開発された新しい緯糸切れ自動停止装置」)が搭載されていた。緯糸が切れると、織機は欠陥を織り込まずに自動で停止した[5]。G型自動織機は緯糸だけでなく経糸が切れた場合も止まり、最初の1台は1925年11月に生産ラインから出荷された[6, 7]。大野耐一によるこの原理(自働化)の説明は、"automation with a human touch."(訳:「人間味のある自動化」) [8である。織機の本質は、糸切れを検知したこと自体ではなく、「検知」と「停止」が同時に起こることであり、機械が人間の知らぬまま壊れた状態で動き続けることがなかった点にある。
この系譜でさらに重要なのが2つある。1924年5月16日、Walter ShewhartはWestern Electricの上司に管理図を提案するメモを送った[9]。これは偶然変動と、彼が「特定原因」と呼んだものを分離する道具であり、1931年の著書ではその仮説をこう明言している:"Assignable causes of variation may be found and eliminated."(訳:「変動の特定原因は発見され、排除されうる」) [10。シグナルを出さない原因は発見できず、したがって排除もできない。そしてトヨタのアンドン(生産ラインの誰もが引いて生産を止められる紐)の運用は、同社の説明によれば1950年に始まっている。その説明は、"a team member on the production line can pull the cord to flag up the issue, stop the process and receive immediate assistance."(訳:「生産ラインの作業員は紐を引くことで問題を知らせ、工程を停止し、即座に支援を受けられる」) [11というものだ。停止は権利であり義務であって、非難ではない。
エピソード1で使ったキッチンの比喩をもう一度持ち出そう。秤は合格・不合格を判定するだけだが、本エピソードが加えるのは「バネが切れたら自動で止まるミキサー」と、「秤が壊れている」と声に出して伝える料理人である。どちらも料理の出来を評価しているわけではない。どちらも「未知の状態では進めない」というキッチンの意思表示だ。
| キッチン | リポジトリ |
|---|---|
| バネが切れたら自動で止まるミキサー | レビューアの第3の状態:「unmeasured(未測定)」を理由付きでPRに投稿 |
| 自動で鳴るチケットタイマー | 応答クロック:GitHubのcronで動き、最初の応答まで48時間、意思決定まで7日 |
| 印刷されなかった伝票──誰も調理せず、誰もその存在に気づかない。 | パースエラーを起こしたワークフロー──チェックランが生成されず、チェックリストにも何も現れない。 |
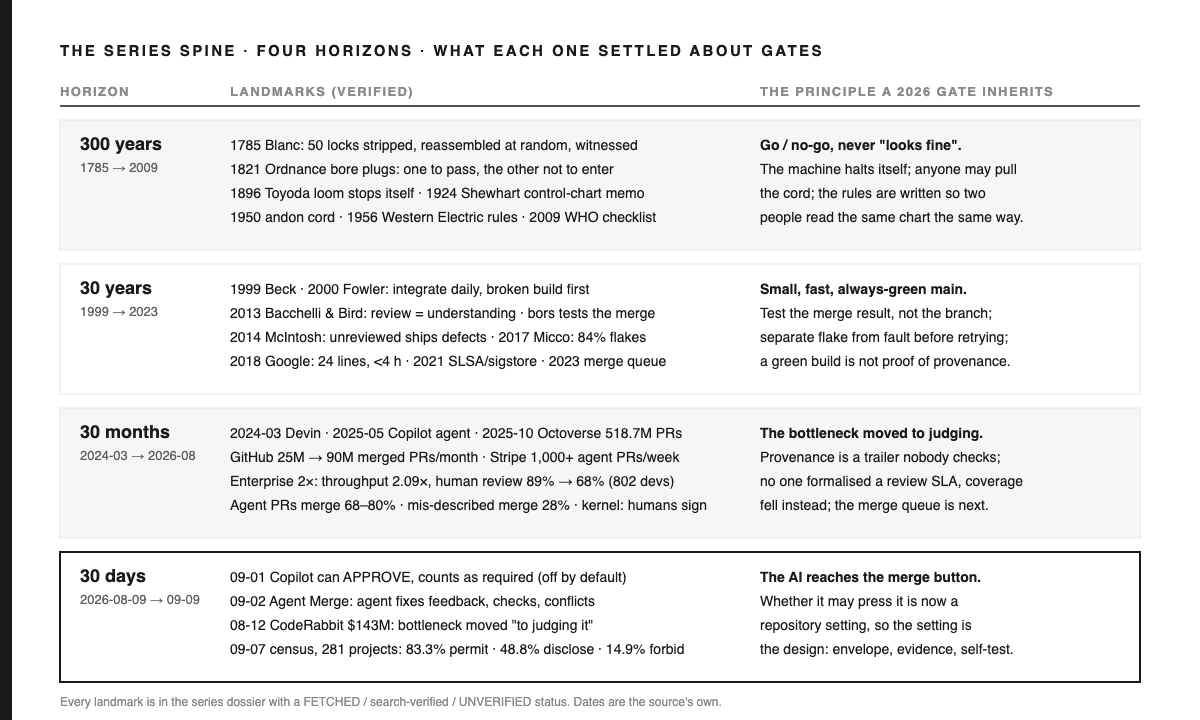
沈黙が示す数字──エージェントの洪水の中で、人間の目が届く範囲の狭さ
2026年に第三の状態がより重要になるのは、2016年と比べて人間による最後の砦が薄れているからだ。2013年の調査によれば、現代的なコードレビューの標準的な運用は"performed regularly and quickly just before the code is committed"(訳:コードがコミットされる直前に、定期的かつ迅速に実施される)──通常2人のレビュワーが担当し、中央値の完了時間は約15〜21時間だった[12]。Googleのエンジニアリングガイドは、次の一文で基準を定めている:"One business day is the maximum time it should take to respond to a code review request"(訳:コードレビューリクエストへの対応は、最大でも1営業日以内でなければならない) [13]。また、2018年に約900万件のレビュー済み変更を分析した調査では、完全なレビューの中央値遅延は4時間未満だった[14].
]。この水準と比べると、エージェント時代の数字は速度ではなくカバレッジの崩壊を示している。企業内の調査では、AIレビューのカバレッジがPR全体の約19%から84%に増加する一方、人間によるカバレッジは89%から68%へと減少した[2]。GitHub上のエージェント型PRの大半は、人間によるレビューを一切受けていない[3]。717件のPRを手作業で調べたところ、却下の3分の1には根拠が見当たらず、5.5%にはやりとりの痕跡すらなかった[4]。ベンダー側のデフォルトも同じ傾向を示す。Anthropicのマネージドコードレビューはブロックせず中立チェックを投稿し、1回あたり平均15〜25ドルかかる[15]。CursorのBugbotは、未解決の問題で失敗扱いにする設定にしない限り、中立ステータスを返す[16]。中立チェックは、丁寧な沈黙の一形態だ──存在はするが、何も判断しない。
このドシエにあるどの調査でも、エージェントの増加に対して正式なレビューSLAで対応した組織は見つからなかった。30か月の記録が示すのは、カバレッジの低下だけである。そのギャップこそが、このエピソード後半で立ち向かう対象だ。
実装編──三つの状態と、GitHubのcronで動く応答クロック
1. AIレビュワーの「第三の状態」
前回記事とエピソード1のレビュワーは、diffを読み、機械ゲートを通し、モデルに構造化された指摘を求め、file:line引用のない指摘は捨て、PRごとに1件のコメントを投稿する。沈黙しない設計への変更は、コード上は小さくても意味は大きい──コメントを投稿せずに終わる経路が存在しない。認証情報がなければ、プラットフォームが認証エラーを返せば、モデルが拒否すれば、構造化出力のパースに失敗すれば、ブリーフは「unmeasured」という見出しで理由を明記し、「これは『問題なし』ではない」という一文、機械ゲートの結果、そして人間専用の問いは人間が必要である旨の注記を並べる。ワークフローはそれでも投稿する。各フレーズはユニットテストで固定され、リファクタでこっそり二値版に戻ることはない。
実際の記録が証拠だ。2026-09-09のPRコメントから読み取れる(最初の2回の実行は[17]で説明)。2026-09-06から09-09まで、このワークフローはリポジトリ内のすべてのPR(導入PR以降、計11件)で実行され、すべてにブリーフを投稿した。11件すべてが「unmeasured」だった。最初はリポジトリに鍵がなかったため、次は与えられた鍵が401で拒否されたためである。沈黙したものは一つもなかった。この実行の最後に構築したループ監査は、これら2つの事実をGitHub APIから直接読み取り、「すべてのPRにブリーフがある」「unmeasuredは投稿されており、沈黙はない」という基準を両方パスと判定する。一方で「AIが実際にPRを測定したか」という基準は、有効な認証情報が存在するまでunmeasuredのままである。監査はこれを切り上げて合格にしてはならず、下記の三つ目のインシデントは一度だけそれが起きたときの話だ。
2. 応答クロック
リポジトリ自身の提案は2026年9月2日時点で問題を定量化していた。すべてのマージ済みPRは自己作成で、レビューはゼロ。最も古い未対応PRは398時間放置されていた。人間の記憶に頼る運用では、同じ事態が繰り返されるだけだ。提案は1週間実装されないままだった。9月7日、ドメインの共同創業者が3件のプルリクエストを作成し、9日朝までにメンテナからの応答が57時間なかった。これはまさに提案が防ごうとした事態だった。その朝、応答クロックのボットが作られた。
このボットは純粋関数とcronで構成されている。関数はプルリクエスト、現在時刻、ポリシーファイルを受け取り、ok・needs-first-response・overdue-decision・exempt・draftの5つの状態のいずれかを返す。メンテナの活動とは、ポリシーのmaintainerリストに載った名前によるコメント・レビュー・マージ・クローズ。ただしユニットテストから導かれた3つの除外がある:著者自身のコメントは、著者がメンテナでもカウントしない/AIレビュアーのコメントはカウントしない(機械の「unmeasured」は人間の「見た」とは違う)/ダッシュボード自身のコメントもカウントしない。メンテナ応答なし48時間がハード閾値、決定なし7日がソフト閾値。2件のPRは番号指定で免除、理由はポリシーに明記されている:ゲート導入前のレガシーPRと、前回記事の意図的なネガティブテストPRだ。
cronはGitHubのインフラ上で毎日動く。毎回、2つのラベルを付与・除去し、タイトルで見つけた1つのダッシュボードissueを上書きする。つまりボードは増え続けるアラートスレッドではなく、常に上書きされる単一の面となる。最初の本番実行は、提案が要求した逆バリデーションとして手動で走らせ、3件の共同創業者PRにラベルを付け、2件の免除PRはそのままにした。その後、リポジトリでissueが無効化されていたためダッシュボードが作れず、非ゼロ終了した。これは正しい挙動だ。契約はラベルとボードの2つの出力を持ち、片方しか出せなければ「成功」ではなく「失敗」として不足分を報告する。リポジトリ設定を変更し、ボットを再実行すると、3件の違反行と2件の免除行を持つボードが現れた。以後この失敗が再発した場合、ボットはその理由を平易な言葉で明示する。
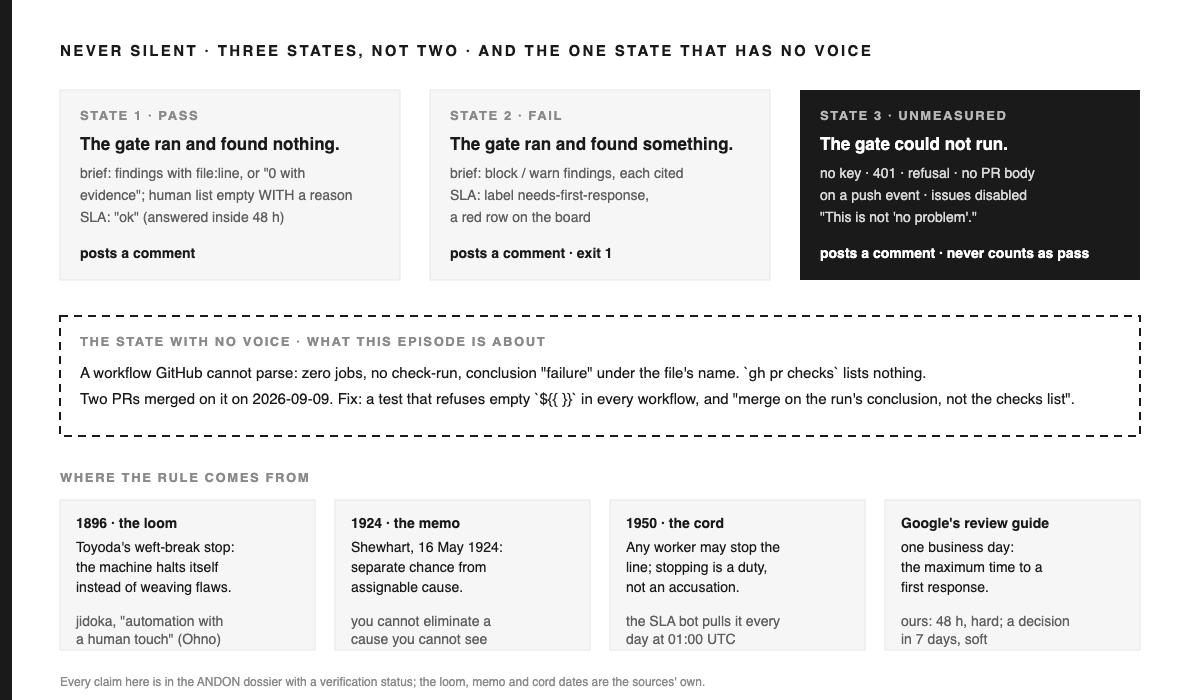
声なき状態──見えない赤でのマージ
設計が拾いきれなかった失敗を、発生したまま記録する。その朝マージされたプルリクエストは、CIワークフローファイルにコメントを追加した。そのコメントには、シェルへの式展開を防ぐ意図で、空の式波括弧ペアがそのまま書かれていた。GitHubはワークフローファイル内のすべて(コメントも含む)で式を評価し、空の式はパースエラーとなる。そのコミット以降、ワークフローは実行不能になった。
外から見える姿こそが本質だ。パースに失敗したワークフローは、ジョブゼロ・結論は失敗・名前はワークフロー名ではなくファイルパスとなる。チェックランは生成されない。プルリクエストのチェック一覧を表示するコマンド(自分がマージ判断に使っていたもの)は、そのワークフローについては何も表示しなかった。他のワークフローの結果だけを見せて終わる。その状態で私はそのプルリクエストをマージし、続けてもう1件、行のない赤でマージした。
ループ監査は同日中にこれを検知した。なぜならCIの実用的な判定基準はチェックリストではなくmainブランチの最新実行の結論を読むからであり、その実行はファイル名付きで失敗を示していた。修正はコメントの変更、ワークフローファイル内に空式があれば失敗するユニットテスト、リポジトリ自身の記録への教訓追加、そして自分用の新しいマージルールだった:プルリクエストはチェックリストではなくワークフロー実行の結論で判断せよ。なぜなら本当に痛い状態はリストに現れないからだ。
同じ午後、監査は逆方向の同系統の失敗も捉えた。新しいプロベナンスゲートは、エージェント作成PRに検証出力をPR本文へ貼り付けることを要求する。マージ後のpushイベントではPR本文が存在しないため、CIステップは空ファイルを書き、ゲートはその空を「セクションがない」と解釈してmainブランチを赤にした。これは2値ゲートが「欠如」を「失敗」と読む例で、安全ではあるがやはり誤りだ。修正は第3の状態を与えた:空の本文は「チェックすべき本文なし」としてunmeasuredで報告し、CIステップはpull-requestイベント時のみ本文を書く。両事例ともリポジトリのlessonsファイル8.27と8.28に記載され、テストもある。
次に監査自身が自分に跳ね返った。CI内での初回実行は、赤1つ・緑1つの判定で戻り、緑が欠陥だった。赤は正直だった:テストランナーがインストールされておらず、監査はテスト実行を試みて失敗し、これを失敗と判定した。緑は合成チェック、各カウントをベースラインコミットと比較するもの。CIのチェックアウトにはローカルmainブランチがなく、ベースライン探索コマンドが失敗し、コードのフォールバックがエラーテキストをコミットID扱いして全カウントをゼロと読んだ。ゼロから何かへの変化はすべて成長なので、チェックは通った。サイレントデフォルトを検知するためのツールの中にサイレントデフォルトが潜んでいた。修正は他2件と同じ形:テストランナー欠如はunmeasured、解決不能なベースラインもunmeasured、5つのユニットテストがそれを担保する。これが8.29であり、前段で「監査は切り上げ不可」と書いた理由である。
なぜ「実行不能」は欠如ではなく投稿された状態でなければならないのか──五つのなぜ
| # | なぜ? | 理由 | 根拠 |
|---|---|---|---|
| 1 | なぜゲートに第3の状態が必要なのか? | 2値ゲートでは「実行しなかった」と「何も見つからなかった」が同じ出力となり、読者は区別できないからだ。 | 実例の11件すべてのブリーフは「unmeasured」だった(2026-09-09のPRコメントより)。2値設計なら全件がクリーン扱いになっていた。最初の2件は[17] |
| 2 | なぜ今はより深刻なのか? | 気づくはずの人間がますます見なくなっているからだ。エンタープライズ調査ではカバレッジが89%から68%に低下し、エージェント型PRの大半は人間レビューが入らない。 | [2, 3] |
| 3 | なぜ第3の状態はログではなく投稿でなければならないのか? | ログだけに存在する状態は、マージ判断の瞬間に誰も読まない状態だからだ。織機は現場で止まるのであって、台帳の中ではない。 | 1896年の織機の停止は検知そのもの([5]; 見えない赤の事例は、実行ログにしか存在せずマージ判断の場には現れなかった失敗を示した |
| 4 | なぜそれがパス扱いされてはならないのか? | 貢献度のある原因を偶然扱いしてしまうと、発見も排除も永遠にできない。unmeasuredをpassに切り上げる監査では、実際には一度も回っていないループが「健全」と報告されてしまう。 | Shewhart's postulate [(訳:シューハートの仮説[10];ループ監査は「AIがPRを測定したか」を意図的にunmeasuredのままにしている) |
| 5 | なぜ応答クロックがこのエピソードに含まれるのか | 誰にも応答されていないPRは、人間側の沈黙そのものである。Googleの「1営業日ルール」とアンドンコードは、どちらも「ラインを止める権利は、誰かが毎日それを行使して初めて意味を持つ」と言っている。 | [13, 11];初回実行で57時間経過した3件のPRにラベルが付与された) |
要点は一文で言い切れる。ゲートが実行できなかったという事実自体が一つの測定であり、その測定がマージ判断の場に掲示されなければ、測定は存在しなかったのと同じである。
30分で作る:沈黙しない契約
30分というのは、この契約をそのまま写して使う読者向けの目安であり、私が計測した時間ではない。三つ目の状態はレビュアーに1ブランチと1テストを加えるだけで済む。応答クロックは午前中でできた。三つのインシデントはそれぞれ午後に片付いた。
| 要素 | 仕様 |
|---|---|
| 三つの状態 | すべての自動判定はpass・fail・unmeasuredのいずれかを返し、各状態ごとにPR上に出力を掲示する。unmeasuredには理由(認証情報の欠如、401、拒否、パース失敗、このイベントタイプには入力なし等)をそのまま載せ、「これは合格ではない」という一文を添える。 |
| 空リストには理由を明記 | 報告すべき内容がなくて空になったセクションは、その理由を明示しなければならない。理由のない空欄は、そもそも計算されなかったセクションと区別がつかない。 |
| イベント依存の入力 | ゲートの入力がイベントタイプごとに異なる場合(pull-requestイベントにはPR本文があり、pushにはない等)、「入力不可」はunmeasuredであり、failにもpassにもしてはならない。 |
| 応答クロック | (PR、現在時刻、ポリシー)を入力とし、ok・needs-first-response・overdue-decision・exempt・draftのいずれかを返す純粋な分類器。ポリシーはデータとして:初回応答までの時間、決定までの日数、メンテナ一覧、無視するコメントマーカー、理由付きの免除リスト。プラットフォームのスケジューラ上でcron実行。2つのラベル、タイトルで特定する1つの上書き型ダッシュボード。 |
| 二分割ルール | ボットの契約が2つの出力(ラベルとボード)を持つ場合、どちらか一方しか出せなかったら、それは成功ではなく「足りない側を明示した失敗」として扱う。 |
| マージルール | マージはブランチのworkflow runの結論で判断し、checksリストでは絶対に行わない。ジョブ数ゼロでファイル名がrun名になっている場合はパース失敗=赤である。 |
| ガード | ワークフローファイルに空の式が含まれていれば失敗するテスト、そしてゲートスクリプトに自己テストがなければ失敗するテスト(エピソード5)。 |
| 意図的な未実装 | unmeasured でのリトライは行わない。ラベルとボード以上のエスカレーションも、ページングもなし。どれも静かに失敗する経路を増やすだけだ。 |
# The classifier is the whole bot; everything else is plumbing.
def classify(pr, now, policy):
    if str(pr.number) in policy["exempt"]:     return "exempt"      # with a written reason
    if pr.is_draft:                             return "draft"
    responses = [t for who, t, body in pr.activities
                 if who in policy["maintainers"] and who != pr.author
                 and not any(m in body for m in policy["ignore_comment_markers"])]
    if not responses:
        return "needs-first-response" if age_h(pr, now) > policy["first_response_h"] else "ok"
    return "overdue-decision" if age_h(pr, now) > policy["decision_days"] * 24 else "ok"

# The merge rule, as a command (the checks list cannot show a parse failure):
# gh run list --workflow ci.yml --branch <branch> --json conclusion   →  merge only on "success"
同じ原則、五つの立場
| リーダー | 唯一の判断 | 唯一のアクション |
|---|---|---|
| 学生 | 「何も言わなかった」は「チェックした」とは別物だ。 | 自分が頼る自動チェックを一つ選び、それが動かないときは必ず何か出力するようにしてみよう。 |
| エンジニア | 三つの状態をすべて投稿する。 | レビュアーに「unmeasured」分岐を加え、その文言を固定するテストを書く。 |
| ファウンダー | 応答クロックはポリシーファイルとcronで動くもので、人の記憶ではない。 | 「最初の応答までの時間(時間単位)」と「決定までの日数」、免除リストを書き、あとはプラットフォームに任せよう。 |
| エグゼクティブ | 見えない失敗こそが最大のコストになる。 | 自分のマージ判断が何を根拠にしているか、その画面が「一度も開始されなかったワークフロー」を表示できるかを確認しよう。 |
| インベスター | 自分で止まる織機は、速く織る織機より価値がある。 | 実際のPRで「could not run」と報告するゲートをチームに見せてもらおう。 |
パターン、アンチパターン、そして第一原理
定着したパターン 三つの状態それぞれに必ず投稿される出力。理由を明記した空リスト。イベント種別ごとに入力を分類。ポリシーファイル上で動く純粋関数としての分類器。常に上書きされるダッシュボード。ボット本番前の逆バリデーション実行。ツーハーフルール。
置き換えたアンチパターン キーがない場合、機械ゲートだけを出して正常レビューに見せかけるレビュアー。三つのPRが放置される間、提案書の中だけに存在したサービスレベル。肝心な失敗を表示できないリストを基準にしたマージ判断。入力が欠けているのを失敗入力として扱うゲート。
仕組みの本質 レビュアーもボットも、すべてのコードパスは必ず投稿で終わる。欠落は構造的に起こり得ず、唯一沈黙が生じるのは、プラットフォーム自体がコード実行前に落ちた場合だけだ──まさにマージルールがカバーする状況である。
第一原理を一文で 判断不能もまたシステムの事実であり、次の意思決定がなされる場に記録されなければならない。沈黙は状態ではなく、状態の不在である。
現場レポート
エピソード1で「57時間経過した三つのPRに、エピソード2までに応答クロックが動く」と約束した。その通り、ラベルが付き、ボードに一覧され、ボード作成ランの番号もドシエに記録されている。エピソード3までには、見えない赤を検知したループ監査がグリーンのmainブランチ上で再実行されてレポートがコミットされ、共同創業者の三つのPRも最初の応答があるか、なければボードがその旨を示し続ける。
関連エピソード
エピソード2:ANDON・エージェント型PRレビュー/CI・CD。すべての数値は出現箇所ごとにスコープされている。キッチンはあくまでモデルであり、測定値ではない。ここで述べたレビュアー、応答クロック、ループ監査、三つのインシデントはすべてプライベートリポジトリ内に存在し、その形は契約書で再現されているため、アクセス有無に依存しない。このエピソードが参照する四つの地平線のドシエはポートフォリオのplansディレクトリに記録されている。
参考文献
- GitHub,How pull request limits are cutting down the noise, 2026-06-18. github.blog
- He, Agarwal, Denisov-Blanch, Azaletskiy, Koyejo, Vasilescu, AI Writes Faster Than Humans Can Review: A Longitudinal Study of an Enterprise 2x Mandate、arXiv:2607.01904、2026-07-02。arxiv.org
- Duma ほか、These Aren't the Reviews You're Looking For、arXiv:2605.02273、2026-05-04。arxiv.org
- Peralta ほか、Why Are Agentic PRs Merged or Rejected?、arXiv:2605.22534、2026-05-21。arxiv.org
- Toyota Motor Corporation、Toyota Production System. global.toyota
- Toyota Industries Corporation、Sakichi Toyoda. toyota-industries.com
- Toyota Motor Corporation、75 Years of Toyota、Type G。toyota-global.com
- Autonomation、Wikipedia(Ohno 1988, pp. 6, 58 より引用)。en.wikipedia.org(補足:Ohnoの著書は参照できず)
- Best, Neuhauser, Walter A Shewhart, 1924年とホーソン工場、Quality & Safety in Health Care、2006年。pmc.ncbi.nlm.nih.gov
- Shewhart, Economic Control of Quality of Manufactured Product、Van Nostrand、1931年、Postulate 3(archive.orgスキャン)。archive.org
- Toyota UK, TMUKの25の象徴 ― アンドンコード, 2017-12-11. mag.toyota.co.uk
- Rigby, Bird, Convergent Contemporary Software Peer Review Practices、ESEC/FSE 2013。users.encs.concordia.ca(著者所蔵版、引用は再確認済み。Microsoft Researchのミラーは自動取得不可)
- Google Engineering Practices, コードレビューの速度. google.github.io
- Sadowski, Söderberg, Church, Sipko, Bacchelli, Modern Code Review: A Case Study at Google、ICSE-SEIP 2018、著者所蔵版。sback.it
- Anthropic, Code Review(Claude Code ドキュメント)code.claude.com
- Cursor, Bugbot ドキュメントcursor.com
- Paul Jialiang Wu, AI PR Review That Cannot Lie(2026-09-08、レビュアー設計と最初の2回の実行記録)futuremake.io