AI-Native Series · ANDON · Agentic PR Review and CI/CD · Episode 3 of 5
データとしてのPRレビュールール:ドリフトしない唯一のルール
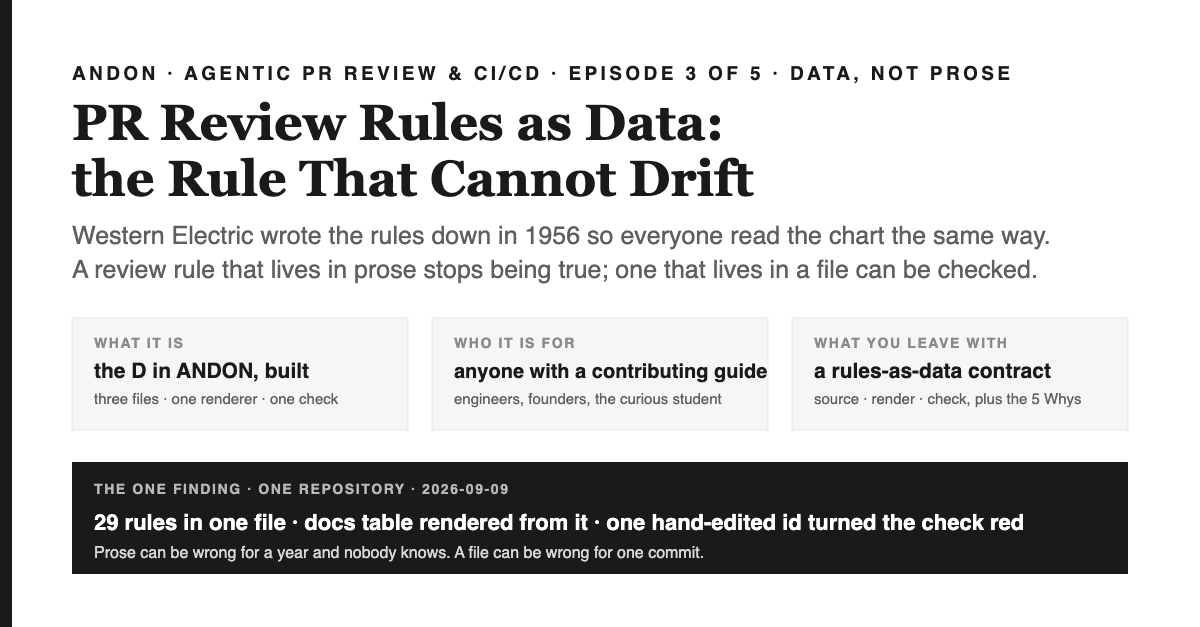
エージェント型PRレビューとCI/CD、第3話。1956年、Western Electricは管理図の読み方に関するルールを公表し、現場の作業者とエンジニアが同じチャートを同じように読めるようにした。ほとんどのリポジトリはレビュールールを散文のまま保持しており、レビュアーごとに読み方が異なり、AIレビュアーはそれを言い換えてしまう。この回はANDONの「D」にあたる。あるリポジトリのPRレビュールールを3つのデータファイルに移し、そこから人間向けのページをレンダリングし、さらにあらゆるPRでCI上に実行されるチェックを追加する。ページとデータが食い違った瞬間に失敗するチェックだ。2026年9月9日、そのチェックが出荷されてから3日後、私はわざとそれを赤くしてみせた。
1分でわかる要点——読んで持ち帰れるもの
これは何か。 ANDONの第3話——ANDON、エージェント型PRレビューとCI/CDをめぐる全五話シリーズ。今回はルールを散文ではなくデータ、実際のリポジトリに組み込まれたPRレビュールールのデータ化として実装した:マージルール、サイズの閾値、対応方針はそれぞれ一つのJSONファイルに置かれ、レビュアー、ゲート、そして人間向けのドキュメントページはすべてそれらのファイルを参照し、CIチェックがデータからドキュメントの表を再生成してページがドリフトしていれば失敗する。
なぜ重要か。 エンジニアにとって:散文で書かれたルールは、それを覚えている人だけが守るものであり、エージェント時代のリポジトリではそれがほぼ誰もいなくなり、モデルはそれを似て非なるものにパラフレーズしてしまう。創業者にとって:2026年のポリシー調査によれば、トップリポジトリの大半が今やAIによる貢献を許可しており、約半数が開示を義務付けている。私自身がそれらのポリシーを読んだ限りでは散文であり、人間しか解釈できないポリシーは、洪水のような量には対応できない。学生にとって:これは1956年のWestern Electric、1931年のShewhartと同じ動きを、コントリビューションガイドに適用したものだ。
読んだ後にできること。 あらゆるレビュールール、閾値、例外をid、レベル、それを強制するゲート、そして書かれた理由とともに一つのデータファイルに入れる。人間向けページはそのファイルからレンダリングし、決して手打ちしない。再生成して比較するチェックを追加し、一度は手で壊して赤くなるところを自分の目で確認する。
ANDON — シリーズの背骨
- A · Assess ― PR洪水は「感じる」ものではなく「測る」もの 第1話
- N · Never silent ― リポジトリの自働化 第2話
- D・Data, not prose(散文ではなくデータ) — ドリフトしないルール この回
- O・エンベロープの内側だけ――被害範囲はパスリストで決まる 第4話
- N · Negative test ― ゲートは意図的に赤になって初めて設置される 第5話
本エピソードが扱うこと、そしてなぜPRレビュールールのデータ化が三番目に来るのか
第1話は洪水を測定し、機械のゲートを最初に置いた。第2話はすべてのゲートに第三の状態を与え、「実行できなかった」が沈黙ではなく報告されるようにした。両エピソードとも、本エピソードが証明しなければならないあることを前提としていた——ゲートが強制するルールが、人間が「自分たちが強制していると思っているルール」と同じであるということだ。ほとんどのリポジトリでは、この前提は静かに崩れている。ルールはコントリビューションガイド、プルリクエストのテンプレート、Wikiページ、そして一部のレビュアーの習慣の中に存在している。CI設定はそのうちの一部を、ガイドのどこにも書かれていない数値で強制している。そしてAIレビュアーがいる場合、それはガイドを記憶からパラフレーズしたプロンプトを与えられているにすぎない。三人の読者、三冊のルールブック。
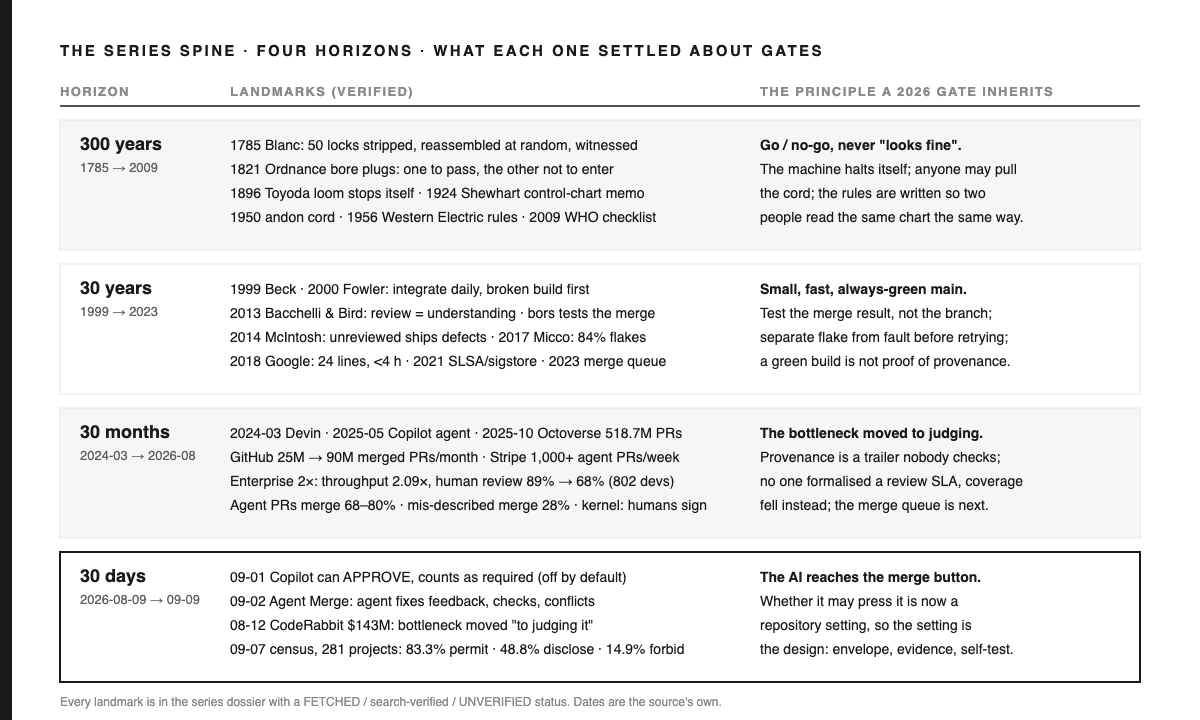
エージェント時代になると、これは単なる乱雑さでは済まず、コストを伴う問題になる。GitHubのトップ2000リポジトリにおける281件のAI貢献ポリシーを対象とした2026年の調査では、83.3%がAIの使用を許可し、48.8%が開示を義務付け、14.9%が禁止していることが判明した[1]。私自身の観察は、この調査の外側にある——私が読んだポリシーはいずれも散文であり、人間がPRごとに解釈しなければならないものだった。エージェントが作成した23,247件のPRを対象とした研究では、1.7%がPRの説明とコードの実際の内容との間に高い不整合を抱えていることがわかり、本シリーズの第1話ではすでに、説明を誤ったPRでも28%がマージされていることが記録されている[2]。説明が間違っている可能性があり、レビュアーがしばしばボットである以上、マージを決めるルールは一段落の文章であってはならない。
そこで、このエピソードのルールはこうなる——a rule is data first, and prose is rendered from it(訳:ルールはまずデータであり、散文はそこから生成される)。実例となるのはエピソード1、2と同じリポジトリだ。29件のレビュールール、4つのサイズ閾値、そして応答方針が、いまや3つのファイルに収まっている。ドリフトチェックが導入されてから3日後、私はルールIDをひとつ手作業で編集し、チェックが本当に赤くなることを証明した。実際に赤くなった。ローカル実行での話であり、終了コードも記録済みだ。
ルールの最古の姿——二人が同じように読めるよう書き記す
300年におよぶ記録は、判断が一人の頭の中から、二人が合意できる「モノ」へと移されてきた記録である。Roserによって再構成された、1785年7月8日、ヴァンセンヌでのHonoré Blancの実演はこうだった——"he disassembled 50 locks, picked pieces for 25 locks at random, and … assembled them again"(訳:彼は50個の錠前を分解し、25個分の部品をランダムに選び出し……それらを再び組み立てた) [3]:互換性は主張ではなく、誰でも再現できる実験によって証明された。Bomfordによる1821年の兵器局指示書はこう定めていた——"two plugs for the bore diameter, with one to pass through the barrel and the other not to enter"(訳:口径用のプラグを二本用意し、一方は銃身を通過させ、もう一方は入らないようにする) [4]:これは物理的な2つの物体からなるルールであり、合否判定には意見の入り込む余地がない。Joseph Whitworthの規格は、限界(リミット)という概念に先行していた。彼のワイヤーゲージに関するScience Museumの注記にはこうある——"The concept of tolerance or specification by limits of acceptability had not at that time been established."(訳:許容限界による公差、すなわち仕様という概念は、当時まだ確立されていなかった) [5] 規格が示すのは「正しい値は何か」である。限界(リミット)が示すのは「値が誤っていたときにどうするか」である。ゲートには限界が必要だ。
その後の一世紀を支える定義を与えたのがShewhartだった。1931年、彼はこう書いている——"A phenomenon will be said to be controlled when through the use of past experience, we can predict, at least within limits, how the phenomenon may be expected to vary"(訳:ある現象は、過去の経験を用いて、少なくとも一定の限界内でその変動をどのように予測できるかがわかるとき、「制御されている」と呼ばれる) [6]。制御とは、書き記された限界の内側で予測できることを意味する。そして1956年、Western Electricのハンドブックが、彼の管理図を読むための判断ルールを書き記した。その明言された理由は、二次資料の中に一文として残っている——"Their purpose was to ensure that line workers and engineers interpret control charts in a uniform way."(訳:その目的は、現場作業員と技術者が管理図を同じように解釈することを保証することにあった) [7] この一文こそが、このエピソードそのものだ。管理図自体はすでに存在していた。1956年が付け加えたのはルールブックであり、それによって機械の前にいる人間と、事務所にいる人間が、同じ図を見ながら食い違いを起こさなくなったのだ。
同じ動きは繰り返し現れる。Juranのハンドブックは1951年に初めて出版され[8]、ISO 9001は1987年、軍用仕様の系譜を継ぐ形でリリースされた[9]。そして2009年、カードに項目として書かれたルールである外科手術安全チェックリストが、8つの病院・7,688人の患者を対象に測定された。死亡率は1.5%から0.8%へ、合併症は11%から7%へと低下した[10]。いずれもソフトウェアの話ではないが、すべてが同じ主張をしている——アーティファクトに宿るルールは、専門知識に宿る同じルールよりも優れた成果を出す。アーティファクトは常に同じように読まれるからだ。
エピソード1のキッチンの比喩は、ここでも成り立つ。一人のコックはレシピを頭の中に留めておく。レストランはそれをカードに書き記す。チェーン店はそれをグラムと度数による仕様として書く。なぜなら、千のキッチンが同じように読み、誰一人としてアレンジを加えてはならないからだ。カードはレシピの劣化版ではない。それは検証可能な唯一の形なのだ。
| キッチン | リポジトリ |
|---|---|
| 仕様カード:グラム数、度数、唯一許された代替材料、承認済みのサイン | 3つのデータファイル:id・level・gate・checkを備えたルール、しきい値、例外とその理由を含む対応方針 |
| カードから生成され、決して手打ちされないメニュー | 2つのマーカーの間にJSONからレンダリングされたドキュメントページのルール表 |
| メニューがまだカードと一致しているかを確認する毎晩のカウント | CIにおけるドリフトチェック:再レンダリングし、比較し、差異があればexit 1 |
| 誰かがマーカーペンでメニューを書き換える | 2026-09-09にドリフトチェックを赤くしたルールidの手動編集(ローカル実行、CIが走らせるのと同じコマンド) |
30年後のバージョン:Googleはレビュアーの基準を書き記した。それは一文だ
同じ発想のソフトウェアにおける系譜はもっと短く、正典的な例が一つある。Googleの公開エンジニアリング・プラクティスは、レビュアーの基準を一文で述べている:"reviewers should favor approving a CL once it is in a state where it definitely improves the overall code health of the system"(訳:レビュアーは、CLがシステム全体のコードの健全性を確実に改善する状態になった時点で、それを承認する方向に傾くべきである) [11]。この一文は散文であり、Googleでそれが機能するのは、ほぼすべての変更にレビューを要求するレビュー文化と、小さな変更を前提に組み立てられたツール文化のなかに置かれているからだ [12]。それは、とても優れた厨房を持つレストランのレシピカードだ。その一文をメンテナー2人とAIレビュアーしかいないリポジトリにコピーすれば、それはまたルールのない管理図に戻ってしまう。2人のメンテナーは「確実に改善する」を互いに違う意味で読み、モデルは実行ごとに三通り目の読み方をする。
小規模なリポジトリに必要なのは、より良い一文ではなく、その一文をチェック可能な要素へと分解することだ。どの条件が機械で判定可能でブロックすべきものか、どの条件がAIが引用付きで提起してよい判断であり、どの条件が人間だけが答えられるものか——この分解自体がデータ構造であり、データ構造になった時点で、ドキュメントページ、レビュアーへのプロンプト、そしてゲートはすべて、それを言い換えるのではなく、そこから生成できるようになる。
構築:3つのファイル、1つのレンダラー、1つのチェック
1. ルールファイル
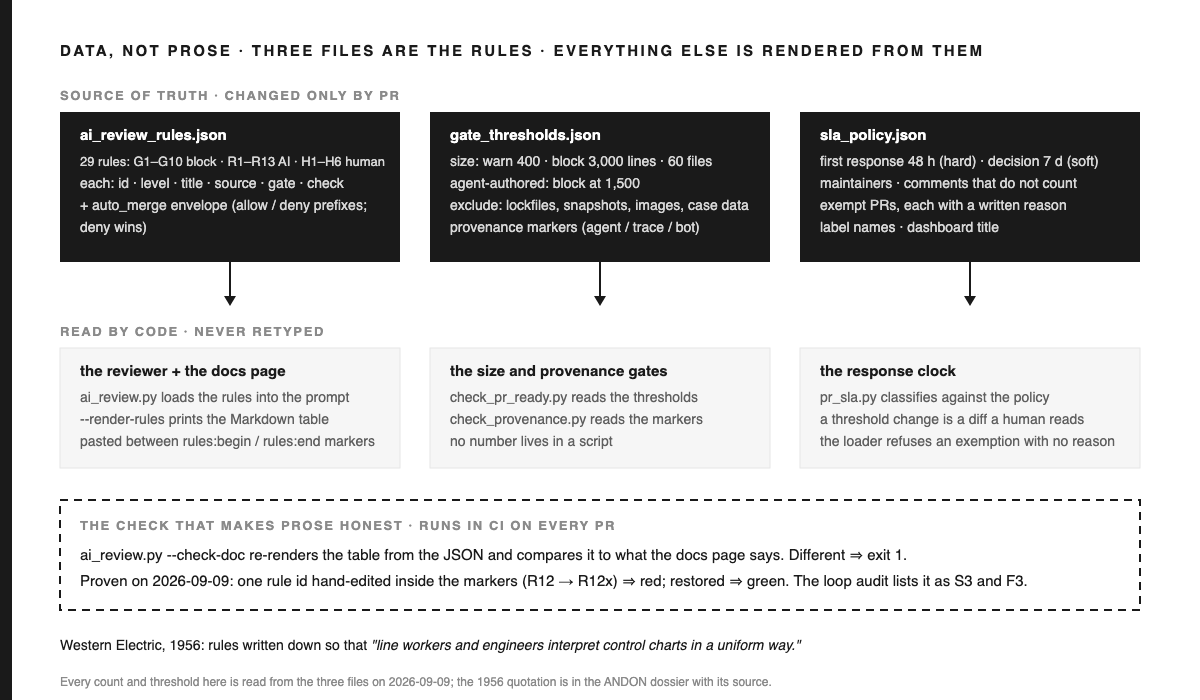
リポジトリのマージルールは1つのJSONファイルに存在し、本稿執筆時点で29のルールがある。各ルールは6つのフィールドを持つ:id、level、タイトル、そのルールの出典文書、それを強制するgate、そしてgateが行うcheckだ。levelは3種類のうちの1つ。10のルールがblock——テナント分離と書き込み権限、diffに秘密情報が含まれていないこと、マイグレーションを伴わないモデル変更、片側だけ変更されたバイリンガル文書、エピソード5のセルフテスト契約。これらはスクリプトによって強制され、赤ならマージできない。13のルールがai——AIレビュアーが引用付きで提起してよい問いであり、2026-09-06に1つのPRでチームが追加した3つのエンジニアリング原則、オブジェクト指向設計、ループエンジニアリング、グラフエンジニアリングを含む。6のルールがhuman——スクリプトもモデルも答えられない問い、ビジネスシナリオ、品質責任者、承認ノード、クローズ基準、メトリクス、そして今マージすべきかどうかであり、これはドメイン側の共同創業者だけが判断できる。
同じファイルには、先行記事のauto-mergeエンベロープも収められている。完全に緑で、完全に計測され、findingのないPRが人間なしでマージできるパスの前置詞・後置詞の範囲と、あらゆるallowに優先するdeny listだ。エンベロープがデータであるべき理由はルールと同じだ。「AIはワークフローディレクトリへの変更をマージできるか」と誰かが尋ねたとき、答えはファイルの中の一行であって、会話の記憶ではない。
2. 閾値と運用方針
サイズゲートの数値は2つ目のファイルに置かれている。有効行数400行で警告、3,000行または60ファイルでブロック、エージェントが書いたPRは1,500行でブロックする。有効行数を数える際は、ロックファイル、圧縮済みアセット、スナップショット、画像、フォント、生成されたケースデータを除外する。ファイル自身のドキュメンテーション欄が根拠を示している。すなわち、レビューの有効性が数百行を超えたところで崩れるという2006年の知見と、Googleの「小さな変更」規範だ。理由を明示した閾値はPRの中で議論の対象になり得る。スクリプト内の定数はそうはいかない。
episode 2で登場した応答クロックは3つ目のファイルを参照する。初回応答まで48時間、判断まで7日、メンテナー一覧、応答として数えないコメントマーカー、そして適用除外のPR群だ。適用除外にはそれぞれ、書面による理由が添えられている。ゲートが存在する前からあったレガシーPRと、意図的に開いたままにしているネガティブテスト用のPRだ。理由のない適用除外はローダーが拒否する、という建前だった。しかしこの一文は、本稿のレビュアーが初稿を読んだ時点では誤りだった。その要件はファイル自身のドキュメンテーション欄に、単なる説明文として書かれているだけで、ローダーは空文字列を受け入れてしまっていたのだ。このエピソードの主張が自分自身の実例の中で破綻していた、というまさにその発見こそ、「作った本人ではなくレビュアーが見つける」というルールが存在する理由そのものだった。そしてそのチェックは、同じ日のうちに追加され、マージされ、拒否することを証明する自己テストも添えられた。
3. レンダラーとチェック
ドメインチームにレビュールールを説明する人間向けページは、生成物である。あるコマンドがルールファイルをMarkdownの表としてレンダリングし、その表はドキュメントページ上の2つのHTMLコメントマーカーの間に貼り込まれる。マーカーの外側はすべて人間が書いた説明文であり、内側はすべてスクリプトが書いたデータだ。2つ目のコマンドは表を再レンダリングし、マーカーの間にあるものと比較する。差異があれば再生成の手順を1行で表示し、ステータス1で終了する。このコマンドはすべてのPRに対してCI上で実行され、episode 2で述べたループ監査の3つ目の構造的基準に当たる。
2026-09-09、私はゲートを証明する唯一の方法でそれを証明した。ドキュメントページを開き、マーカー内にあるloop engineeringルールの行を見つけ、そのidをR12からR12xに書き換えて、チェックを実行したのだ。ドリフトのメッセージが表示され、ステータス1で終了した。ファイルを元に戻して再度実行すると、今度はステータス0で終了した。この一対の終了コードこそが、タイトルの主張を裏づける証拠である。これがなければ、「ルールはドリフトしない」という主張自体が、ただの説明文で終わっていたはずだ。
ルールがデータになって変わったこと
散文のガイドのままでは起こり得なかったことが、このリポジトリで3つ起きた。第一に、ルールが「数」を持つようになった。29という数字は、見張ることのできる数字だ。ループ監査の複利的基準がgitの履歴からこれを読み取り、9月1日のベースラインから執筆時点までに0から29へと増えたことを、テストやlessonsと並べて報告する。ガイドには数がない。だからトレンドもない。第二に、ルールが「出典欄」を持つようになった。29のルールはそれぞれ、自分がどの文書に由来するかを名指している。たとえばloop engineeringのルールは、lessonsファイルと応答提案書を出典として挙げている。共同創業者であるドメイン担当者が「なぜレビュアーはセルフテストの欠落を指摘したのか」と尋ねたとき、答えは記憶ではなく一行のデータになる。第三に、ルールはAIがそのまま読むものになった。レビュアーのプロンプトは、ドキュメントページのレンダリング元と同じファイルから組み立てられる。そのため、モデルは毎回同じ29行の表を渡され、そのうち13行が自分の答えるべき項目であり、人間は何が渡されたのかを正確に確認できる。前作の記事で示した「すべての指摘には出典が必要」というルールには、いまや相棒ができた。モデルに投げかけられるすべての問いにidが付いている、というルールだ。
変わらなかったことも述べておく価値がある。表の周囲にある説明文——キッチンの喩えを使って新しいチームメンバーに三層構造を説明する部分——は、依然として説明文のままだし、それでいい。データが説明文に取って代わるのは、説明文がルールのふりをしていた箇所においてだけだ。説明そのものに取って代わるわけではない。
なぜなぜ分析:レビュールールがルールである前にデータでなければならない理由
| # | なぜ? | なぜなら | 根拠 |
|---|---|---|---|
| 1 | なぜルールをCONTRIBUTINGガイドに置き続けてはいけないのか? | なぜならガイドは、レビュアーごとに読み方が異なり、モデルも実行するたびに違う読み方をするからだ。結果として、リポジトリには読み手の数だけルールブックが存在することになる。 | Western Electricがルールを書き記した目的として述べたもの [7];Googleの一文だけの基準は、Google独自の教育とツールの文化の中でしか機能しない [11] |
| 2 | なぜエージェントの時代になるとそれが悪化するのか? | なぜなら、人間の読み手はますます不在になりつつあり、PRの説明は間違っていることがあるからだ。AIポリシーの大半はAIの利用を許可しており、私の見るところそれらは説明文にすぎない。そして説明を誤ったPRは、それでもマージされ続けている。 | [1, 2];episode 1のカバレッジ数値 |
| 3 | なぜ両方を手書きするのではなく、データからドキュメントをレンダリングするのか? | なぜなら、あるルールについて手書きのコピーが2つあれば、それは食い違っていく運命にある2つのルールにすぎず、その食い違いには何のシグナルもないからだ。レンダリングされたコピーであれば、出典はただ一つしかない。 | ドリフトチェックが存在できるのは、ページがレンダリングされたものだからにほかならない。手書きのページは、比較する相手を持ちようがない |
| 4 | なぜチェックはリリーススクリプトではなくCIで実行しなければならないのか? | エピソード2の原則がここでも成り立つからだ。マージ判断が見ない場所で実行されるチェックは、実行されていないのと同じである。リリース時点でドリフトが発覚しても、そのときにはもうマージは済んでいる。 | このチェックはCIのステップであり、ループ監査の基準の一つでもある。手動編集の実証実験でも、CIが使うのと同じ実行形式でexit 1が出た |
| 5 | なぜすべての例外と閾値に、書かれた理由が必要なのか? | Shewhartの言う「統制されている(controlled)」とは、書かれた限界内で予測可能であることを意味するからだ。理由のない限界は改訂できず、上書きされるしかない。そして上書きこそが、データの内側に散文を再び生やす仕組みなのである。 | [6)。閾値ファイルは2006年の知見とGoogleの出典を引用しており、方針ファイルの二つの例外にはそれぞれ理由が付されている |
根本原因を一文で言えば:誰も差分を取れないルールは、それがまだ有効であると誰にも証明できないルールであり、レビュアーがモデルである可能性のあるリポジトリにおいて、有効であると証明できないルールはもはやルールではない。
30分で作る:ルールをデータとして扱うための契約
30分というのは、このコントラクトをコピーする読者のための予算であって、私が実際に計測した時間ではない。
| 要素 | 仕様 |
|---|---|
| ルールファイル | 単一のJSONファイル。各ルールは以下を持つ:id, level ∈ {block, ai, human}、title, source(そのルールの出典となった文書や決定)、gate(それを強制するスクリプトやステップ、あるいは「human」)、check(実際に検証される内容)。ゲートのないルールは存在しない。ゲートが「none」のルールは願望にすぎず、願望は散文の中に置く。 |
| 閾値ファイル | ゲートが比較に使うすべての数値には、_docフィールドでその根拠を明示する。生成ファイルの除外リストも含む。ゲートスクリプトの中に数値リテラルを直書きしない。 |
| 方針ファイル | 応答時間、メンテナー一覧、応答としてカウントしないコメントマーカー、そしてidから書かれた理由へのマップとしての例外。ローダーは空の理由を拒否し、セルフテストがそれを証明する。 |
| レンダラー | レンダラーが1つのコマンドで、ルールファイルから人間向けのテーブルを出力する。ドキュメントページには2つのマーカーがあり、テーブルはその間に置かれる。それ以外の場所には何もない。 |
| ドリフトチェック | 1つのコマンドがマーカー間のテキストを再レンダリングし、比較する。差異があれば再生成の指示を出力し、exit 1で終了する。CIで全PRに対して実行される。 |
| 利用者側 | AIレビュアーはルールファイルからプロンプトを組み立てる。ゲート群は閾値を読み込む。応答ボットはポリシーを読み込む。どれもコピーを持たない。 |
| 証明 | チェックが実運用で使われる前に、マーカー間のidを1つ手動で書き換え、チェックを実行してexit 1を記録し、復元してexit 0を記録する。両方のexitコードをchangelogに残しておく。 |
| 意図的に持たせないもの | ルールエンジンなし、スキーマ言語なし、YAMLアンカーなし、1つのテーブル以上のテンプレート機能もなし。どれもルールが住み着く場所をもう一つ作ってしまうだけだ。 |
# The whole contract fits in the shape of the file and one comparison (ids real; text abridged).
{
  "rules": [
    {"id": "G1",  "level": "block", "title": "tenant isolation + write permission",
     "source": "AGENTS S1/S2", "gate": "check_tenant_perm.py", "check": "every query filtered by company; every write behind a role"},
    {"id": "R12", "level": "ai",    "title": "loop engineering",
     "source": "docs/05 §8.24 · proposal §3.4", "gate": "ai_review.py", "check": "does the change close a loop or open one?"},
    {"id": "H1",  "level": "human", "title": "business scenario",
     "source": "docs/01", "gate": "human", "check": "domain co-founder only"}
  ],
  "auto_merge": {"allow_prefixes": ["docs/", "plan/"], "deny_prefixes": [".github/", "scripts/"]}
}

# ai_review.py --check-doc
rendered = render_rules(load("scripts/ai_review_rules.json"))
current  = between(DOC.read_text(), "<!-- rules:begin -->", "<!-- rules:end -->")
sys.exit(0 if rendered.strip() == current.strip() else 1)   # different ⇒ red
同じ物語、5つの出口
| 読者 | 決めるべきことは一つ | とるべき行動は一つ |
|---|---|---|
| 学生 | チェックできないルールは、単なる助言にすぎない。 | 自分が従っているガイドからルールを一つ選び、id・level・gate・checkの形で書き出してみること。 |
| エンジニア | まずデータ、そこから散文をレンダリングする。 | レビュールールを1つのファイルに移し、そこからdocsのテーブルを生成し、比較してexitするチェックをCIに追加すること。 |
| 創業者 | 自社のAIポリシーは散文であり、散文はPRの奔流には対応しきれない。 | 自社のどのコントリビューションルールならスクリプトで今すぐチェックできるかを洗い出し、今週中にそれをファイルに落とし込むこと。 |
| 経営層 | 1956年は、ルールがエンジニアたちの頭の中から外に出た年だ。 | レビュールールがどのファイルに存在するか見せてもらうといい。答えが「ドキュメントです」なら、それはチャートであってルールではない。 |
| 投資家 | ルールにカウントがあるチームには、読み取れるトレンドがある。 | そのチームがレビュールールをいくつ持っていて、その数がいつ最後に変わったか尋ねてみるといい。 |
パターン、アンチパターン、そして第一原理
うまくいったパターン。 ルールの種類ごとに一つのファイル。ルールごとに6つのフィールドを持ち、ゲートと出典は必須。根拠が文書化された閾値。理由なしには書けない例外。マーカーの間にレンダリングされたページ。比較して終了コードを返すチェック。チェックが信頼される前の、手動編集による証明。
これが置き換えたアンチパターン。 スクリプトが何一つ強制していないルールを列挙したコントリビューションガイド。ゲートスクリプトの中に定数としてのみ存在するサイズ制限。ガイドを言い換えただけのレビュアープロンプト。比較対象が何もないまま、手打ちされるはずだったドキュメントの表。
この仕組みに名前を与えるなら。 すべてのルールにはコピーがただ一つしか存在せず、それ以外のあらゆる出現箇所はそのコピーの関数にすぎない。ドリフトチェックとは、その関数を二度適用して比較する処理であり、差異が生じるとすれば、それは誰かがその関数を迂回したときだけだ。
第一原理を、一文で。 ルールとは、差分を取れるものである。それ以外はすべて、それに対する注釈にすぎない。
現実のミッション
エピソード2では、エピソード3までにループ監査をグリーンなmainブランチ上で再実行し、そのレポートをコミットすると約束していた。それは達成された。監査は最初のレポートとともにマージされ、監査自身が抱えていた2つのサイレントなデフォルト値も同日中に修正され、mainブランチの実行はグリーンになり、更新されたレポートはエンベロープが正しく分類したドキュメントのみのPRとして着地し、人間がマージした。21の基準がパスし、失敗はゼロ、未測定が2つ残る。すなわちAIはまだPRを一件も測定しておらず、Tier-1もまだ一件もマージしていない。共同創業者による3件のPRは依然として「first-response」ラベルを保持しており、ボードもそう表示している。
| シーズン・スコアボード | エピソード1(2026-09-09、14:00 UTC) | 現在(2026-09-09、17:00 UTC) |
|---|---|---|
| 初回応答のない、最も古いオープンPR | 57時間(3件のPR) | 依然としてその3件のまま。ラベル付けされ、ボードに載っている |
| 赤くなり得ることを自己テストで証明済みのゲート | 6件中0件 | 9件中9件。監査のS5基準が列挙する9件であり、CI上のランナーによって強制されている |
| 9月1日以降のエージェント支援コミットのうち、トレース・トレーラーを付与したもの | 未計測 | 21件中11件。プロヴェナンス・ゲートが新規コミットにこれを必須化した |
| 未計測の監査基準 | まだ監査になっていない | 23件中2件、いずれもコード外の事情待ち |
エピソード4までに、ルールファイル内の自動マージ・エンベロープは実際のドキュメントのみのPRに対してテスト済みとなり、ブランチ保護の状態も正直に報告される予定だ。無料プランではエンベロープは分類はできてもまだマージはできず、記事はそのどちらであるかを明記する。
次に読む
ANDON・エージェント型PRレビューとCI/CDエピソード3。数字はすべて、それが登場する箇所でスコープが示されている。キッチンの比喩はモデルであって測定ではない。3つのデータファイル、レンダラー、チェック、そして手作業による改変の証明は非公開リポジトリに存在する。それらの形は本稿の契約仕様に再現されているため、リポジトリへのアクセス権がなくても内容は理解できる。本エピソードが引用する四地平ドッシエは、ポートフォリオのplansディレクトリに記録されている。
参考文献
- Hora, Robbes, Zacchiroli, "We Permit the Use of AI, but […]"(訳:われわれはAIの利用を許可するが……)、arXiv:2609.07542、2026年9月7日。arxiv.org
- Gong et al., エージェント作成PRにおけるメッセージとコードの不整合、arXiv:2601.04886、2026-01-08。 arxiv.org
- Roser、 230 Years of Interchangeable Parts、AllAboutLean、2015-07-08。 allaboutlean.com
- Raber, Malone, Gordon, Cooper、 Conservative Innovators and Military Small Arms: Springfield Armory 1794–1968、NPS 1989/2006、p. 138。 npshistory.com
- Science Museum Group、 Whitworth standard wire gauge、object co59414。 collection.sciencemuseumgroup.org.uk
- Shewhart、 Economic Control of Quality of Manufactured Product、Van Nostrand、1931年(archive.orgスキャン)。 archive.org
- Western Electric rules, Wikipedia(Western Electricの Statistical Quality Control Handbook, 1956). en.wikipedia.org(二次資料。ハンドブック本体は未確認)
- Juran Institute、 History of Quality Management System. juran.com
- Quality Digest、 25 Years of ISO 9001, 2012-04-12. qualitydigest.com
- Harvard Gazette on Haynes et al., NEJM 360:491-9, 2009-01. news.harvard.edu
- Google Engineering Practices、 The Standard of Code Review. google.github.io
- Software Engineering at Google、第9章、Code Review、2020年。 abseil.io