Serie AI-Native · ANDON · Revisión de PR agéntica y CI/CD · Episodio 2 de 5
Jidoka para repositorios: la compuerta de PR que nunca se queda callada
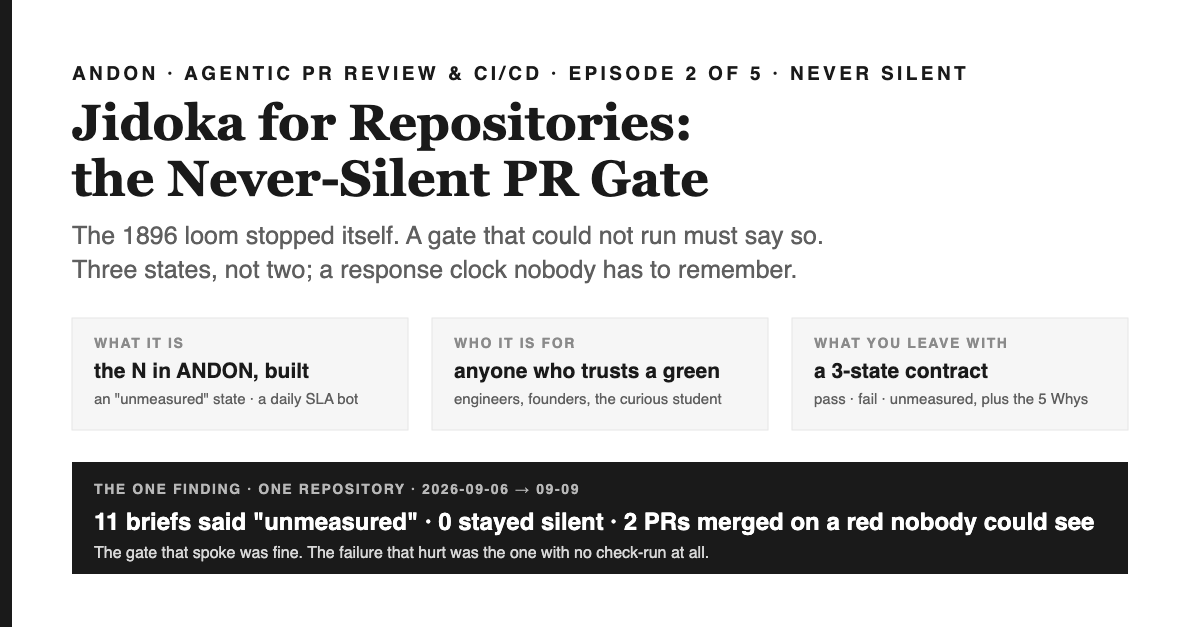
Revisión de PR agéntica y CI/CD, episodio 2. En 1896, un telar aprendió a detenerse solo cuando se rompía un hilo. La mayoría de los pipelines de CI nunca aprendieron esa lección: una compuerta que no pudo ejecutarse se ve exactamente igual que una que no encontró nada, y ambas aparecen en verde. Este episodio es la N de ANDON. Construye una compuerta con tres estados en vez de dos, un reloj de respuesta que corre en el cron en GitHub y no en la memoria de nadie, y luego reporta la única falla que el diseño no detectó, porque no tuvo voz alguna.
Tu resumen exprés — lo que te llevas en un minuto
De qué va esto. Episodio 2 de ANDON, una serie de cinco partes sobre revisión de PR agéntica y CI/CD. Esta es la regla nunca silenciosa, implementada en un repositorio real como una compuerta de PR con voz propia: un revisor de IA con tres estados (pass, fail y unmeasured), un bot de respuesta que etiqueta los pull requests y reescribe un dashboard cada día sin que nadie tenga que recordarlo, y el reporte honesto de una falla que no tuvo estado alguno.
Por qué importa. Para un ingeniero: las compuertas de dos estados mienten por omisión, porque "could not run" se muestra como "found nothing", y la avalancha hace que esa omisión sea rutina. Para un fundador: los datos empresariales muestran que la cobertura de revisión humana cayó del 89 al 68 por ciento mientras el throughput se duplicó, así que la señal que estás perdiendo es justo la que esconde una compuerta silenciosa. Para un estudiante: esta es la idea más antigua del control de calidad, una máquina que se detiene sola, aplicada al problema más nuevo.
Qué puedes hacer después de leer. Dale a cada juicio automatizado tres estados y una salida publicada para cada uno. Pon un reloj de respuesta en el cron en GitHub con un archivo de política y un dashboard que se sobrescribe, nunca se acumula. Y adopta la regla de merge que costó este episodio: haz merge según la conclusión del workflow run, nunca según la lista de checks, porque una falla sin check-run es invisible ahí.
ANDON — la espina de la serie
- A · Assess — La inundación de PRs se mide, no se siente episodio 1
- N · Nunca silenciosa — Jidoka para repositorios este episodio
- D · Data, not prose — La regla que no puede desviarse episodio 3
- O · Solo en el perímetro — El radio de impacto es una lista de rutas episodio 4
- N · Prueba negativa — Una compuerta solo se instala después de haber marcado error a propósito episodio 5
Qué cubre este episodio, y por qué la compuerta de PR nunca silenciosa va en segundo lugar
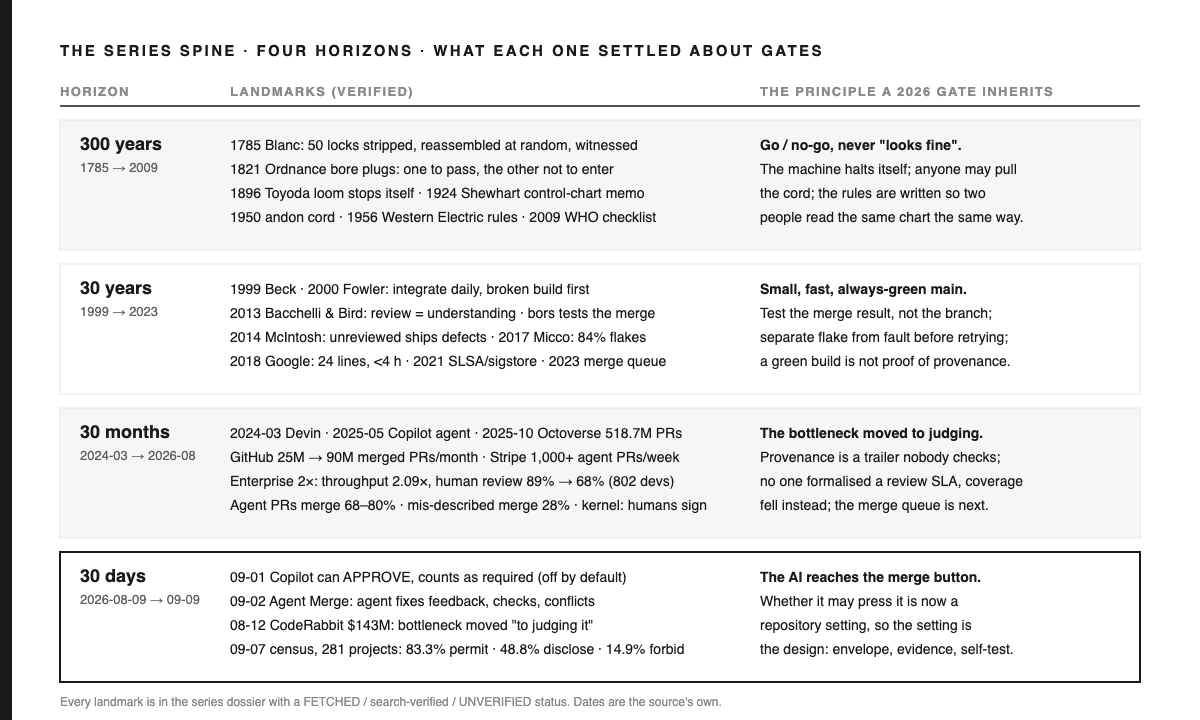
El episodio 1 midió el flujo: los pull requests fusionados en GitHub se más que triplicaron entre enero de 2023 y mediados de 2026, y dentro de una empresa que se midió a sí misma, el throughput per cápita llegó a 2.09 veces su línea base mientras la proporción de PRs con revisión humana cayó del 89 al 68 por ciento [1, 2]. Terminó con la compuerta automática: una balanza imparcial que decide solo lo que puede decidir un script. Este episodio trata de lo que hace la balanza cuando no puede pesar.
Ese caso no es raro. Un revisor de IA necesita una credencial; las credenciales expiran, se pegan mal, se rotan. Una compuerta que lee el cuerpo del pull request no recibe cuerpo en un evento push. Un archivo de workflow puede fallar al analizarse. Un bot que escribe un dashboard puede encontrar la función de dashboard desactivada. En cada uno de esos casos, una compuerta de dos estados (pass o fail) produce su estado de pass por defecto, porque nada corrió y nada falló. Quien lee el PR lo ve como aprobado. La literatura señala que el lector es cada vez más el único humano que mirará: un estudio de 2026 sobre cómo los humanos revisan PRs generados por IA encontró que la mayoría no recibe revisión humana, y las revisiones que sí ocurren son en su mayoría escritas por bots [3], y una inspección manual de 11,048 PRs agénticos encontró que el 5.5 por ciento no mostró ningún rastro visible de interacción [4].
Así que la regla para este episodio es simple: una compuerta tiene tres estados, y el tercero se comunica. El caso práctico es el mismo repositorio privado de gestión de calidad del episodio 1, donde las primeras once ejecuciones en vivo del revisor de IA terminaron todas en el tercer estado, un bot de reloj de respuesta corrió por primera vez, y ese mismo día, dos PRs se fusionaron sobre un fallo que no produjo ningún estado. Los cinco porqués al final preguntan por qué el tercer estado debe ser un comentario publicado y no una ausencia, y la respuesta nos lleva de vuelta a un telar en 1896.
La versión más antigua de la regla: una máquina que se detiene sola
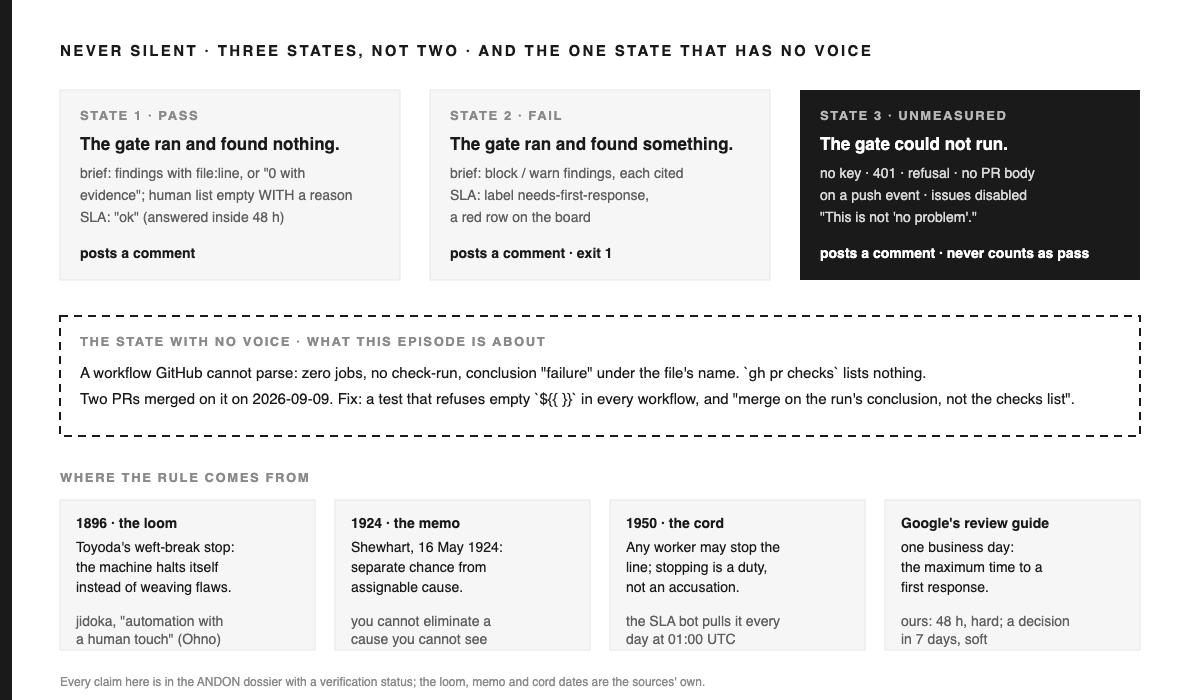
La propia versión de Toyota sobre su sistema de producción empieza con un telar. El telar mecánico de Sakichi Toyoda de 1896 llevaba lo que la empresa describe como "a new weft-breakage automatic stopping device (developed in 1896)" (Traducción: un nuevo dispositivo automático de parada por rotura de trama, desarrollado en 1896): cuando se rompía el hilo de la trama, el telar se detenía en vez de tejer un defecto en la tela [5]. El telar automático Tipo G se detenía tanto por un hilo de urdimbre roto como por uno de trama, y el primero salió de la línea de producción en noviembre de 1925 [6, 7]. El comentario de Taiichi Ohno sobre el principio, jidoka, es "automation with a human touch." (Traducción: automatización con un toque humano.) [8] El punto del telar no era que detectara un hilo roto. Era que detectar y detenerse eran el mismo evento: la máquina no podía seguir en un estado defectuoso sin que una persona lo supiera.
Aquí importan dos piezas más del linaje. El 16 de mayo de 1924, Walter Shewhart envió a sus supervisores en Western Electric un memorando proponiendo el gráfico de control [9], la herramienta que separa la variación aleatoria de lo que él llamó causas asignables; su libro de 1931 enuncia el postulado directamente: "Assignable causes of variation may be found and eliminated." (Traducción: Las causas asignables de variación pueden encontrarse y eliminarse.) [10] Una causa que no produce señal no puede encontrarse, y por lo tanto no puede eliminarse. Y el uso de Toyota del sistema andon, el cordón que cualquier operario puede jalar para detener la producción, se remonta a 1950 según la propia empresa; la descripción es que "a team member on the production line can pull the cord to flag up the issue, stop the process and receive immediate assistance." (Traducción: un miembro del equipo en la línea de producción puede jalar el cordón para señalar el problema, detener el proceso y recibir asistencia inmediata.) [11] Detenerse es un derecho y un deber, no una acusación.
La imagen de la cocina del episodio 1 sigue siendo válida. La báscula es el pass uno. Lo que este episodio suma es la batidora que se detiene cuando se rompe un resorte, y el cocinero que dice en voz alta "la báscula está rota" en vez de adivinar el peso. Ninguno es un juicio sobre el platillo. Ambos son la cocina negándose a seguir en un estado desconocido.
| Cocina | Repositorio |
|---|---|
| La batidora que se detiene cuando se rompe un resorte | El tercer estado del revisor: "unmeasured", publicado en el PR con la razón |
| El temporizador del ticket del expedidor, que suena solo | El reloj de respuesta: un cron en GitHub, 48 horas para la primera respuesta, 7 días para una decisión |
| Un ticket que nunca se imprimió, así que nadie lo cocina y nadie se entera. | Un workflow que no se puede analizar: no hay check-run, nada en la lista de checks. |
Las cifras del silencio: qué tan poca parte del flujo recibe una mirada humana.
La razón por la que el tercer estado importa más en 2026 que en 2016 es que el respaldo humano se está debilitando. La práctica convergente de la revisión moderna de código, medida en 2013, era "performed regularly and quickly just before the code is committed" (Traducción: se realizaba de forma regular y rápida justo antes de hacer commit del código), normalmente por dos revisores, con tiempos medianos de finalización de entre quince y veintiuna horas [12]. La guía de ingeniería de Google marca la pauta en una frase: "One business day is the maximum time it should take to respond to a code review request" (Traducción: Un día hábil es el tiempo máximo que debería tomar responder a una solicitud de revisión de código) [13], y su estudio de 2018 sobre unos nueve millones de cambios revisados encontró una latencia mediana de revisión completa menor a cuatro horas [14].
Frente a ese referente, los números de la era agéntica muestran un colapso de cobertura más que de velocidad. En el estudio empresarial, la cobertura de revisión por IA subió de alrededor del 19 al 84 por ciento de los PR, mientras que la cobertura humana cayó del 89 al 68 por ciento [2]. Entre los PR agénticos en GitHub, la mayoría no recibe revisión humana alguna [3]. De 717 PR inspeccionados manualmente, un tercio de los rechazos no tenía justificación observable, y el 5.5 por ciento no mostró rastro visible de interacción alguna [4]. Los valores predeterminados de los proveedores cuentan la misma historia desde el otro lado: la revisión de código gestionada por Anthropic publica un neutral check en vez de uno bloqueante y promedia entre quince y veinticinco dólares por ejecución [15]; Bugbot de Cursor reporta un estado neutral a menos que optes por fallar ante problemas no resueltos [16]. Un neutral check es una forma educada de silencio: está ahí, y no decide nada.
Ninguno de los estudios del dossier encontró una organización que respondiera al volumen agéntico con un nivel formal de servicio de revisión. El registro de treinta meses muestra que la cobertura cae en vez de subir. Esa brecha es justo lo que la segunda mitad de este episodio viene a cubrir.
La construcción: tres estados, y un reloj en el cron en GitHub.
1. El tercer estado del revisor de IA
El revisor del artículo precursor y del episodio 1 lee el diff, ejecuta los machine gates, le pide al modelo hallazgos estructurados, descarta cualquier hallazgo sin file:linecitación, y publica un comentario por PR. El cambio que lo hace realmente no silencioso es pequeño en código y grande en consecuencia: no hay ningún camino en el programa que termine sin un comentario publicado. Si falta la credencial, si la plataforma devuelve un error de autenticación, si el modelo se niega, si la salida estructurada no se puede analizar, el brief genera una sección titulada "unmeasured" con la razón exacta, seguida de la frase "esto no es 'sin problema'", seguida de los resultados de los machine gates y una nota de que toda pregunta solo-humana ahora necesita a una persona. El workflow lo publica de todos modos. Un test unitario fija cada frase para que un refactor no pueda restaurar en silencio la versión de dos estados.
El registro en vivo es la evidencia, leída de los comentarios de los PR el 2026-09-09 (las dos primeras ejecuciones se describen en [17]). Entre el 2026-09-06 y el 09-09 el workflow se ejecutó en cada pull request del repositorio desde el que lo introdujo en adelante, once en total, y publicó un brief en los once; los once decían "unmeasured", primero porque el repositorio no tenía clave, luego porque la clave que se le dio fue rechazada con un 401; ninguno quedó en silencio. El loop audit construido al final de esta ejecución lee esos dos hechos directamente de la API de GitHub y los reporta como los criterios "cada PR lleva un brief" y "unmeasured se publica, nunca silencio", ambos aprobados, mientras que el criterio "la IA realmente ha medido un PR" permanece en unmeasured hasta que exista una credencial válida. El loop audit no puede redondear eso, y el tercer incidente más abajo es lo que pasó la única vez que lo hizo.
2. El reloj de respuesta
La propuesta del propio repositorio había medido el problema el 2026-09-02: todos los PR fusionados eran auto-autorizados, ninguno revisado, y el PR abierto más antiguo llevaba 398 horas. Cualquier solución que dependa de que alguien recuerde solo repetiría ese historial. Así quedó sin implementarse durante una semana. El 2026-09-07, el cofundador del dominio abrió tres pull requests; para la mañana del 09-09, llevaban cincuenta y siete horas sin respuesta de un responsable, justo la brecha que la propuesta buscaba evitar. Esa mañana se construyó el bot.
Es una función pura más un cron en GitHub. La función toma un pull request, la hora actual y un archivo de política, y devuelve uno de cinco estados: ok, needs-first-response, overdue-decision, exempt o draft. Se considera actividad de responsable cualquier comentario, revisión, merge o cierre hecho por un nombre en la lista de responsables de la política, con tres exclusiones que salieron de los tests unitarios: los comentarios del propio autor no cuentan, aunque sea responsable; los comentarios del revisor de IA no cuentan, porque el "unmeasured" de una máquina no es lo mismo que el "lo he visto" de una persona; y los comentarios del dashboard tampoco cuentan. Cuarenta y ocho horas sin respuesta de un responsable es el umbral estricto; siete días sin decisión es el flexible. Dos PR están exentos por número, con la razón escrita en la política: un PR heredado de antes de que existieran las compuertas, y el PR de prueba negativa abierto a propósito del artículo precursor.
El cron corre a diario en la infraestructura de GitHub. En cada ejecución aplica o quita dos etiquetas y reescribe un issue de dashboard en el lugar, encontrado por título, así que el dashboard es una sola superficie sobreescrita, no un hilo creciente de alertas. La primera ejecución en vivo, lanzada a mano como validación inversa que pedía la propuesta, etiquetó los tres PR del cofundador y dejó los dos exentos sin tocar. Luego salió con código distinto de cero, porque el repositorio tenía los issues deshabilitados y no se pudo crear el dashboard. Eso era el comportamiento correcto: el contrato tiene dos mitades, etiquetas y dashboard, y una ejecución que entrega solo una mitad reporta la otra como fallo, no como éxito. Se cambió la configuración del repositorio, el bot se volvió a ejecutar y el dashboard apareció con tres filas incumplidas y dos exentas. Ahora el bot nombra ese fallo en palabras claras cuando vuelve a ocurrir.
El estado sin voz: hacer merge sobre un rojo invisible
Aquí está el fallo que el diseño no captó, contado tal como ocurrió. Un pull request fusionado esa mañana añadió un comentario al archivo de workflow de CI. El comentario contenía, como texto, un par literal de llaves de expresión vacías, con la intención de decir "no interpolar expresiones en el shell". GitHub evalúa expresiones en todo el archivo de workflow, incluidos los comentarios, y una expresión vacía es un error de parseo. Desde ese commit, el workflow no pudo ejecutarse.
Lo importante es cómo se ve eso desde fuera. Un workflow que no se puede parsear produce una ejecución con cero jobs, una conclusión de failure y un nombre que es la ruta del archivo en vez del nombre del workflow. No produce check-runs. El comando que lista los checks de un pull request, que era lo que yo usaba para decidir si hacer merge, no mostraba nada para ese workflow. Mostraba el resultado del otro workflow y se detenía. Hice merge de ese pull request, y luego de un segundo, sobre un rojo que no tenía fila.
El loop audit lo detectó ese mismo día, porque su criterio práctico para CI lee la conclusión de la última ejecución en la rama principal, no la lista de checks, y esa ejecución decía failure con el nombre del archivo. La solución fue cambiar el comentario, un test unitario que falla si algún archivo de workflow contiene una expresión vacía, una lección en el propio registro del repositorio y una nueva regla de merge para mí: juzgar un pull request por la conclusión del workflow run, nunca por la lista de checks, porque el estado que duele es el que la lista no puede mostrar.
Esa misma tarde el audit detectó un segundo fallo de la misma familia pero en sentido opuesto. La nueva compuerta de procedencia exige que un PR escrito por un agente pegue su salida de verificación en el cuerpo del PR. En un evento push, después de hacer merge, no hay cuerpo de PR, así que el paso de CI escribió un archivo vacío y la compuerta leyó el vacío como "falta la sección" y puso la rama principal en rojo. Eso es una compuerta de dos estados leyendo la ausencia como failure en vez de como pass, lo cual es más seguro, pero sigue estando mal. La solución le dio el tercer estado: un cuerpo vacío es "no hay cuerpo que revisar", reportado como unmeasured, y el paso de CI solo escribe el cuerpo en eventos de pull request. Ambos incidentes están en el archivo de lecciones del repositorio como entradas 8.27 y 8.28, y ambos tienen test.
Luego el audit se lo hizo a sí mismo. Su primera ejecución dentro de CI volvió con un criterio en rojo y uno en verde, y el verde era el defecto. El rojo era honesto: el job no tenía test runner instalado, el audit intentó correr los tests, no pudo y lo marcó como failure. El verde era el check de crecimiento, el que compara cada cuenta contra un commit de línea base. El checkout de CI no tenía rama principal local, el comando que busca la línea base falló, y el fallback del código tomó el texto de error como si fuera un commit id y leyó todos los conteos de línea base como cero. De cero a cualquier cosa es crecimiento, así que el check pasó. Un valor por defecto silencioso dentro de la herramienta hecha para atrapar silencios por defecto. La solución es igual que las otras dos: un test runner ausente es unmeasured, una línea base que no se puede resolver es unmeasured, y cinco tests unitarios lo mantienen ahí. Esa es la entrada 8.29, y es la razón por la que la línea de arriba dice que el audit no puede redondear hacia arriba en vez de que no lo hace.
Los cinco porqués: por qué "could not run" debe ser un estado publicado y no una ausencia
| # | ¿Por qué? | Porque | Evidencia |
|---|---|---|---|
| 1 | ¿Por qué una compuerta necesita un tercer estado? | Porque en una compuerta de dos estados, "no se ejecutó" y "no encontró nada" producen la misma salida, y el lector no puede distinguirlas. | Once de once briefs en el caso práctico fueron "unmeasured", leídos de los comentarios de PR el 2026-09-09; bajo un diseño de dos estados, los once habrían parecido limpios. Las dos primeras ejecuciones están en [17] |
| 2 | ¿Por qué eso es peor ahora que antes? | Porque la persona que lo habría notado cada vez mira menos: la cobertura cayó de 89 a 68 por ciento en el estudio empresarial, y la mayoría de los PR agénticos no reciben revisión humana. | [2, 3] |
| 3 | ¿Por qué el tercer estado debe publicarse y no solo quedar en un log? | Porque un estado que solo vive en un log es un estado que nadie lee en el momento de decidir el merge; el telar se detiene en el piso, no en el libro de cuentas. | La detención del telar de 1896 es la detección [5]; el incidente del rojo invisible mostró un fallo que existía en el run log y en ningún lugar donde se tomaba la decisión de merge |
| 4 | ¿Por qué nunca debe contar como pass? | Porque una causa asignable que se clasifica como azar nunca podrá encontrarse ni eliminarse; la loop audit que redondea "unmeasured" a "pass" reportaría un ciclo saludable que en realidad nunca ha corrido. | El postulado de Shewhart [10]; la loop audit mantiene "AI has measured a PR" como unmeasured a propósito |
| 5 | ¿Por qué el reloj de respuesta va en este mismo episodio? | Porque un PR sin respuesta es la versión humana del silencio, y tanto la regla de un día hábil de Google como la cuerda andon dicen lo mismo: el derecho a detener la línea solo es real si alguien la activa todos los días. | [13, 11]; la primera ejecución etiquetó tres PRs a las cincuenta y siete horas |
La raíz, en una frase:que una compuerta no haya podido ejecutarse ya es una medición, y una medición que no se publica donde se toma la decisión de merge es como si nunca se hubiera hecho.
Hazlo en 30 minutos: el contrato que nunca se queda callado
Treinta minutos es el presupuesto del contrato para quien lo copie; no es un tiempo que yo haya cronometrado. El tercer estado requirió una rama en el revisor y una prueba; el bot de respuesta tomó una mañana; los tres incidentes, una tarde cada uno.
| Elemento | Especificación |
|---|---|
| Tres estados | Cada juicio automatizado devuelve pass, fail o unmeasured, y cada estado tiene una salida publicada en el pull request. Unmeasured lleva el motivo textual (credencial faltante, 401, rechazo, fallo de parseo, sin entrada para este tipo de evento) y la frase de que no es un pass. |
| Las listas vacías deben llevar motivo | Una sección vacía porque no hay nada que reportar debe explicar por qué; una sección vacía sin motivo es indistinguible de una sección que nunca se calculó. |
| Entradas según el tipo de evento | Si la entrada de una compuerta varía según el tipo de evento (un cuerpo de PR existe en eventos pull-request y no en push), "entrada no disponible" es unmeasured, nunca fail ni pass. |
| Reloj de respuesta | Un clasificador puro sobre (PR, ahora, política) con estados ok · needs-first-response · overdue-decision · exempt · draft. La política es datos: horas hasta la primera respuesta, días hasta decisión, lista de mantenedores, marcadores de comentario ignorados, exenciones con motivo escrito. Un cron en el scheduler de la plataforma. Dos etiquetas, un dashboard sobrescrito encontrado por título. |
| Regla de dos mitades | Si el contrato del bot tiene dos salidas (etiquetas y dashboard), entregar una y no la otra es un fallo que nombra la mitad faltante, no un éxito. |
| Regla de merge | Haz merge según la conclusión del workflow run para la rama, nunca según la lista de checks. Una ejecución con cero jobs y nombre de archivo es un fallo de parseo y es roja. |
| Prueba de guardia | Una prueba que falla si algún archivo de workflow contiene una expresión vacía, y otra que falla si un script de gate no tiene una auto-prueba (episodio 5). |
| Ausencias deliberadas | Sin reintentos en unmeasured; sin escalamiento más allá de la etiqueta y el dashboard; sin alertas. Cada uno agregaría un camino que también puede fallar en silencio. |
# The classifier is the whole bot; everything else is plumbing.
def classify(pr, now, policy):
    if str(pr.number) in policy["exempt"]:     return "exempt"      # with a written reason
    if pr.is_draft:                             return "draft"
    responses = [t for who, t, body in pr.activities
                 if who in policy["maintainers"] and who != pr.author
                 and not any(m in body for m in policy["ignore_comment_markers"])]
    if not responses:
        return "needs-first-response" if age_h(pr, now) > policy["first_response_h"] else "ok"
    return "overdue-decision" if age_h(pr, now) > policy["decision_days"] * 24 else "ok"

# The merge rule, as a command (the checks list cannot show a parse failure):
# gh run list --workflow ci.yml --branch <branch> --json conclusion   →  merge only on "success"
La misma historia, cinco perspectivas
| Lector | La decisión clave | La acción clave |
|---|---|---|
| Estudiante | "No se quejó" no es lo mismo que "lo revisó". | Identifica una verificación automatizada en la que confíes y haz que imprima algo cuando no pueda ejecutarse. |
| Ingeniero | Tres estados, todos publicados. | Agrega una rama "unmeasured" a tu revisor y una prueba que fije exactamente su redacción. |
| Fundador | Un reloj de respuesta es un archivo de política y un cron en la plataforma, no una persona. | Escribe los dos números (horas hasta la primera respuesta, días hasta la decisión) y la lista de exenciones, y deja que la plataforma lo ejecute. |
| Ejecutivo | La falla que no puedes ver es la que más cuesta. | Pregunta en qué se basa tu decisión de merge y si esa superficie puede mostrar un workflow que nunca se inició. |
| Inversionista | El telar que se detiene solo vale más que el telar que teje más rápido. | Pide a un equipo que te muestre una gate reportando "could not run", en un PR real. |
Patrones, anti-patrones y el primer principio
Patrones que se conservaron. Tres estados, cada uno con una salida publicada. Las listas vacías siempre explican el motivo. Entradas diferenciadas según el tipo de evento. Un clasificador que es función pura sobre un archivo de política. Un dashboard que se sobreescribe cada vez. Una validación inversa antes de lanzar el bot en producción. La regla de las dos mitades.
Antipatrones que esto reemplazó. Un revisor cuya ruta de clave faltante solo mostraba los machine gates y parecía una revisión limpia. Un nivel de servicio que quedó en una propuesta durante una semana mientras tres PRs seguían esperando. Una decisión de merge basada en una lista que no puede mostrar el fallo relevante. Una compuerta que interpretaba una entrada faltante como si fuera una entrada fallida.
El mecanismo, explicado. Cada camino de código en el revisor y el bot termina en una publicación; la ausencia es estructuralmente imposible, así que la única forma de quedarse en silencio es que la propia plataforma falle antes de que el código se ejecute, que es justo el caso que cubre la merge rule.
El primer principio, en una frase. Un juicio que no pudo hacerse es un hecho sobre el sistema y debe registrarse donde se toma la siguiente decisión; el silencio no es un estado, es la ausencia de uno.
Compromiso con la realidad
El episodio 1 prometió que para el episodio 2 el bot de respuesta habría corrido sobre los tres PRs que llevaban cincuenta y siete horas. Así fue: llevan la etiqueta, el dashboard los lista y la corrida que creó el dashboard está registrada en el dossier con su número. Para el episodio 3, el loop audit que detectó el rojo invisible se habrá vuelto a ejecutar sobre una main branch en verde y su informe será registrado, y los tres PRs de cofundadores tendrán ya una primera respuesta o el dashboard seguirá diciendo que no.
Lee también
Episodio 2 de ANDON · Agentic PR Review and CI/CD. Cada número está acotado donde aparece; la cocina es un modelo, no una medición. El revisor, el bot de respuesta, el loop audit y los tres incidentes aquí descritos existen en un repositorio privado; las formas se reproducen en el contrato para que nada dependa de tener acceso a él. El dossier de cuatro horizontes citado en este episodio está registrado en el directorio de planes del portafolio.
Referencias
- GitHub, How pull request limits are cutting down the noise, 2026-06-18. github.blog
- He, Agarwal, Denisov-Blanch, Azaletskiy, Koyejo, Vasilescu, AI Writes Faster Than Humans Can Review: A Longitudinal Study of an Enterprise 2x Mandate, arXiv:2607.01904, 2026-07-02. arxiv.org
- Duma et al., These Aren't the Reviews You're Looking For, arXiv:2605.02273, 2026-05-04. arxiv.org
- Peralta et al., Why Are Agentic PRs Merged or Rejected?, arXiv:2605.22534, 2026-05-21. arxiv.org
- Toyota Motor Corporation, Toyota Production System. global.toyota
- Toyota Industries Corporation, Sakichi Toyoda. toyota-industries.com
- Toyota Motor Corporation, 75 Years of Toyota, Type G. toyota-global.com
- Autonomation, Wikipedia, citando a Ohno 1988, pp. 6, 58. en.wikipedia.org (secundario; no se obtuvo el libro de Ohno)
- Best, Neuhauser, Walter A Shewhart, 1924, y la fábrica Hawthorne, Quality & Safety in Health Care, 2006. pmc.ncbi.nlm.nih.gov
- Shewhart, Economic Control of Quality of Manufactured Product, Van Nostrand, 1931, Postulate 3 (archive.org scan). archive.org
- Toyota UK, TMUK's 25 Objects – Andon Cord, 2017-12-11. mag.toyota.co.uk
- Rigby, Bird, Convergent Contemporary Software Peer Review Practices, ESEC/FSE 2013. users.encs.concordia.ca (copia del autor, citas verificadas; el mirror de Microsoft Research rechaza descargas automáticas)
- Google Engineering Practices, Speed of Code Reviews. google.github.io
- Sadowski, Söderberg, Church, Sipko, Bacchelli, Modern Code Review: A Case Study at Google, ICSE-SEIP 2018, copia del autor. sback.it
- Anthropic, Code Review, documentación de Claude Code. code.claude.com
- Cursor, Bugbot documentación. cursor.com
- Paul Jialiang Wu, AI PR Review That Cannot Lie, 2026-09-08 (el diseño del reviewer y sus dos primeras ejecuciones). futuremake.io