AI-Native 系列 · 智能体工程全对比:提示 · 上下文 · Harness · 循环 · 图
Harness 工程是 envelope,不是智能体本身
第 3/6 集。本系列对比了工程师打造 AI 智能体的五种方式——提示、上下文、harness、循环和图工程:每种方法的起源、可控对象、主导者,以及哪些原则经得起测量。这一集是智能体“停嘴动手”的那一级台阶。
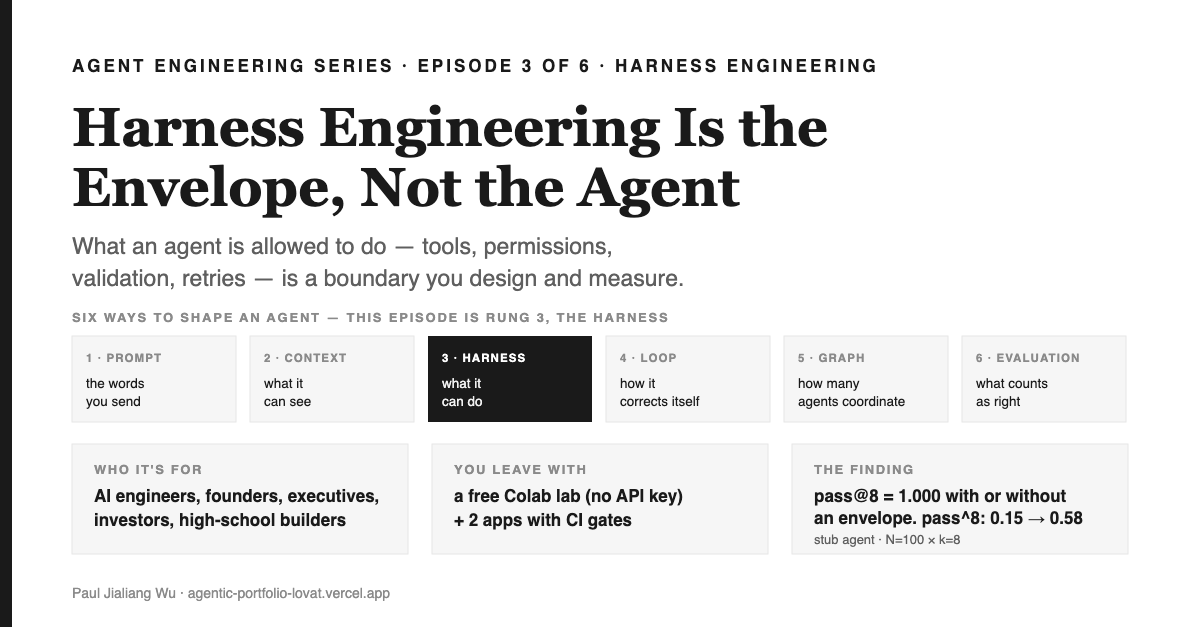
1 分钟速览 —— 你将带走什么
这是什么。 一套对比 AI 智能体工程方法的系列——提示工程(你发出的词)、上下文工程(它能看到什么)、 harness 工程(它能做什么),循环工程(怎么自我修正),图工程(多个智能体如何协作)。本集聚焦 harness 工程:从 2022 年的 ReAct 到 Model Context Protocol 及其后续,谁在推动它,以及哪些原则经得起实际测量。
为什么重要? 一个有工具的智能体可以花钱、删文件、给客户发邮件、改账本。harness——允许列表、dry-run、校验、重试预算、kill switch——是唯一决定它到底能做哪些事的东西,而你仪表盘上的基准分数大概率看不出它到底有没有生效。我自己跑下来,pass@8 在执行了 73 次被禁止的工具调用 的配置下依然是 1.000(桩智能体,N=100 个种子任务,每个 k=8 次尝试)。对创始人来说,这就是 demo 和能放着跑的产品之间的差距;对工程师来说,就是一个下午和一行 CI gate。
读完你能做什么? 明确画出你智能体的 envelope,用 pass^k 替代 pass@k,数清楚有哪些动作跑出了 envelope。你会拿到一个免费的 Colab 笔记本(不用 API key),还有两个从零写的应用:一个家用文件整理器,envelope 把 974 个被删文件全变成了 974 次拒绝;一个财务对账台,CI gate 在 envelope 被移除时直接退出 1——而且它还用失败教会了我,三个安全装置里有一个根本没被测过。
Season 7 — 系列脉络
- 提示工程——规范,不是咒语 第 1 集
- 上下文工程——预算,不是更大的窗口 第 2 集
- harness 工程——是 envelope,不是 agent 本集
- 循环工程——是外部裁判,不是重试 第 4 集
- 图工程——是排班表,不是人设演员表 第 5 集
- 评估工程——这是真值函数,不是排行榜 第 6 集
本集讲什么,以及为什么 harness 工程排在第三
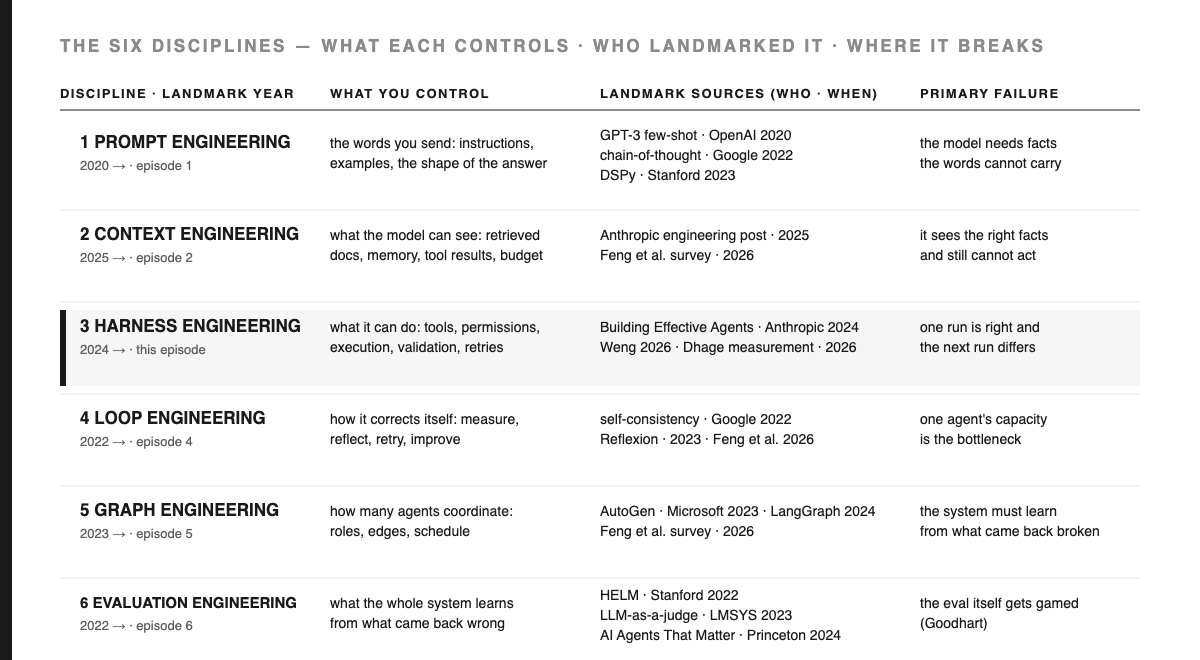
本系列每集聚焦一种智能体工程方法,顺序基于每种方法让你能掌控什么:prompt → context → harness → loop → graph → evaluation。前五项在 Feng 等人的综述(arXiv:2608.21156)中均有命名——prompt、context、harness、loop、graph。第六项 evaluation engineering 是本系列自创。每一阶都回答同样四个问题:起源、具体可控对象、主导者是谁、哪种失败会把你推向下一阶。
harness 工程是第三阶,这里风险的本质发生了变化。前两阶,智能体误解你,顶多写错一句话。到第三阶,智能体会做出错误的操作:比如删了文件、重复付款、邮件已经发出。所有后果都源于这种不对称。句子可以丢弃,操作无法撤回。
适合谁看。 适合:正准备让智能体获得关键写入权限的 AI 工程师;刚被试点客户问“演示错了会怎样”的创始人;要为一个自主系统签字却还不知道该问什么的高管;以及好奇“给 AI 加工具”为什么是门工程学科的高中生。唯一的前置条件:你见过模型实际调用过一次函数。
harness 工程的起源与主导者
[定义] A harness,指的是包裹在模型外、负责调度的代码:它规定模型能调用哪些工具、能传递哪些参数、操作提交前发生什么、失败时如何处理、整个流程何时终止。Lilian Weng,三年前写了第一阶的权威综述、今年七月又写了本阶的权威文章,直接下了定义:"A harness is the system surrounding a base model that orchestrates execution and decides how the model thinks and plans, calls tools and acts, perceives and manages context, stores artifacts, and evaluates results."(中译:harness 是包围基础模型的系统,负责编排执行,决定模型如何思考和规划、调用工具和行动、感知和管理上下文、存储产物并评估结果。)
本集的论点就围绕这个定义里的一个词——decides——以及如果你把它当真,会发生什么。历史的演变,就是业界如何从“模型能不能用工具”走到“哪些工具、什么条件、怎么校验”。
| 时间点 | 里程碑 | 主导者 | 改变了什么 |
|---|---|---|---|
| 2022-10 | ReAct:让语言模型推理与行动协同 (arXiv:2210.03629) | Yao 等人,Princeton 与 Google Research | 将推理轨迹与行动交错执行,因此,"reasoning traces help the model induce, track, and update action plans as well as handle exceptions, while actions allow it to interface with external sources…"(中译:推理轨迹帮助模型归纳、跟踪并更新行动计划,同时处理异常,而行动则让模型能够与外部资源交互……)。这是每个智能体框架至今仍在运行的循环。 |
| 2023-02 | Toolformer (arXiv:2302.04761) | Schick 等人,Meta AI | "a model trained to decide which APIs to call, when to call them, what arguments to pass, and how to best incorporate the results into future token prediction"(中译:一个被训练用来决定调用哪些 API、何时调用、传递哪些参数,以及如何将结果最佳地融入后续 token 预测的模型)。工具使用从提示工程小技巧变成了可训练的能力。 |
| 2023-05 | Gorilla (arXiv:2305.15334) | Patil 等人,UC Berkeley | API 调用扩展到真实注册表的规模,并首次严肃讨论了catalogue问题:"When combined with a document retriever, Gorilla demonstrates a strong capability to adapt to test-time document changes, enabling flexible user updates or version changes."(中译:与文档检索器结合后,Gorilla 展现出强大的能力,能够适应测试时文档的变化,从而支持灵活的用户更新或版本切换。) |
| 2023-06 | API 中的函数调用 | OpenAI | 工具调用不再是从文本中解析出来的内容,而是协议中的一个类型化字段。harness 工程获得了 schema。 |
| 2024-05 | SWE-agent:Agent-Computer Interfaces Enable Automated Software Engineering (arXiv:2405.15793) | Yang 等人,Princeton | 本期的核心结果:模型保持不变,只改动 接口,分数就会变化。首次提出 agent-computer interface(ACI,智能体-计算机接口)这一概念。 |
| 2024-06 | τ-bench (arXiv:2406.12045) | Yao 等,Sierra | 首次引入了 pass^k。将一个智能体测 8 次并要求 8 次全通过,和测 8 次只取最好那次,原来是两种完全不同的评测方式。pass^k |
| 2024-11 | Model Context Protocol | Anthropic | 官方公告这样描述:"an open standard that enables developers to build secure, two-way connections between their data sources and AI-powered tools"(中译:一个开放标准,让开发者能在数据源与 AI 工具之间建立安全的双向连接)。harness 工程的工具层因此可以在不同厂商之间迁移。 |
| 2024-12 | Building Effective Agents | Anthropic(Erik Schluntz、Barry Zhang) | 本层的实操圣经,也是那句人人引用的金句:agent-computer interface 要投入和人机界面同等的精力。 |
| 2026-07 | Harness Engineering for Self-Improvement | Lilian Weng | 首次明确提出 harness 工程这一分支,并给出上文引用的定义。一位作者,三层阶梯,三年跨度。 |
| 2026-08 | 这套阶梯(arXiv:2608.21156)和确定性研究(arXiv:2608.26197) | Feng 等;Dhage | harness 工程被正式确立为第三阶,并且被实际测量过——结果却让所有人都不满意。 |
[DESIGN] 这条演进路线 从能力走向约束:2022 和 2023 年还在问“能不能用工具”,2024 年起则变成“具体能用哪些工具、怎么校验、出错时如何处理”。标准先于测量诞生——MCP 在 2024 年 11 月发布;而第一次严肃公开测量 harness 工程是否真的让智能体更可靠,是在 2026 年 8 月。
现在是谁在推动这条路。 模型实验室掌控着协议层和实操规范——Anthropic 的 Building Effective Agents 和 MCP,OpenAI 的函数调用 schema。编码型智能体产品(Claude Code、Codex)把设计推到极致:一个 coding agent 是“harness 工程包裹着模型”,而不是反过来。学界则主导测量——ACI 结果归 Princeton,Sierra 负责 pass^k.
心智模型:餐厅厨房
一张图串起六集,用工具视角而不是讲故事。每个厨师都要爬同一架梯子——先为自己做饭,再为家人、再到餐厅厨房、再到快餐连锁、再到全国供应链;工程师也一样:学生、初级开发、资深开发、AI 技术负责人、CTO、前沿领军者。agent 工程的每一阶,就是这梯子上的一间厨房。
第一阶是递给你、但你无法交流的菜谱卡。第二阶是他们用的储藏室。第三阶就是厨房本身——里面有三样东西。这个厨师可以在哪些 工位 工作。哪些 工具触手可及,哪些放在抽屉里,哪些锁在办公室。还有 出菜口:每道菜都要经过的台面,由不是厨师的人检查,才能上桌。
资深开发的职责不是比初级更会做菜,而是设计一个厨房,让一个合格的陌生人能安全顶班,不会把厨房点着;而且错的菜能在出菜口被拦下,而不是等到上桌才发现——这是为一个你没亲自培训、也无法全程监督的工人,划定的控制封套。这就是 harness 工程的全部。
| 阶梯 | 厨房 | 你的角色 | 你能塑造的内容 |
|---|---|---|---|
| 1. 提示 | 菜谱卡——自己做饭 | 在校学习者 | 厨师手中的书面指令 |
| 2. 上下文 | 储藏室——为家人做饭 | 初级开发者 | 做菜时台面和冰箱里能用的所有东西 |
| 3. harness 工程 | 餐厅厨房 | 高级开发者 | 工位、触手可及的工具、每道菜都要经过的 pass 检查台 |
| 4. 循环工程 | 快餐连锁 | AI 技术负责人 | 品尝、测量、修正、让每家门店都用上修正 |
| 5. 图工程 | 全国供应链 | CTO | 多家厨房、一套排班表、一支运输车队 |
| 6. 评估工程 | 召回日志 | 前沿领军者 | 整个食品系统会从那些被退回的菜品中学到什么 |
这不是单一维度,而是两条轴线。 这不是一架你爬完就丢下的梯子:每个厨房始终同时拥有六个层级。家里的厨师有菜谱、有储藏室、有灶台、有味觉、有供应商,还有对上次哪里出错的记忆。你往上走,变化的是你能掌控多少层,以及你对每一层的把控有多严谨——先凭感觉,再量化,再加 gate,最后自我纠正。一家全国连锁如果只有漂亮的供应链图,却没人把关出菜,成熟度还不如那家每盘必检的小餐馆。所以这六门学问是分层(不同类型的对象:规范、状态、控制封套、控制流、结构拓扑、真值函数);资历代表成熟度。Graph 并不天然比 loop 更高级。
这个类比可以用来引入观点,但永远不能作为论据。下面的 1:1 映射里,每个元素都精确对应代码中的某一物件。
观点分级如下
[定义] harness 是一个控制封套:系统能执行哪些操作,以及每个操作在什么条件下才算合法。不是框架,不是包装器——是你亲手画下的边界,智能体的行为只能在里面活动。
[证据] 把控制封套当作设计界面而不是底层管道的理由,是有人把模型锁死,只改了接口。Yang 等人的 SWE-agent(arXiv:2405.15793,2024-05-06)从一个说出来很显然、但之前没人说过的观察出发:"we posit that LM agents represent a new category of end users with their own needs and abilities, and would benefit from specially-built interfaces to the software they use."(中译:我们认为,语言模型智能体代表了一类全新的终端用户,他们有自己的需求和能力,因此需要专门为其定制的软件接口。) 结果是:"SWE-agent's custom agent-computer interface (ACI) significantly enhances an agent's ability to create and edit code files, navigate entire repositories, and execute tests and other programs"(中译:SWE-agent 的定制 agent-computer interface(ACI)显著提升了智能体创建和编辑代码文件、浏览整个代码仓库、执行测试和其他程序的能力),在 SWE-bench 上的 pass@1 达到 12.5%,是当时的 SOTA,这一成绩完全来自于重构工具接口本身,而非更换模型。
Anthropic 的Building Effective Agents(2024-12-19)把同样的发现总结成了一条经验法则:"One rule of thumb is to think about how much effort goes into human-computer interfaces (HCI), and plan to invest just as much effort in creating good agent-computer interfaces (ACI)."(中译:有个经验法则是,设计 agent-computer interface(ACI)时,应该投入和人机界面(HCI)同等的精力。) 他们提出的三条智能体原则中,这条排在第三位,也是最后一条,仅次于简洁性和透明性:"Carefully craft your agent-computer interface (ACI) through thorough tool documentation and testing"(中译:通过完善的工具文档和测试,精心打磨你的 agent-computer interface(ACI)).
[EVIDENCE] 所以接口确实重要。但 envelope(控制封套)真的能让智能体可靠吗?Dhage 的研究(arXiv:2608.26197,2026-08-25)就是专门为此而做的——一个带有限状态控制、强制工具选择、输出验证和有界重试的确定性执行层,两个合成任务、两个开源模型、四个实验单元。第一轮实验结果是:harness 工程在自己定义的标准下“翻车”了——"significantly improves reproducibility in one of four model-task cells, significantly degrades it in two, and has no effect in the fourth."(中译:在四个模型-任务单元中,harness 显著提升了其中一个的可复现性,显著降低了两个,剩下一个没有影响。)
四个单元里有两个变得更糟。护栏加上了,仪表盘却报警了。追溯诊断发现,问题其实出在上一层——有一步自由文本规划没有约束。加上约束后,四个单元里有三个在 N=100 时达到了 1.000。结尾那句话,写的人刚刚被本层打脸:harness 工程确实是一门学问,"but its cost is model-dependent and must be measured, not assumed."(中译:但它的代价依赖于模型,必须实际测量,不能想当然。)
[DESIGN] 要特别注意到底是哪里分化了,因为这个数字最容易被误传。论文原文:"token cost falls in every cell, but latency shows a genuine, sample-size-robust split by model -- one becomes faster under the constraint, the other markedly slower."(中译:token 成本在所有单元都下降了,但延迟在不同模型间出现了真实且样本量稳健的分化——有的模型加约束后更快,有的明显变慢。) token 成本下降 在所有配置下都是如此。延迟 才是按模型分化的指标。控制封套(envelope)并不一定昂贵;它的代价是不可预测的,方向也不是你能从架构图上看出来的。
[DERIVATION] 把这两点放在一起,就是本集的核心观点。接口决定了智能体能实现什么(SWE-agent);控制封套并不能可靠地改变它一致性 地实现这些(Dhage)。这两个属性常被混为一谈,因为几乎所有人报告的那个指标根本分不清它们。
[DEF] 这就引出了本集要区分的两个词,而且它们绝不是拼写错误。
pass@k——在k次尝试中,是否有 至少一次 成功?这是基准测试报告的内容。用户可以重试、能分辨好坏答案时,这个指标才合适。pass^k——在k次尝试中,是否全部 k 成功?这是 τ-bench 的指标,也是客户实际体验到的,因为客户只会拿到一次运行结果,而且不知道是哪一次。
[EVIDENCE] Yao 等人在同一句话里报告了这个差距:"We also propose a new metric (pass^k) to evaluate the reliability of agent behavior over multiple trials. Our experiments show that even state-of-the-art function calling agents (like gpt-4o) succeed on <50% of the tasks, and are quite inconsistent (pass^8 <25% in retail)."(中译:我们还提出了一个新指标(pass^k),用于评估智能体在多次试验中的行为可靠性。我们的实验显示,即使是最先进的函数调用智能体(如 gpt-4o),在不到 50% 的任务上能成功,而且表现非常不稳定(在零售场景下 pass^8 小于 25%)。) 一个前沿的工具调用智能体,能解出的任务还不到一半——而且连续八次都成功的比例还不到四分之一。连续八次都成功.
1:1 技术映射
厨房里的每个元素,都能在代码里找到一一对应的实现。比喻可以用来引入观点,但永远不能作为证据——这里只做一一对应的翻译,不加修饰。
| 厨房 | 系统 | 所在位置 |
|---|---|---|
| 这位厨师可以在哪些工位工作 | 工具允许列表 | ALLOW = {"mkdir","move","log"} —— 派发前的集合成员检测 |
| 锁在办公室的刀 | 未授权的动词 | UNGRANTED = {"wire_transfer","close_period",…} —— 被拒绝、记录,永不派发 |
| 酱汁上桌前先尝一口 | dry-run(空跑) | dry_run(verb, src, dst) —— 返回 (ok, reason),不触碰任何东西 |
| pass(出菜口)—— 每道菜离开前的校验 | 输出校验 | —— 工具上的 schema 校验 结果,在调用方看到之前 |
| 重做被 pass 拒绝的那盘菜 | 有界重试 | for _ in range(retries + 1) —— 是预算,不是循环 |
| 忙碌夜晚重复写同一张票 | 重复的副作用 | 幂等性 key:sha256(line_id|ledger_id|cents) |
| 主厨一键停业 | kill switch | MAX_ADJUSTMENTS_PER_RUN,以及 blast-radius cap(爆炸半径上限) |
| 扔掉一道坏菜 | 可逆操作 | undo log——undo.jsonl,按相反顺序回放 |
| 扔掉一个坏原料 | 一次不可逆操作 | undo log 对此无能为力,只有 allow-list 能兜底 |
| “我们服务了 200 桌,所以没问题” | pass@k | 至少有一次k尝试成功 |
| “今晚没有一道坏菜端上桌” | pass^k | 所有k次尝试都成功 |
预测 gate
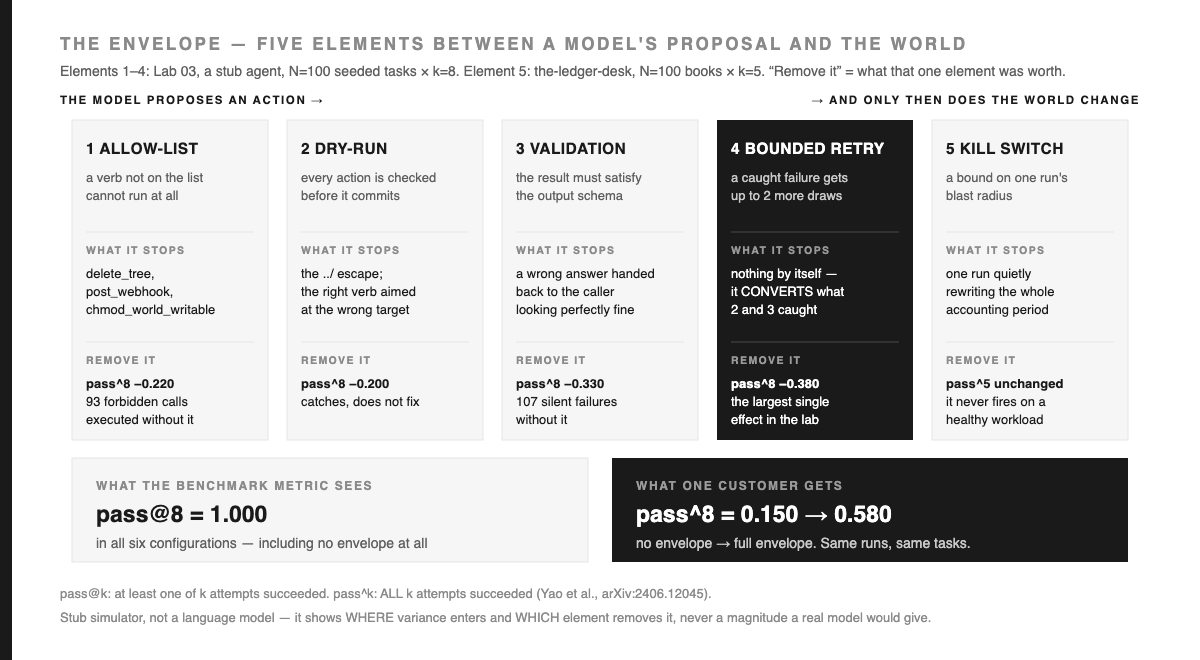
别急着往下翻——没写下的预测,你总会觉得自己猜对了。一个用工具的智能体有四个 envelope 元素:allow-list、dry-run、输出校验、两次有界重试。你跑 100 个任务,每个任务尝试 8 次,每次只移除一个元素。
Q1.如果完全没有 envelope——没有 allow-list、没有 dry-run、没有校验、没有重试——那么pass@8会是多少?
Q2.请按移除每个要素带来的代价高低,对这四个 envelope 元素排序,pass^8最先写出影响最大的那一个。
Q3.你给一个没有 allow-list、没有 dry-run、没有 validation 的桩智能体加上一个有界重试(最多两次)——唯一变化就是加了重试。实际执行的被禁止工具调用次数会减少、不变,还是增加?
答案见 Notebook 和 Failure Room。
Notebook
Lab 03 —— envelope 实验:pass^k在 harness 工程下。 
03_envelope_passk.ipynb· Colab 免费版 ·无需 API key· ~5 秒 CPU · 所有 cell 均在发布前实际运行。源码及下方两个项目:gist.github.com/wjlgatech/218a4a45…
共八个 cell。worker 是一个带种子的桩智能体,每次抽样有三种独立风险——一个超出 allow-list 的工具、一个允许工具但目标错误、一个输出 schema 校验失败的结果——每项风险都按任务难度缩放,因为任务集均匀时,pass^k的衰减会很规整p**k,而不是像 τ-bench 那样直接塌缩。
[EVIDENCE]本次消融实验,N=100 个任务,k 最多 8,每个配置在 cell 3 打印:
envelope                  pass@1  pass@8   pass^1  pass^5  pass^8   out-of-env  silent
none — no envelope         0.640   1.000    0.640   0.240   0.150        73       87
full minus allow-list      0.820   1.000    0.820   0.500   0.360        93        0
full minus dry-run         0.850   1.000    0.850   0.560   0.380         0        0
full minus validation      0.820   1.000    0.820   0.410   0.250         0      107
full minus retry           0.740   1.000    0.740   0.340   0.200         0        0
full envelope              0.950   1.000    0.950   0.770   0.580         0        0
Q1 答案:1.000。每个配置都是如此。包括那个实际执行了73 次被禁止的工具调用并且交回了87 个伪装成正确答案的错误结果。按pass@8评分,实验室里最危险的桩智能体反而成了优等生。
这一行就是本集的核心论点。pass@k 会饱和,因为这正是它的职责:它只衡量能力是否存在,从未声称自己是可靠性指标。pass^8 能把同样的六种配置区分开,区间跨度达到0.430,且是在完全相同的实验下。
[证据] Q2 的答案,来自第 5 格:重试(−0.380)、校验(−0.330)、allow-list(−0.220)、dry-run(−0.200)。重试排在第一,这点我没料到。四个要素里有三个是检测器——allow-list、dry-run 和校验都会发现问题并拒绝——只有重试能把检测转化为一次成功。没有重试预算的检测器,就像一台连到日记本上的烟雾报警器:实话实说,写得很详细,但没人能采取行动。
但这并不意味着重试才是最重要的。移除它会损失 0.380 的pass^8,但安全性为零;移除 allow-list 则损失 0.220,并且有93 次被执行的未授权调用。损失的类型不同,没有哪个单一的排名数字能说明全部。
[证据] Q3 的答案:不变——而原因正是关键。 表格显示,none有 73 次越界执行,full minus allow-list有 93 次,很容易把这归因于重试。但这两行其实差了三个开关。第 7 格是一项项单独切换,allow-list 始终关闭:
configuration                        pass@1   pass^8   out-of-env   silent
none                                  0.640    0.150           73       87
+ dry-run                             0.640    0.150           74       85
+ validation                          0.640    0.150           74        0
+ bounded retry (= no allow-list)     0.820    0.360           93        0
none + bounded retry ONLY 0.640 0.150 73 87单独加重试,什么都不会发生。73 → 73,pass@1也没有任何变化。没有 dry-run 和校验,什么都不会被捕获,所以循环根本不会执行。没有检测器在前,重试预算就是死代码——这和“4 个元素里有 3 个是检测器”其实是同一回事,只不过是从反方向得出的结论,直接推翻了我本来想讲的那个顺滑故事。
[推导] containment 的代价是真实存在的,而且属于 这一对组合:在两个检测器的基础上再加上重试,out-of-envelope 的执行次数从 74 → 93,多了 19 次,增加了 25.7%。检测器让重试真正触发;每多一次抽签,就是又去试一次锁着的抽屉。所以结论不是“重试有害”——而是 检测和重试是一组,组合后会把尝试次数放大。 没有 allow-list 就上线,其实是用 containment 换来了 reliability,只不过这一切都藏在一次提交里,悄无声息。
[证据] 第 6 格,全面扫描,因为单次读数不算测量。保持 envelope 不变,调节 worker 的噪声水平:
| 噪声 | pass@1 | pass@8 | pass^5 | pass^8 | gap@8 |
|---|---|---|---|---|---|
| 0.25 | 0.990 | 1.000 | 0.950 | 0.940 | 0.060 |
| 0.50 | 0.990 | 1.000 | 0.890 | 0.850 | 0.150 |
| 1.00 | 0.950 | 1.000 | 0.770 | 0.580 | 0.420 |
| 1.50 | 0.900 | 1.000 | 0.610 | 0.420 | 0.580 |
| 2.00 | 0.800 | 1.000 | 0.440 | 0.310 | 0.690 |
pass@8 在所有噪声水平下都是 1.000——worker 行为再怎么离谱,数值都一条直线——而 pass^8 则从 0.940 掉到 0.310。一个 pass@k 数字不是质量报告;它只是带着百分号的烟雾测试。
[设计] 为什么用桩智能体而不是 live model?模拟器可以复现 哪些地方 行为越出 envelope,以及 哪个元素把它们拉回来——几秒钟内,免费、无需密钥,每个风险率都能在第1格手动设置,你可以随意调整。它不会还原量级。它输出的任何数字都不能作为 τ-bench 的pass^8 <25%或 Dhage 在 N=100 时的 1.000 的证据。最后一格就是桥梁:把某个函数换成真实的工具调用循环,测量代码完全不用动,因为pass_at_k和pass_pow_k都不知道布尔值是怎么来的。
失效室
故意把它搞坏。一个你搞不坏的机制,只能叫主张,不叫机制。
失效1——envelope 只让它安全,不让它变好。见下方 Project 1:envelope 把安全 pass^5从 0.000 拉到 1.000,但把完整 pass^5留在 0.000 原地。一个平庸工人外面套个完美 envelope,你得到的就是一个不会伤人的平庸工人。值得有,但和好 agent 不是一回事——每个把权限图当作质量证据的 PPT 都在犯这个等价替换。
失效2——无法撤销的 undo log。可逆性是动词的属性,不是 undo log 的属性。我的文件整理器会把每次 commit 的操作写进undo.jsonl,然后反向 replay——只要 agent 没有删东西,这就是一套完整的安全故事。把 envelope 关掉跑一遍 demo:readings.csv,我自己的桩智能体判定为垃圾的那个文件,直接消失了,undo replay 乖乖反演了十四步,什么也没恢复。allow-list 保护不可逆动词,undo log 保护可逆的。只做后者,是这个错误的典型形态。
失效3——检测器+重试预算组合把 blast radius 放大。Q3 的通用规则:任何会放大尝试次数的东西,都必须包在能限制它的 envelope 元素里面。单独的重试预算不会放大任何东西;只有检测器+重试预算,才会把一次抽签变成三次。没有 allow-list 在前面,这对组合就多放大了 19 次违规执行。修正方法是调整顺序,不是减少重试。
失效4——永远不会被测到的安全装置。我的企业版有三个 envelope 元素,还有一个make gate-brokentarget,每次移除一个元素就断言 gate 应该退出为 1。有两个没过 gate,kill switch 没有——因为在健康负载下它从未触发,因此没有任何通过率指标能观测到它。我写了一个永远不会失败的测试,打印出绿色对勾,差点就直接上线。修正方法已经在仓库里:注入 kill switch 负责的故障,并用爆炸半径做 gate。一个测试永远不会失败的安全装置,其实你根本没测过。
失效案例 5 ——pass@k 被当作可靠性来报告。 请把它和 pass^k 以及 out-of-envelope 数一起报告,否则就别报。
项目
两个完全从零搭建的小应用。不用任何框架,只用标准库,都是在本节写作前实际跑过的,每个数字都是真实测量。代码和 同一个公开 gist 里,和 notebook 放一起。
项目 1 —— 真实生活:the-desk-tidy
desk_tidy.py · python3 measure.py
一个把杂乱文件夹按类别整理的文件管理器,包在最小的 envelope 里,保证可以无人值守地安全运行:只允许三个动词(mkdir, move, log),每次移动前 dry-run 检查目标路径是否在文件夹内,还有一份 undo log。没人会给自己的 Downloads 文件夹写权限策略,这正是你该在这里体会 envelope 能带来什么的原因。
[EVIDENCE] N=100 个桌面 × k=5 次独立试验 = 每种配置 500 次运行:
                             ENVELOPE ON  ENVELOPE OFF
pass@5  (safe)                     1.000         0.480
pass^5  (safe)                     1.000         0.000
pass@5  (complete)                 0.480         0.480
pass^5  (complete)                 0.000         0.000
out-of-envelope deletes                0           625
actions refused                      974             0
writes outside the root                0           349
files lost (= both) 0 974两条标准,故意分开算。SAFE:没有任何文件被破坏,没有任何内容写到文件夹外。COMPLETE:每个文件都被分到了正确的类别。
[DERIVATION] 625 次破坏性调用加上 349 次逃逸——代码分开计数,因为只有前者真的删了文件,虽然两者都在 envelope 之外——envelope 关掉时丢了 974 个文件,对比 envelope 打开时 974 次操作被拒绝。数字一模一样。envelope 没让任何决策变好;它只是把每一次破坏性操作都变成了拒绝。这就是全部交换条件,也解释了为什么 complete 这一行始终没变:每一次拒绝的代价,就是有活没干完。readings.csv 还静静地躺在桌面上,没被归类。它依然是个文件。
项目 2 —— 企业场景:the-ledger-desk
ledger_desk.py · make gate · make gate-broken · make gate-killswitch
一个对账智能体:对银行流水和账本做自动核对,补齐差额。三项 envelope 元素,对应三项职责。工具权限 决定哪些动词可以被调用(wire_transfer, close_period 和 delete_entry 都不可用)。幂等性键 — sha256(line_id|ledger_id|cents) —— 是唯一让重试安全的机制。一个 kill switch 把每次运行限定在 12 次调整和 $250 之内。
[EVIDENCE] N=100 本账 × k=5 次运行 = 每行 500 次:
envelope                   pass@5   pass^5   out-of-env   dupes-land   kills
full envelope               1.000    1.000            0            0       0
minus permissions           0.960    0.080          324            0       0
minus idempotency           0.490    0.000            0          945     116
minus killswitch            1.000    1.000            0            0       0
no envelope                 0.340    0.000          324          982       0
make gate gate 正常退出为 0;移除权限后为 1;移除幂等性后为 1。
[EVIDENCE] 慢慢读 minus permissions 这一行。pass@5 = 0.960 —— 这是你敢签字的数字 —— 紧挨着 324 次未授权工具调用被执行,以及 pass^5 的 0.080。只看 pass@k,你完全看不到有智能体在五次运行中有四次都跑出了 envelope。
这一minus idempotency 这一行展示了一个单元素消融无法发现的交互:945 次重复调整被实际执行,kill switch 触发了 116 次。kill switch 在其他 envelope 元素都正常时是隐形的——只有当另一个环节失效时,它才是唯一能阻止某次异常工具调用导致整个会计周期被重写的防线。
[开放问题] 这也是为什么 minus killswitch 的读数和完整 envelope 完全一致,以及为什么这个项目让我重写了 Makefile。pass^k 在健康负载下,无法测试只会在异常情况下触发的安全装置。make gate-killswitch 正解是——注入故障(关闭幂等性、重试导致重复),并用 blast radius 作为 gate:
killswitch ON   : 116 trips · worst run 12 postings (cap 12) · 299 lines flagged → exit 0
killswitch OFF  :   0 trips · worst run 18 postings (cap 12) ·   0 lines flagged → exit 1
三项 envelope 元素中有两项由 pass^k gate 控制。第三项需要专门注入故障,而 pass^k 并不会告诉你这一点。
30 分钟造好——工程合同
envelope 需要的一切,按工程师实际提需求的顺序列全。输入: 一个待执行的 (verb, args). 输出: 一个 Result,或带原因的拒绝。不变式: 所有 gate 顺序通过前,绝不产生任何副作用。停止规则: 拒绝会升级到人工处理;retry budget 只会用在 被捕获的失败上,绝不会重试拒绝。
ALLOW     = {"read", "move", "log"}           # 1. the boundary. set membership.
UNGRANTED = {"delete", "wire_transfer"}       # exists in the world, not in the envelope

def act(verb, args, retries=2):
    if verb not in ALLOW:                     # 1. ALLOW-LIST — before anything else
        return refuse(verb, "not on the allow-list")
    for _ in range(retries + 1):              # 4. BOUNDED RETRY — a budget, not a loop
        ok, why = dry_run(verb, args)         # 2. DRY-RUN — nothing has touched disk
        if not ok:
            return refuse(verb, why)          #    a refusal is NOT retried
        key = idem_key(verb, args)            # 6. IDEMPOTENCY — same action, once
        if key in ledger:
            return ledger[key]
        if blast_radius() + cost(args) > CAP: # 5. KILL SWITCH — bound the run
            return halt_and_flag(verb, args)
        result = execute(verb, args)          #    the ONLY line with a side effect
        undo_log.append(inverse(verb, args))  # 7. UNDO — only helps reversible verbs
        if validate(result):                  # 3. VALIDATION — the pass
            ledger[key] = result
            return result
    return refuse(verb, "retry budget exhausted")

# CI gate (make gate): N=100 tasks x k=5 runs
#   pass^5                 >= 0.99
#   out_of_envelope_calls  == 0
#   blast radius under fault injection <= CAP
# any line below threshold -> exit 1 -> the build fails
[设计] 这四个属性让它是企业级 envelope,而不是个 demo,每一项都各有其必要性:
- 允许列表的检查必须放在重试循环之外,优先执行。 顺序就是设计:如果放在循环里,逻辑上也没错,但只有放在外面,才能保证被拒绝的动词不会被再次抽到。第7格的测量就是反例——没有允许列表时,检测器+重试组合让 out-of-envelope 执行从 74 次涨到 93 次。
- 被拒绝的操作绝不会重试;只有被捕获的失败才会重试。 混淆这两种状态,就是让重试预算变成对你自己权限系统的拒绝服务攻击。拒绝意味着 这个操作不合法;捕获意味着 这次尝试格式有误.
- 幂等性键要从操作本身推导出来,而不是每次调用都新生成一个。 在生产环境中,它就是数据库某一列的唯一约束,这个约束就是全部实现。调用时生成的 UUID 不是幂等性键,只是重复操作的收据。
- gate 有三个阈值,不止一个。
pass^k一个用于可靠性,一个用于 out-of-envelope 计数(containment),还有一个是注入故障后的 blast-radius 检查,用来测那些一切正常时永远不会触发的安全装置。
有意缺席的:并发(两个运行争抢 undo log)、升级路径后面的人类审批队列、真实模型、真实数据库——幂等账本就是个 dict。两套构建的真实状态是 可运行且有 gate,不是 已上线且有真实测量.
同一个故事,五种出口
一条主线,然后每个读者一扇门。只带走一个决策和一个行动,其余留给别人。
| 如果你是 | 本集希望你换掉的那个决策 | 本周你可以做的一个动作 |
|---|---|---|
| 高中生开发者 | “给 AI 配工具”其实是设计一间厨房,不是直接把刀递过去。 | 跑一遍 Colab 实验(5秒,无需 key),然后给朋友讲清楚 pass@k 和 pass^k 向一个朋友讲明白。 |
| AI 工程师 | 你的可靠性指标大概率是 pass@k,即使智能体行为失控,它也会在 1.000 饱和。 | 算一算 pass^5,针对你手头的某个智能体,同时统计有多少操作越出了 envelope。 |
| 创始人 | 权限图不是质量的证据;envelope 只能让智能体变得安全,不代表它就变好了。 | 让你的团队给出 pass^k 和 out-of-envelope 的计数。如果没人能报出第二个数字,这本身就是发现。 |
| 高管 | 面对一个自主系统,最该问的是:哪些操作不可逆?这些操作的边界是什么? | 下次架构评审时加一句:“哪些 verbs 没被授权?blast-radius cap 设了多少?” |
| 投资人 | 任何智能体公司都能做出一场好看的 demo,真正难以复制的是 envelope 和它的 gate。 | 让他们把 pass^k 和 pass@k 并排给你看。只给其中一个,都是表演。 |
现实任务
十五分钟,拿你本周已经在跑的某个东西。
- 挑一个你已经赋予工具权限的智能体或自动化——只要能写、能发、能花钱、能删东西都算。
- 写下它能调用的每一个 verb——不是你本来想给的,是代码里实际能 reach 到的。光这一步,通常就有发现。
- 给每个 verb 标记 可逆 或 不可逆。不可逆的动词需要 allow-list;可逆的可以用 undo log 处理。大多数人只做了 log,没有做 list。
- 任选一个代表性任务跑五遍,统计有多少次 五次全过。这就是你的 pass^5;和你一直在报的那个数字对比一下。
pass^5 - 找一个安全装置,问它上次触发是什么时候。如果答案是“从没触发过”,那就写一个能让它触发的测试。
如果第 2 步发现了你没意识到可达的动词,就停在这里。本集剩下的内容都是在你还没画好 envelope 前的优化。
研究挑战
实验前先写下你的预测——你没预测到的结果,事后一定会被你合理化。
选一个有可验证结果、且有真实工具面的智能体任务。测定 pass@k 和 pass^k,pass@k以及pass^k,在 k ∈ {1,3,5,8}、N ≥ 100、固定设置下,外加一次超出已声明 allow-list 的动作计数。然后每次只去掉一个 envelope 元素(allow-list、dry-run、output validation、bounded retry),顺序随机,分别报告每个元素对 pass@kpass^k和 out-of-envelope 动作数的边际影响。两种模型都做一遍。
实验前登记: 哪个元素对 pass@kpass^k影响最大,是否和对 containment 影响最大的是同一个元素,以及这个排序在两种模型下是否稳定。
我的桩智能体的答案:它们是 不同 的元素——retry 决定 reliability,allow-list 决定 containment——而 Dhage 的论文正是预期排序会随模型变化的理由。如果真系统里有一个元素同时决定两者,那比我的结果更有意思。
最新进展
本梯级截至发稿时的最新动态,来自 30 个先锋源的每周实时同步 research-anything (make watch-sync),按技术信号排序,从不按声量。同步时间:2026-09-11。 所有条目均为实际抓取,并非仅凭订阅标题摘要。
- MCP 新版路线图(2026-08-22)——维护团队发布了 "an updated roadmap for the Model Context Protocol (MCP), covering the next specification release and beyond"(中译:一份涵盖下一个规范版本及未来规划的 Model Context Protocol (MCP) 更新路线图),其中明确提出企业级安全和更完善的基础能力等方向。harness 工程的工具层,如今已作为标准治理,而不再只是随产品发布的一个功能。
- arXiv:2608.27443 (2026-08-27) — 用户自定义权限策略能否更好防止 AI Agent 越权?,Ting Yan。113 位非工程师参与者在三种条件下,监督了包含 7 个越权行为的 18 步模拟日常流程。对于所有主打“策略”治理 agent 的方案,这个结果都不太友好:"POLICY blocked less overreach than HITL (-20.1 percentage points, 95% CI [-32.1, -8.1])"(中译:权限策略比人工审批少阻止了 20.1 个百分点的越权,95% 置信区间 [-32.1, -8.1])。自己写权限策略,比一条条审批操作还难——这是我见过的第一个相关数字。
- arXiv:2609.00829 (2026-09-01) — HarnessEvolve:基于参考轨迹的可靠 Agent 自进化学习,Jiang, W. 等人,开篇就把 harness 工程作为优化对象:"Self-evolving agents advance toward autonomy by optimizing their harness---prompts, skills, tools, and execution logic---based on environmental feedback."(中译:自进化 agent 会根据环境反馈优化自己的 harness——提示、技能、工具和执行逻辑——不断迈向自主化。) 第三阶梯交棒给第四阶梯,也正是第 4 集的全部主题。
- 就在窗口之外,但主题直击本集:arXiv:2608.14711, Beyond Pass@k:Agentic 代码生成的可靠性与安全性测量(2026-08-11——比本节截止日期早一天,因此列在这里而非上文。)
- 更早但分量十足:arXiv:2405.15793(SWE-agent,ACI 结果),arXiv:2406.12045(τ-bench,
pass^k),以及 Lilian Weng 的 Harness Engineering for Self-Improvement(2026-07-04),至今仍是对这一层级最清晰的定义。
[开放问题] 目前没有进展:arXiv:2608.26197 还没有被复现,也没有找到任何在真实智能体上同时报告 pass^k 和 out-of-envelope(越界)动作计数的公开研究——这正是本期主张的测量方式,而我的桩智能体只能演示出它的轮廓。如果你知道有,欢迎公开指正。pass^k和 out-of-envelope(越界)动作计数——这正是本期主张的测量方式,而我的桩智能体只能演示出它的轮廓。如果你知道有,欢迎公开指正。
自查题
别往上翻,先自测一下。
- 请定义 pass@k 和 pass^k,
pass@k,并说明哪一个才是客户实际体验到的。pass^k请写出 envelope(控制封套)的五个要素,并指出其中哪三个是检测器。 - 请写出 envelope(控制封套)的五个要素,并指出其中哪三个是检测器。
- 单独加一个有界重试(bounded retry)并不会改变什么。在重试会导致被禁止调用次数上升之前,必须先具备哪些条件?为什么?
- 一个智能体的得分是 pass@k。请说出它能告诉你哪两件事,以及不能告诉你哪两件事。
pass@8 = 1.000。请说出它能告诉你哪两件事,以及不能告诉你哪两件事。 - 为什么 pass@k 无法测试 kill switch?后来用什么方法替代了它?
make gate-broken为什么 pass@k 无法测试 kill switch?后来用什么方法替代了它?
悬念
你来画这道 envelope(控制封套)。
每个动词都在 allow-list(允许列表)上。每个目标地址都在 commit(提交)前检查。每个结果都在 pass 处校验。重试预算就是预算,不是循环;kill switch(熔断开关)有明确的阈值。gate(闸门)显示 pass^5 1.000,out-of-envelope(越界)为 0,然后你会有那么一个下午觉得自己已经把厨房问题彻底解决了。
但你再看看 complete(完整性) 那一行始终没变,你会发现,有些问题是控制封套永远无法解决的。
那些被 pass 拦下又送回来的盘子,总有原因。可没人把原因写下来。每次都是同一个工位、同一个错误、每班都被抓、每班都重做。今晚和上周二没任何区别,唯一不同只是你为原料多付了一遍钱。
一个能抓住每个坏盘子却永远不总结原因的厨房,永远不会进步——但浪费食材倒是一把好手。
第 4 集 —— 循环工程。 这一轮对了,下一轮又变了,补救方法不是重试,而是一个不归厨师管的裁判。
延伸阅读
第 3 集,出自 智能工程冒险记,第 7 季 —— 厨房阶梯。本系列所有论点在原文中均有类别标记——定义、推导、证据、工程选择、开放问题——比喻可以引出论点,但永远不能作为证据。每集都配有一个 Colab 笔记本,免费、无需 API key,再加两个从零搭建的应用——一个个人用,一个企业范儿。五阶梯来自 Feng 等人的论文(arXiv:2608.21156);第六阶梯 evaluation engineering 是我加的。「what moved」部分由 30 个先锋源的每周实时同步生成,只按技术信号排名,从不看受众数。本文无任何雇主或客户素材。—— Paul Jialiang Wu · futuremake.io
参考文献
- Yang, J., Jimenez, C. E., Wettig, A., Lieret, K., Yao, S., Narasimhan, K., Press, O. (2024)。SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering. arXiv:2405.15793,提交于 2024-05-06。—— 证据来源:arXiv 摘要页。两条 ACI 原文引述及 SWE-bench pass@1 12.5% 的出处。
- Yao, S., Shinn, N., Razavi, P., Narasimhan, K. (2024)。τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. arXiv:2406.12045,提交时间:2024-06-17。——原文阅读自 arXiv 摘要页。数据来源:
pass^k,以及文中引用的 <50% / pass^8 <25% 数据。 - Anthropic — Schluntz, E., Zhang, B.(2024-12-19)。Building Effective Agents. anthropic.com/engineering。——原文阅读自线上工程博客,抓取时间 2026-09-11。HCI/ACI 经验法则及第三条核心原则出处。
- Dhage, S.(2026)。Harness Engineering for Predictable Agentic Systems: An Empirical Study of Deterministic Execution Constraints. arXiv:2608.26197,提交时间:2026-08-25。——原文阅读自 arXiv 摘要页。1-of-4 / 2-of-4 首次实验结果、token-cost 与 latency 分化、以及结尾“measured, not assumed”出处。
- Weng, L.(2026-07-04)。Harness Engineering for Self-Improvement. lilianweng.github.io。——原文阅读自线上文章。harness 工程定义的完整引用出处。
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. 等(2026)。Graph Engineering in the Era of LLM Agents: From Individual Intelligence to System Intelligence. arXiv:2608.21156v2,修订于 2026-08-26。——原文阅读自 arXiv 摘要页。阶梯模型的正式发表版本,包括"Harness Engineering to organize external tools and resources"(中译:Harness 工程用于组织外部工具和资源).
- Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., Cao, Y.(2022)。ReAct: Synergizing Reasoning and Acting in Language Models. arXiv:2210.03629,提交时间:2022-10-06。——原文阅读自 arXiv 摘要页。
- Schick, T., Dwivedi-Yu, J., Dessì, R. 等(2023)。Toolformer: Language Models Can Teach Themselves to Use Tools. arXiv:2302.04761,提交时间 2023-02-09。— 阅读材料:arXiv 摘要页。
- Patil, S. G., Zhang, T., Wang, X., Gonzalez, J. E.(2023)。Gorilla: Large Language Model Connected with Massive APIs. arXiv:2305.15334,提交时间 2023-05-24。— 阅读材料:arXiv 摘要页。
- OpenAI(2023-06-13)。Function calling and other API updates. openai.com。— 仅描述,未引用原文。
- Anthropic(2024-11-25)。Introducing the Model Context Protocol. anthropic.com/news。— 阅读材料:线上公告,所引定义出处。当前规范文档:modelcontextprotocol.io(无日期文档主页,仅作规范引用)。
- Model Context Protocol 维护者(2026-08-22)。The New MCP Roadmap. blog.modelcontextprotocol.io。— 阅读材料:线上文章。
- Yan, T.(2026)。Do User-Authored Permission Policies Improve Protection Against AI Agent Overreach? arXiv:2608.27443,发表于 2026-08-27。——已查阅 arXiv 摘要页,所引 −20.1 百分点结果出处。
- Jiang, W., Chu, M., Tian, Y. 等(2026)。HarnessEvolve: Learning from Reference Trajectories for Reliable Agent Self-Evolution. arXiv:2609.00829,发表于 2026-09-01。——已查阅 arXiv 摘要页。
- Jiang, Jiajun, Zheng, S., Vidra, N., Setty, S.(2026)。Beyond Pass@k: Measuring Reliability and Security of Agentic Code Generation. arXiv:2608.14711,发表于 2026-08-11。——在「What moved」中列为刚好超出统计窗口。
- Jimenez, C. E., Yang, J. 等(2023)。SWE-bench: Can Language Models Resolve Real-World GitHub Issues? arXiv:2310.06770。——12.5% pass@1 指标的基准数据来源。
- Lab 03 及两个项目,本文所有数字均可由其复现:gist.github.com/wjlgatech/218a4a45533812ebe0b3f0e577dd6be7.
- Intelligence Engineering Adventures,第六季——The Governor Engine,第 1 和第 3 集,论证嵌套图无法经受实战、且这里没有任何标签能表达稳定性的部分。