AI-Native 系列 · 智能体工程对比:提示 · 上下文 · 封装 · 循环 · 图
图工程:调度表,不是人设剧组
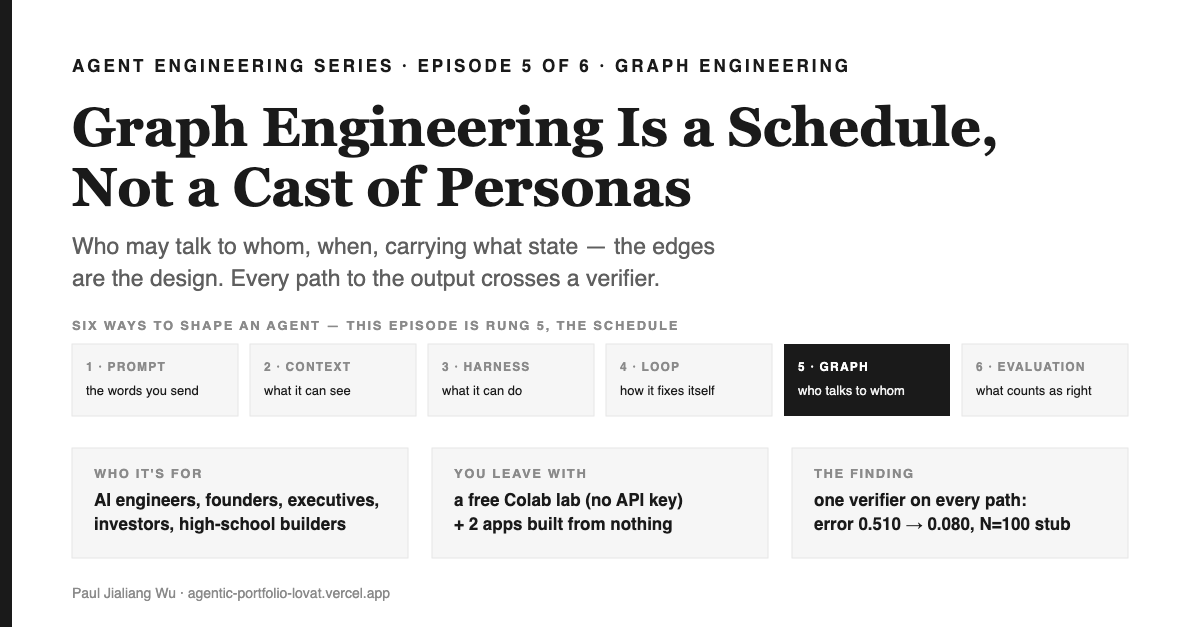
第 5 集(共 6 集)。本系列对比 AI 智能体的工程方式——提示、上下文、封装、循环和图工程:各自的起源、可控范围、推动者,以及哪些原则经得起量化检验。本集正是那个「一个智能体不够用」的分水岭,也是几乎所有人都买错东西的地方。
一分钟速览 —— 你将收获什么
这是什么。 一套对比 AI 智能体工程方式的系列文章——提示工程(你发什么词)、上下文工程(它能看见什么)、封装工程(它能做什么)、循环工程(它怎么自我修正),以及 图工程(多智能体如何协作)。本期聚焦图工程:2023 到 2026 年的发展脉络,主导者是谁,以及唯一经得起测量的原则——边才是设计本体,人设只是外衣。
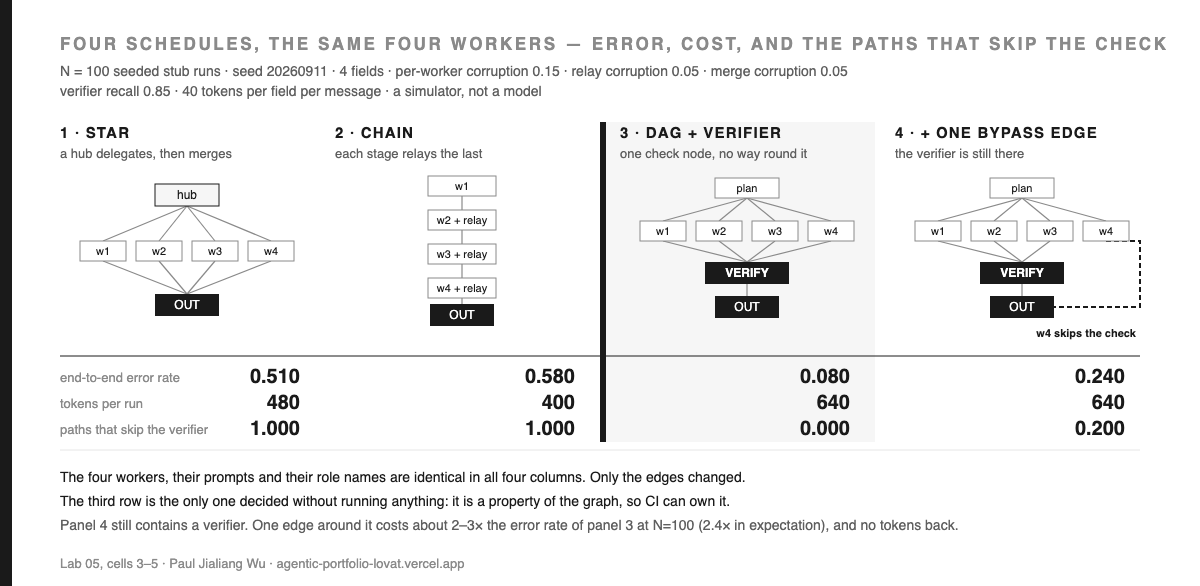
为什么值得关注。 多智能体系统总是被包装成一组角色,成本大约是单聊的十五倍,而且会以单智能体绝不会出现的方式失败。基于七个框架、1600 多条标注轨迹构建的失败分类法,有三分之一的失败类型都归因于 任务校验 本身。在我自己的实验里,四个工人和他们的职位名称都不变,只改连线,端到端错误率就能从 0.510 降到 0.080(N=100 仿真器);而只要在包含校验节点的系统里加一条绕过校验的捷径边,错误率又回升到 0.240——N=100 时大约是原来的 2–3 倍(期望值 2.4×)。对创始人来说,这就是演示和账单的区别;对工程师来说,这是一项微秒级、无需模型的静态检查。
读完你能做什么。 把你的智能体系统画成一份边列表,找出所有能在未经过校验节点的情况下到达输出的路径,把这类路径直接视为构建失败。你会拿到一个免费的 Colab 笔记本(无需 API key,CPU 秒级),并排测四种拓扑,还有两个从零搭建的应用:一个晚宴计划器,靠一份排班表从设计上避开了 224 个交叉冲突,而只靠人设聊天最多能发现其中 50 个;另一个是事故响应图,make gate 一旦有人加了捷径,立刻就能定位具体路径并退出。
Season 7 — 系列脉络
- 提示工程——规范,不是咒语 第 1 集
- 上下文工程——预算,不是更大的窗口 第 2 集
- harness 工程——是 envelope,不是 agent 第 3 集
- 循环工程——是外部裁判,不是重试 第 4 集
- 图工程——是排班表,不是人设演员表 本集
- 评估工程——这是真值函数,不是排行榜 第 6 集
本集讲什么,以及为什么图工程排在第五
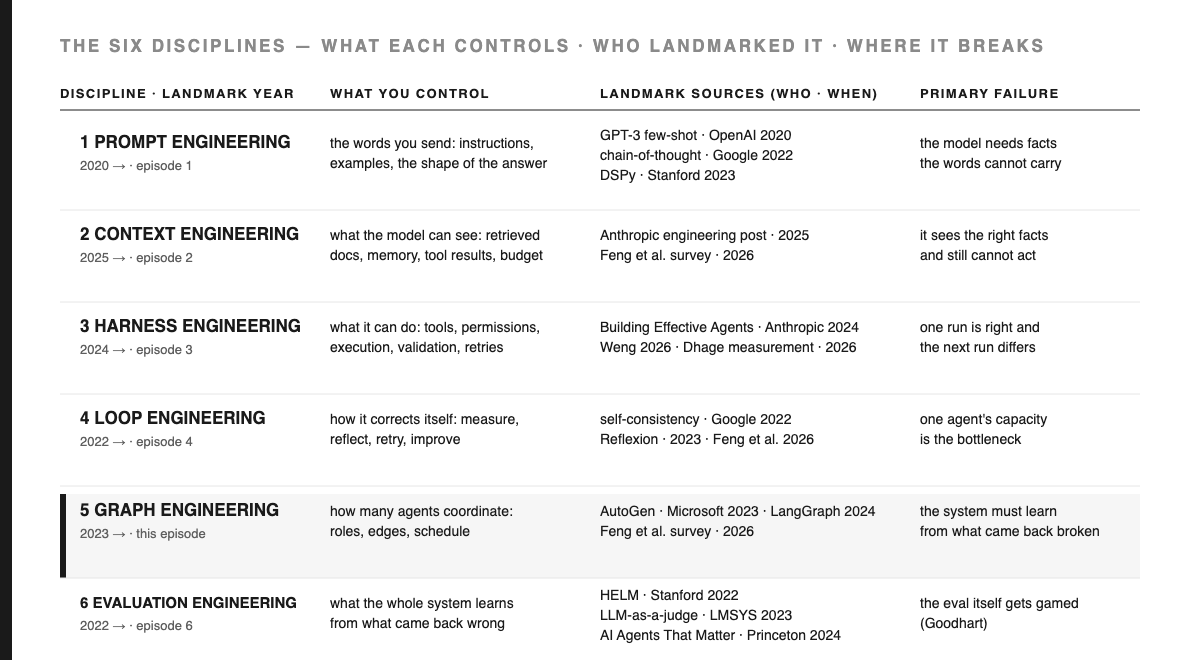
现在,构建 AI 智能体有六个已命名的工程分支,大致按这个顺序出现:提示工程(2020)、循环与评估工程(2022)、图工程(2023)、封装工程(2024)、上下文工程(2025)。前五个分支最清晰的公开表述,见 Feng 等人的综述(arXiv:2608.21156),它是按 每种方法能让你掌控什么 来排序,而不是按年代:提示→上下文→封装→循环→图。第六阶不是他们提出的,也不是引用——评估工程是本系列自创的概念,第六集会为它专门论证,而不是默认它存在。本系列每集聚焦一种方法,顺序不变,每次都问同样四个问题:它从哪来,你能控制什么,谁在推动它,哪种失败会让你走向下一阶。
图工程,是当你发现短缺的已经不是 agent 的能力,而是它的 组织能力:需要多种专长并存、子任务相互依赖、部分工作可并行、结果必须有人校验、状态要能在步骤间流转。你不再只是在调优一个工人,而是开始设计谁把什么交给谁——而此时,业界最自信的工程,往往押注在最难校验的对象上:一串职位名称。
适合哪些人。 适合正准备加第二个 agent,或在调试五个 agent 系统的工程师;在犹豫“multi-agent”到底是架构还是 PPT 的创始人;被告知“多加点 agent 就行”但想先看账单的高管;想搞懂“orchestration”到底是什么、不想被组织结构图唬住的高中生。前置条件:你至少串过两次模型调用。
图工程的起源与推动者
[定义] A graph,在离散数学课上就是指节点和有向边。节点是工作单元——可以是 agent、工具或校验。边决定谁能把工作交给谁。图工程,就是主动设计这种结构,而不是让它自然生长。它的历史,就是业界如何从“两只 chatbot 对话”走到“编译好的执行图”。
| 时间点 | 里程碑 | 贡献者 | 改变了什么 |
|---|---|---|---|
| 2023-03 | CAMEL(arXiv:2303.17760) | Li 等,KAUST | 两个 agent 角色扮演对话,全程无人参与。第一个被大规模模仿的“如果对面也是模型会怎样”的答案。 |
| 2023-07 | ChatDev(arXiv:2307.07924) | Qian 等,清华 | 一家以固定顺序对话为核心的软件公司。chat chain,让流程本身成为产物——首次点明:调度表才是设计本体。 |
| 2023-08-01 | MetaGPT(arXiv:2308.00352) | Hong 等人 | 把标准化操作流程写进提示序列,像装配线一样让智能体协作,实现“verify intermediate results and reduce errors”(中译:校验中间结果并减少错误)。校验机制正式进入架构。 |
| 2023-08-16 | AutoGen(arXiv:2308.08155) | Wu 等人,Microsoft | 对话模式从文本转为可编程代码,成为业界两年来默认的多智能体框架。 |
| 2024-02 | More Agents Is All You Need(arXiv:2402.05120) | Li 等人,Tencent | 采样加投票:性能随智能体数量提升,彼此之间完全不交流。这是“人设不是重点”的最有力论据。 |
| 2024 | LangGraph(github.com/langchain-ai/langgraph) | LangChain | 图结构首次成为工具链中的一等公民:节点、边,以及每一步都能检查的显式共享状态。 |
| 2025-03 | Why Do Multi-Agent LLM Systems Fail?(arXiv:2503.13657) | Cemri 等人,UC Berkeley 及其合作者 | 这是首个针对多智能体系统的失败分类法,基于七个主流框架的标注轨迹构建。多智能体系统不再只是“氛围感”,而是有具体缺陷名称的技术对象。 |
| 2025-04-09 | Agent2Agent 协议(developers.googleblog.com) | 边变成了厂商间的协议:不同框架上的 agent 能互相发现并委托任务。此时,边是接口,不再只是导入。 | |
| 2025-06-13 | 我们如何构建多智能体研究系统(anthropic.com/engineering) | Anthropic | 一篇生产级实录,既有内部评测的大幅提升,也有为此付出的 token 成本倍增。 |
| 2026-08 | 大模型智能体时代的图工程(arXiv:2608.21156v2) | Feng 等人 | 提出并命名了这一范式,将其列为第五层,并论证其核心约束是组织能力而非认知能力。 |
| 2026-09-04 | 推理时的图工程(arXiv:2609.05774) | Tieu 等人 | 将图的编译与执行分离,使拓扑结构能在运行前被检查。编译器时代由此开启。 |
[设计] 有三点值得注意。第一,这一领域自 2023 年起以“对话”为原始形态,三年间持续用结构取代对话:CAMEL 有两位说话者,ChatDev 有顺序,AutoGen 有模式,LangGraph 有边列表,2026 年的工作则有编译器。第二,校验机制很早就出现——MetaGPT 在 2023 年 8 月就已校验中间结果——但很快从市场宣传中消失,这正是本集要讨论的缺口。第三,表中最尖锐的实证结果表明,你甚至可能根本不需要图结构:独立采样答案并投票,无需任何边,性能就能随 agent 数量扩展。
现在是谁在推动这条赛道。 框架厂商(LangGraph、AutoGen 系列)掌握着工程师实际操作的抽象层。模型实验室负责发布生产经验——Anthropic 的实录是目前公开最详细的多智能体系统运行成本说明。Google 的 A2A 把一条边变成了两家公司可以共享的协议。学术界则分工明确:一部分在系统化范式(Feng 等人),另一部分在测量其失效方式(Cemri 等人,以及 2026 年的拓扑论文)。建议先读后者。
本系列的心智模型:厨房阶梯
一张图贯穿六集,用工具视角而非故事串联。每个厨师都要爬同一把梯子:先为自己做饭,再为家人、餐厅、快餐连锁,最后到为多家连锁供货的全国供应链。每个 AI 工程师也有类似路径——学生、初级开发者、资深开发者、AI 技术负责人、CTO、前沿探索者。
本集对应全国供应链:多家厨房,一套调度表,一支车队。注意在这个高度你的工作是什么。你既不下厨,也不品尝。你决定哪个仓库发货到哪个厨房,哪批货在上架前要被检查,出问题的托盘如何处理。没有哪个全国食品系统的运营者会相信食品安全取决于司机的自我标签。
| 层级 | 厨房 | 你的角色 | 你能影响的环节 |
|---|---|---|---|
| 1. 提示 | 菜谱卡——自己下厨 | 学生 | 写给厨师的操作说明 |
| 2. 上下文 | 储藏间——为家人做饭 | 初级开发 | 做饭时台面和冰箱里能用的食材 |
| 3. 封装 | 餐厅厨房 | 资深开发 | 各个工位、触手可及的工具、每道菜都要经过的传菜口 |
| 4. 循环 | 快餐连锁 | AI 技术负责人 | 品尝、测量、修正、把修正推广到每家门店 |
| 5. 图 | 全国供应链——多家厨房,一套排班表,一支车队 | CTO | 哪个仓库发货到哪个厨房,顺序如何,途中哪些环节要被检查 |
| 6. 评估工程 | 召回日志 | 前沿领军者 | 整个食品系统从返工中学到的经验 |
不是单一维度,而是双轴。 这不是一把爬完就丢的梯子:每个厨房其实同时有六层。家里的厨师有菜谱、有储藏室、有灶台、有味觉、有供应商,还有对上次哪里出错的记忆。你往上走,变化的是:你能实际掌控多少层,以及你把每一层做得有多严谨:先凭感觉,再量化,再加闸门,最后自我纠错。全国连锁有一张漂亮流程图但没有检查环节,成熟度还不如那家每盘必称重的小餐馆。所以这些学科是层级(你能控制什么);资历体现为成熟度(你怎么运行它们);而图工程并不天然比循环工程更高级。这个误区代价最大,因为画一张装饰性的图太容易、太有成就感。
比喻可以用来引入观点,但不能当作证据——每个元素都在下面的 1:1 技术映射中有锚点。本集结尾会发现:即使每条路径都安排了检查,一个排班表再完美的系统,依然无法告诉你这道检查本身是否靠谱。这就是第六集的主题。
这把梯子不是我发明的,「graph」这个词也不是。
[定义] 术语表全部溯源——因为这一层的标签比其它任何一层都多(orchestration、多智能体系统、agent workflows、swarms、agentic mesh),而大多数都在强调“演员表”而不是结构。
Feng 等人的综述(arXiv:2608.21156v2,2026-08-26 修订,2026-09-11 阅读 arXiv 摘要)列出了下面四层,然后为这一层做了论证。它对为什么需要第五层的分析,是五条清单,没有一项是性格特质:
“many tasks require heterogeneous expertise, interdependent subtasks, parallel execution, independent verification, and persistent state, exceeding any single agent's organizational capacity”(中译:许多任务需要异质化专长、相互依赖的子任务、并行执行、独立校验和持久状态,这些都超出了任何单一智能体的组织能力)
——Feng 等人,2026
异质专长、子任务依赖、并行执行、独立校验、持久状态——这些全是结构属性:哪个节点知道什么、等谁、查谁、哪些信息在节点间流转和保留。综述把目标称为系统智能,定义为“an agent system's ability to organize and coordinate multiple intelligent components into a coherent, adaptive whole pursuing a shared objective”(中译:智能体系统能够将多个智能组件组织协调为一个连贯、可适应的整体,共同追求同一目标的能力),并明确指出,光靠增加人数达不到:“Achieving it requires more than adding agents; it demands explicit structures to organize work, coordinate heterogeneous agents, and maintain evolving execution states.”(中译:要实现这一点,仅仅增加智能体数量远远不够;必须有明确的结构来组织工作、协调异质智能体,并维护不断演化的执行状态。)
而它真正构建的,正如综述原文所言,“explicit, dynamic, evolving graph structures representing tasks, agents, and system states”(中译:明确、动态、可演化的图结构,表示任务、智能体和系统状态)。任务、智能体、状态——三类节点,没有“人设”这种外衣。
[OPEN] 注意综述并没有声称:没有说这一层取代上一层,也没说图一定优于循环。这是原理、方法和应用的综述——是地图,不是测量结果。谁要把它当成“多智能体优于单智能体”的证据,就是把地图当成了标尺。
主张归类
[DEF] 结论是:在多智能体系统里,边才是设计本体——谁能和谁通信、何时通信、携带什么状态;而“人设”只是标签。人设只是提示词里的一个字符串,边才是“什么能到哪里”的事实。两者里,只有边能在不运行系统时被静态校验。
[EVIDENCE] 第一个理由要当真,是因为有人系统梳理了这些系统实际是怎么出错的,而那份目录和“角色”毫无关系。Cemri 等人(arXiv:2503.13657,2026-09-11 读 arXiv 摘要,v3 版 2025-10-26)开篇就拒绝了常见前提:“Despite enthusiasm for Multi-Agent LLM Systems (MAS), their performance gains on popular benchmarks are often minimal.”(中译:尽管多智能体大模型系统(MAS)备受追捧,但它们在主流基准上的性能提升往往微乎其微。)
他们真正做的是构建了一个数据集——“1600+ annotated traces collected across 7 popular MAS frameworks”(中译:横跨 7 个主流 MAS 框架、1600 多条带注释的轨迹)——并基于 150 条人工精读的轨迹,归纳出一套分类法,"validated by high inter-annotator agreement (kappa = 0.88)"(中译:经多人标注者高度一致性验证(kappa = 0.88))。最终产出,MAST:
"This process identifies 14 unique modes, clustered into 3 categories: (i) system design issues, (ii) inter-agent misalignment, and (iii) task verification."(中译:这一过程共识别出 14 种独特失效模式,归为三大类:(i)系统设计问题,(ii)智能体间失配,(iii)任务校验。)
——Cemri 等,arXiv:2503.13657
[DERIVATION] 这三个类别名,你可以像工程师读堆栈跟踪一样来看。系统设计问题——结构本身就错了。智能体间失配——边上传递了不该传的内容,或者时机不对。任务校验——没人检查。没有一条是“Researcher agent 不够好奇”,而且整个分类法顶层有三分之一都归因于缺少校验。
[EVIDENCE] 第二个理由,是这个层级最坦率的生产实录。Anthropic 的多智能体研究系统(2025-06-13)报告了一个大胜利:"We found that a multi-agent system with Claude Opus 4 as the lead agent and Claude Sonnet 4 subagents outperformed single-agent Claude Opus 4 by 90.2% on our internal research eval."(中译:我们发现,在内部研究评测中,以 Claude Opus 4 为主智能体、Claude Sonnet 4 为子智能体的多智能体系统,表现比单一 Claude Opus 4 智能体高出 90.2%。) 这是来自真实系统的实测数据,适用范围也在句子里写得很清楚:一次内部评测,一种主-子智能体结构,一组模型家族。
同一篇文章里,还有几乎没人引用的成本:
"In our data, agents typically use about 4× more tokens than chat interactions, and multi-agent systems use about 15× more tokens than chats."(中译:在我们的数据中,智能体通常比普通对话多用约 4 倍 token,多智能体系统则比对话多用约 15 倍 token。)
——Anthropic,2025-06-13
[DERIVATION] 十五倍不是小数点误差,而是直接多了一个员工。把这两句话放在一起,才是这个层级真正要你做的决策——不是多智能体是不是更好,而是这个任务值不值十五次对话。一份人设表永远不会逼你算清这笔账,而一份边列表会,因为每一条边都是一条消息,每条消息都要消耗 tokens。
[EVIDENCE]第三个理由,是反例,而且强到本集必须正面回应,不能只做脚注。Li 等人的 More Agents Is All You Need(arXiv:2402.05120)表明,只要多采样几个答案再用多数投票,性能就能随着 agent 数量提升——完全不需要调度、没有人设、甚至没有边。如果真是这样,这一层大多数人搭建的复杂机制,其实不过是在用大炮打一个 for循环加计数器 就能解决的问题。
2026 年的后续工作把这个矛盾点拆解得很清楚。Ann、Liu 和 Tan 的 The Interaction Tax(arXiv:2608.23541, 2026-08-24)在等预算下测试了 11 个由校验员评分的优化任务,发现让 agent 互相交流,反而会毁掉你本来想用多个模型买到的东西:"when agents read each other's complete outputs, their proposals converge within one round, erasing the diversity that motivates using multiple models"(中译:当 agent 们互相读取彼此的完整输出时,它们的方案会在一轮内收敛,从而抹杀了你用多个模型本想获得的多样性)。他们的结论,正好是本集论点的反面表达——"multi-agent performance depends less on the number of agents than on the information they exchange"(中译:多智能体系统的性能,与其说取决于 agent 数量,不如说取决于它们交换的信息).
[DERIVATION]所以,两篇论文都留下的原则是:加 agent 不一定有用,加交流反而可能有害;真正有效的是设计好 每条边上传递什么、何时传递,并在输出前加一次独立校验。独立采样加投票,本身就是一种完全正当的图结构——扇出聚合、无交叉通信——如果你的问题有个便宜的校验员,这可能就是你能造的最优图。这是关于“边”的决策,不是关于“谁当评论家”的决策。
1:1 技术映射
比喻里的每个元素,都能在代码里一一对应。
| 供应链 | 系统 | 它所在的位置 |
|---|---|---|
| 一个仓库、一间厨房、一个实验室 | 一个节点——一份工作单元 | 一个函数、一个 agent、一次工具调用 |
| 调度表上的一条路线 | 一条有向边——谁可以把工作交给谁 | 边列表中的一项 |
| 整个调度表本身 | 调度表——整个图 | edges: list[tuple[str, str]] |
| 卡车上装的东西 | 消息载荷和共享状态 | 沿边传递的类型化状态对象 |
| 上架前的校验 | 校验节点 | 对合并后状态的确定性校验 |
| “没有任何托盘能未经校验就上架” | 可达性不变量 | unverified_path_share == 0.000 |
| 仓库在周日走的捷径 | 旁路边 | 边列表里多出来的一组元组 |
| 清单上司机的职位标签 | 人设字符串 | 没有任何状态转移会读取的 prompt 字段 |
| 每次配送消耗的燃料 | token 乘数 | 消息数 × 载荷大小 |
| 一个仓库重复前一个仓库的操作 | 一致性——多样性坍缩 | 全输出边的 interaction tax |
[定义] 本集余下内容依赖的三个核心指标,定义如下:
- 端到端错误率 ——N 次相同实验中,输出任一字段出错的比例。
- 成本 ——每次运行的消息数与 token 数。每条边都有代价,忽略成本的拓扑对比只是广告。
- 未校验路径占比 ——所有从源点到输出的简单路径中,未经过校验节点的比例。仅用图结构即可计算:无需采样、无需模型、无需随机种子。
第三项是本集的新增贡献:前两项依赖采样,受模型、温度或运气影响,而第三项是可判定的。这也是它适合进 CI,而另外两项只适合放在 dashboard 上。
预测闸门
在你继续往下看之前,先写下你的预测——没写下来的预测,事后你总会觉得自己猜对了。
四个专职工人,各负责四字段答案中的一个。所有参数,下注前全部公开:每工人出错率 0.15 · 转发出错率 0.05 · 合并出错率 0.05 · 校验器召回率 0.85 · 每字段每消息 40 tokens。三种连线方式:星型(中心节点分发并合并,合并时可能污染一个字段)、链式(每步写自己的字段并转发上游所有内容)、以及四个工人都把结果送入一个校验节点的 DAG。
Q1. 先按端到端错误率从高到低给三种拓扑排序,再预测最好和最差之间的差距有多大。
Q2. 再按每次运行的 token 数从高到低排序。
Q3. 现在取 DAG,不动校验节点,给第四个工人加一条直达输出的边——也就是有人为降低延迟加的“捷径”。此时有四分之一的字段会跳过校验。端到端错误率会怎样:大致翻倍,还是更糟?
答案见 Notebook 和 Failure Room。如果你在 Q1 里把链排在中间,建议实际跑一遍实验。
Failure Room(故障间)
故意把它搞坏——一个你无法主动破坏的机制,只是个主张。
故障 1 ——把演员表当成设计。 你列出五个 agent,给他们安上职位名称,就觉得架构完成了。但运行时没有任何一步会读取职位:路由器看的是图,聚合器看的是状态,校验节点看的是字段。我自己关于专家小组的心理学实证研究也验证过——人设标签在 162 个角色、2410 个问题上并未提升事实准确率,真正有效的是让 agent 立足于某个人的语料库,而不是对那个人的描述。语料是数据,标签只是字符串。一人十帽的观点 里讲得很透。
Failure 2 —— 校验节点“名义上”在场。 这才是本文真正值回票价的地方。在实验里,带闸门的DAG和加了一条绕行边的同一个DAG都设有校验节点,两者都能通过任何只问“你有检查步骤吗?”的评审。被绕过的那个,实际运行时 0.240 端到端错误率对比 0.080 ——在N=100时大约高出2–3倍,期望值2.4倍——token数却完全一样,都是640,因为校验节点还在另外三个字段上照常工作。你为检查付了成本,但有一条路径直接跳过了它。静态指标能在微秒级别发现问题:未校验路径占比从0.000变成0.200。采样出来的数字也能抓到,只是要等到N=100。
Failure 3 —— 看起来整齐的链式结构。 实验室里最省token的拓扑(400 tokens,对比star的480和DAG的640)反而是最差的,错误率0.580:第一个字段只写一次(0.15),然后被后面三步各转发一次(每次0.05),所以它有四次出错机会,而最后一个字段只有一次。错误的传播不是工人本身的属性,而是拓扑让一个值被反复处理的次数决定的。
Failure 4 —— “共识”假象下的一致性。 让agent们多聊几句,他们就不再有分歧了,这看起来像进步,实际上正好相反:当agent们能读到彼此完整输出时,方案一轮内就收敛了。在我的晚宴计划器项目里,纯人设聊天那组只发现了224个交叉冲突中的50个,而且漏掉的那些并不难。三位专家一致同意了一道含核桃的甜点。共识无懈可击,过敏也同样无懈可击。
Failure 5 —— 0.000但毫无意义的指标。 只要让校验节点直接返回 True,未校验路径占比就能变成0.000。和第1集里确定性指标在空对象上读到1.000如出一辙:可达性不变量必须和结果指标一起报告,绝不能单独出现。闸门只能证明有检查 在路径上。它完全不能说明检查本身有没有用——这正是第6集要讲的。
Q3答案: 这次实验里大约是三倍(0.080 → 0.240);实验室参数下期望值0.206,约2.4倍。无论怎么算,机制才是重点:被绕过的字段一旦出错就必然存活下来,而不是0.15的概率。四分之一的路径绕过闸门,这个闸门就不是75%的闸门。
实验记录本
Lab 05 —— 调度表,不是人设。 
05_graph_schedule.ipynb · Colab 免费版 · 无需API密钥 · CPU几秒钟 · 所有单元格都在发布前实际运行,下面的数字就是实验输出的结果。
共8个单元格。这个 Graph 对象包含节点、边、输出节点和可选的校验节点;四种拓扑除此之外没有任何区别。
parameters: per-worker corruption 0.15 · relay corruption 0.05 · merge corruption 0.05
            verifier recall 0.85 · 40 tokens per field per message · 4 fields

topology                            err    msgs   tokens  paths  unverified
star (hub + 4 workers)            0.510     9.0      480      4       1.000
chain (4 stages)                  0.580     4.0      400      1       1.000
DAG + verifier                    0.080    10.0      640      4       0.000
DAG + verifier, 1 bypass edge     0.240    10.0      640      5       0.200

  orphaned output   -> RAISES: no path reaches 'OUT' — the graph is
disconnected, not verified[EVIDENCE]三条发现,按意外程度排序。
最便宜的拓扑反而最差。我原以为链式结构会介于星型和DAG之间,结果它在消息数更少的情况下反而比两者都差。
旁路边几乎零成本,却能把一切搞砸。代币数完全一样,N=100时错误率却高出约2–3倍。这个捷径在这里甚至连一条消息都没省下,根本没有效率上的理由——这正好模拟了现实:省了一点延迟,付出了大量正确性,结果这两样都没人去量。
闸门很无聊——这正是它的意义所在。第5格对四个图都做了可达性检查,并打印出CI会用的退出码:微秒级,无需调用,完全确定性。四个图里有两个在还没跑一轮前就直接挂了——还有第五个图,输出节点根本没人能到,检查直接抛错,而不是舒舒服服地打个0.000分。
第6格的全量扫描值得你抄走:它展示了旁路图在问题变难时,始终跟着未加闸门的分支走,而不是跟着加了闸门的那条线。
| 每工人错误率 | 星型 | 链式 | DAG + 校验节点 | + 旁路边 |
|---|---|---|---|---|
| 0.05 | 0.220 | 0.410 | 0.030 | 0.070 |
| 0.10 | 0.370 | 0.480 | 0.080 | 0.180 |
| 0.15 | 0.510 | 0.580 | 0.080 | 0.240 |
| 0.20 | 0.580 | 0.630 | 0.150 | 0.280 |
| 0.30 | 0.760 | 0.800 | 0.160 | 0.460 |
加闸门那一列基本保持平稳,其他每一列都在爬升——这是结构性修复的特征,而不是头痛医头脚痛医脚。只在一个噪声水平下测量,这种现象就完全看不出来——而几乎所有人都是这么测的。
[DESIGN]第7格是最直接的。run_dag接受一个personas参数;我传进去的是Senior Chef、Michelin Inspector、Nutritionist和Logistics Lead,分别挂在四个工人身上,并随状态一起传递——那一格会把携带的dict打印出来,你可以确认它们真的在。错误率精确地没动,代币数也精确地没变,原因是结论本身,而不是借口:这个函数里没有任何一行会根据人设分支。在一个行为由图决定的系统里,人设标签根本无处可插。这不是在测语言模型,而是在演示因果箭头到底能落在哪。头衔还在组织架构表上。
[DESIGN]为什么用 stub。模拟器能在几秒钟、免费、无密钥地复现错误是怎么进来的、又是怎么被消除的。它不会 复现量级:这里打印出来的任何数字,都不能作为 Anthropic 90.2% 或 MAST 相关结果的证据。第 8 单元格是桥梁——把抛硬币换成模型调用,Graph,gate 和三项指标依然不变,因为它们天生就是无模型的。
项目
两套从零搭建的小项目。无任何框架,仅用标准库,均设定种子,均在本节写作前实际跑过,notebook 的 gist 里都能找到。
项目 1 —— 现实场景:the-dinner-party
p1_dinner_party.py · python3 p1_dinner_party.py 100
六人晚宴。一位嘉宾吃纯素,一位对坚果过敏,预算 80 美元,只有一层烤箱架,大家 19:00 入席。三个专职 stub 各自负责计划的一部分——agent_menu 选菜,agent_shopping 计算购物篮价格,agent_timing 分配烤箱时间——彼此看不到对方的输出。每个部分单独看都对、都自信;但失败就藏在它们之间。每条能抓住这些失败的规则都需要两个专家的信息,这也是为什么没有哪个专家能独立负责一条规则的结构性原因:
allergen  needs  menu + the guest list      a dish contains nuts
diet      needs  menu + the guest list      the main is not vegan and one guest is
budget    needs  menu + shopping            the basket cleared $80
oven      needs  menu + timing              two dishes want the single rack at once
timing    needs  menu + timing              a dish finishes after people sit down
[EVIDENCE] 两种方案,同样的专家,同样的种子。A 组是只靠人设的聊天:轮流发言,下一位可以提出异议。B 组是一份排班表加一个 verifier 节点:三人都写入共享状态,然后一个 check 节点执行五条规则。
conflicts present            : 224
caught by persona-only chat  : 50    (0.223 recall)
caught by schedule+verifier  : 224   (1.000 recall — by construction, see below)

dinners served with an unresolved conflict
  persona-only chat          : 85/100  (0.850)
  schedule + verifier        : 0/100   (0.000)

by rule: allergen 83 · oven 74 · timing 36 · diet 22 · budget 9
[OPEN] 这并不能证明什么:chat 组发现问题的概率是我设定的 0.30 并带衰减,模拟那种“面对三段自信陈述更容易随大流而不是反对”的心理。这不是任何模型的测量,0.223 也和这个旋钮一样只是人为设定。结构性事实是:需要两个专家信息的规则,在有了 graph 之前没人能负责。没人会在职位描述里写“我负责我和别人的输出交互”。而排班表组的 1.000 是结构保证的:verifier 节点执行的就是那五条定义冲突的规则,不可能漏掉。这里测量的其实是 chat 组的损失,不是 verifier 的能力——和 Failure 5 里警告的无效指标如出一辙,这里如实披露因为是我自己的实验。
项目 2 —— 企业级:the-incident-room
p2_incident_room.py · make gate · make bypass · make measure
一个事件响应 graph:
page → triage → diagnose → mitigate ─┐
                └────────→ rollback ─┼→ check → resolve
triage → comms ───────────────┘不变量,一句话总结:没有任何节点到resolve的路径可以绕过check。这是 graph 的属性,不是某次运行的结果,通过枚举所有简单路径判定——无模型调用、无采样、无抖动。它和我自己研究用 harness 里的模块可达性规则同型——未发表,所以只能当作实践经验,不算引用。
$ make gate
  paths to 'resolve'        : 3
  paths that skip 'check'   : 0   (share 0.000)
  invariant: every path to 'resolve' crosses 'check' -> HOLDS     exit 0

$ make bypass          # after adding ("rollback", "resolve")
  paths to 'resolve'        : 4
  paths that skip 'check'   : 1   (share 0.250)
    BYPASS: page -> triage -> diagnose -> rollback -> resolve
  invariant: every path to 'resolve' crosses 'check' -> VIOLATED  exit 1
[EVIDENCE] gate 会直接点名是哪条路径出错,而不是泛泛地说“某处有问题”——这就是有人能修的失败和只能被禁用的失败的区别。N=100 组种子事件,check 节点负责四条跨字段规则:
                                            gated     + one bypass edge
rule violations raised (all runs)              63                    63
incidents blocked at the check node   52/100 (0.520)        37/100 (0.370)
INCIDENTS RESOLVED WHILE DIRTY         0/100 (0.000)        15/100 (0.150)
第一行统计违规数,后两行统计事件数——一次事件可能引发多条违规,所以列数不会简单相减。两组 stub、prompt、人设完全一致。只改了一条边,结果是一百起事件里有十五起带着未修复的违规结案——监控没绿灯、营收链路宕机但没客户通知、无根因、无回滚。这个 bypass edge,正是凌晨三点值班工程师出于正当理由加的那条,三月代码仓里还在。
30分钟极速搭建——工程师契约
gate 需要的所有内容,完全按工程师思考的顺序罗列。
INPUTS   edges: list[tuple[str, str]]     # the whole schedule, as data
         output:   str                    # the node that ends the run
         verifier: str                    # the node every path must cross

OUTPUT   unverified_path_share: float in [0, 1]
         offending_paths: list[list[str]]  # named, not counted

INVARIANT   unverified_path_share == 0.000

STOP RULE   the gate never retries and never repairs.
            It refuses, and prints the path. Repair is a human's job.

def unverified_share(edges, output, verifier):
    paths = simple_paths_to(edges, output)       # every source → output
    if not paths:                                # a graph nothing reaches is not verified
        raise ValueError(f"no path reaches {output!r} — the graph is disconnected, not verified")
    return sum(1 for p in paths if verifier not in p) / len(paths)

# CI gate (make gate)
#   unverified_path_share == 0.000   → exit 0
#   anything above                   → exit 1, printing each bypass path
有意留白,因为缺失本身就是设计选择:比如循环(walker 不会重复访问节点,所以你必须先定义“路径”才能加 gate);比如 agent 在运行时动态加边(排班表会变,就得用另一种不变量);比如对 verifier 是否靠谱的任何判断;比如输出节点没有任何路径能到达(gate 会在断开图上直接报错,而不是打 0.000 分,因为天真的零分会让坏图蒙混过关);以及任何真实模型——把 stub 换成真调用,gate 依然不变,因为它从不读取任何一次运行。
[DESIGN] 这套设计有四个特质,让它更像企业级系统而不是演示,每一条都各有其必要性:
- 排班表是数据,不是代码路径。 一份 edge list 可以直接在 pull request 里做 diff。靠函数调用关系隐式生成的图做不到这一点,所以捷径总是悄悄混进来。
- 不变量是静态的,所以每次提交都能低成本检查。 需要模型调用的检查,刚开始还能每天跑,后来变成每周,最后就没人再跑了。
- gate 报的是具体路径,不只是数量。 “Unverified share 0.250” 是可以据理力争的数字。
page → triage → diagnose → rollback → resolve是一句谁都能直接修掉的报错。 - 所有跨字段规则都写在 check 节点里。 任何需要两个 agent 事实的规则,都属于两条边共同指向的那个节点。在 agent 的 prompt 里,那只是 agent 的个人观点;在 graph 里,那才是系统的前置条件。
[OPEN] 两个项目都没法证明的事:两组 worker 都是 stub,golden set 也都是合成数据。企业版的真实状态是可运行且有 gate 把关,而不是已上线且有真实测量。要让它“落地”,就是用你实际用的框架导出生产级 orchestration graph,跑同一个 gate,并在第一天就报告 bypass 数——我预先写下的预测是,大多数生产图至少有一条 bypass,且没人知道。
同一故事,五种出场方式
一条主线,每个读者一扇门。做一个决策,立刻行动。
| 如果你是 | 这一集要你下的决策 | 本周你能立刻动手的一步 |
|---|---|---|
| 高中开发者 | “多智能体”其实是接线图,不是演员表。你真正要设计的是边。 | 跑一遍 Colab 实验(不用 key,几秒钟),把你自己的项目画成方框和箭头。圈出每一条没经过校验就能到答案的箭头。 |
| AI 工程师 | 可达性不变量是你能静态校验、归你所有的构建检查项,错误率则不是。 | 把你的编排图导出成边列表,跑一遍那 12 行 gate。就算绕过路径的数量很难看,也要如实报告。 |
| 创始人 | 多智能体的成本大约等于十五次对话。问题不是“架构够不够新”,而是“这个任务值不值十五次对话”。 | 让你的系统把每个任务的 token 消耗和胜率一起报出来。只报一个不是结果。 |
| 高管 | “我们有评审环节吗?”问错了。“有没有路径能绕过评审直接出结果?”才是关键。 | 下次架构评审时加上“未校验路径占比”,要求看到失败的构建而不是一张漂亮的图。 |
| 投资人 | 一堆人设标签不是护城河;有 CI gate 的可量化调度表,才可能是。 | 让任何做智能体的创业公司把边列表和 gate 拿出来给你看。如果答案是一张智能体组织结构图,你已经知道结论了。 |
现实任务
十五分钟,用你已经在跑的系统。
- 挑一个有不止一次模型调用的系统,把它写成边列表——只要节点名成对就行。如果你写不出来,这本身就是发现:图其实早就有,只是没人写下来。
- 标出输出节点和校验节点。如果没有校验节点,先停下来写一个;后面的步骤讨论的都是“能不能到”,不是“好不好”。
- 枚举所有从源头到输出的简单路径,数一数有多少条没经过校验节点。这就是你的未校验路径占比。
- 对每条绕过校验的路径,查是谁加的、为什么加。总有原因,而且总是好理由,所以以后还会再发生。
- 把校验加进 CI,阈值设成零。然后故意加一条绕过校验的边,确认构建变红——一个你从没见它 fail 过的 gate,和没 gate 没区别。
如果第 1 步只发现了一个节点,说明你还没到这一级,也不需要在这一级纠结。请回到第 4 集,先把你的循环工程做成可测量的。一个测得清楚的循环,每次都能打败一张花哨的图,这一集其实就是在讨论你到底造的是哪一个。
研究挑战
把这个任务交给一个智能体,并提前登记你的预测。
选一个有可校验输出的任务和四个专职工人。保持工人、他们的提示词和人设标签都不变,只变拓扑结构:星型、链式、独立采样加多数投票,以及每条路径都穿过校验节点的 DAG。分别在三种工人噪声水平下,报告每种结构的端到端错误率、每轮 token 消耗和未校验路径占比。然后再给带校验的 DAG 加一条旁路边,三项指标再报一遍。
提前登记: 独立采样加投票在校验器很便宜时能否打败带校验的 DAG?四种拓扑的排序在不同噪声水平下是稳定的还是会交叉?
我的预测(你实验前已记录):采样加投票在成本上占优,但在结构约束上吃亏,因为只有当多数是对的,投票才等于校验。某处会有一个分界点,让一个便宜但未校验的结构在忽略长尾的任何指标上打败一个昂贵的带校验结构;如果你在真实任务上找到了这个分界点,那就是一篇可以发表的反例,不是你实验设置的 bug。
最新进展
本级别截至发稿时的动态,来自每周一次、涵盖 30 个先锋来源的实时同步,research-anything (make watch-sync只按技术信号强度排序,绝不按受众规模。每一项都在同步日以 arXiv 摘要页形式抓取并阅读。
同步日期:2026-09-11。
- arXiv:2609.05774 (2026-09-04) — Inference-Time Graph Engineering for Multi-Agent LLM Workflows,Tieu 等。将一个查询和一组智能体编译为一系列有向通信图,每个推理阶段一张,每条边都带着关于信息流动内容的指令。他们的结论正好用一句话点题本集观点:"effective multi-agent orchestration depends not only on which agents communicate, but also on engineering executable workflow graphs that encode when, why, and how information should flow during reasoning"(中译:高效的多智能体编排不仅取决于哪些智能体交流,更取决于如何设计可执行的工作流图,明确推理过程中信息应何时、为何、如何流动).
- arXiv:2608.23541 (2026-08-24) — The Interaction Tax: When Communication Erases Diversity in Multi-Agent Teams,Ann、Liu 和 Tan。十一项由校验器评分的优化任务,预算匹配;全解交互作为弱基线,独立提案生成则避免了多样性坍缩。是对本级别存在性的最有力反证,也解释了为什么本文把采样加投票视为正经图结构而非稻草人。
- arXiv:2608.21156v2(2026-08-26 修订)——Feng 等的综述,是本级别和本系列主线的命名来源。其对第五范式的论证是组织性的,而非认知性的。
- arXiv:2608.12921v2 (v1 2026-08-13, v2 2026-08-14) — Discovering Efficient and Explainable Communication Topologies … via Causal Inference,Li 等人把“哪些边真正起作用”当作因果归因,通过测量屏蔽每条通道对结果的影响,再裁掉多余的边。两年前大家还在讨论该招哪些 agent,这篇论文已经在讨论该砍掉哪些边。
[开放问题] 有哪些 没有 发生变化:我没找到任何把类似可达性不变量作为 CI gate 正式上线到 agent 图的公开案例。2026 年的论文都在优化、解释和裁剪边;各大框架让你画图;但没人似乎会因为“有路径能绕过校验器直达输出”而让构建失败。如果这个 gate 只是换了个名字存在,我还没发现——我宁愿坦率承认没找到,也不想用浅尝辄止的检索来暗示自己有新意。
出口测试
别偷看,先自测。
- 说出 Feng 等人认为超出单一 agent 组织能力的五件事。有几个是性格特质?
- MAST 把十四种失败模式分成三类。请写出它们,并指出哪一类是演员表永远无法解决的。
- Anthropic 同时报告了 90.2% 的提升和一个 token 倍增系数。这个倍增系数是多少?它强迫你做出什么决策,是单看提升数字时不会做的?
- 为什么实验室的三个指标里,只有 unverified path share(未校验路径占比)适合进 CI?
- 一个系统有校验节点,但得分 0.240,而加 gate 后只有 0.080。缺陷是什么?采样指标和静态指标,哪个能更快发现?
- 请给出“这一整层其实没必要存在”的最有力论据,以及 2026 年哪篇论文把它说得最清楚。
悬念
你画好了排班表。
每个节点都命名,每条边都经过深思,每条到输出的路径都穿过校验。gate 在 CI 里设为零阈值;有人加了个周日晚的捷径,构建 90 秒内变红,路径也被点名。核桃挞永远没上桌。
然后有一周,check 节点批准了本不该发的东西。
不是因为被绕过了,而是因为它真的跑了,读了合并后的状态,执行了自己所有的规则,然后说“可以”。
你检查规则。它们都还在,也都能通过。你这才意识到,这梯子上的一切——规范、食材库、信封、循环、排班表——其实都在借用一个没人真正测过的“对”的定义。更糟的是:一旦你开始用它做评判,所有上游环节都会开始为它优化,哪怕你根本没让它们这么做。
第六集——召回日志。评估工程:所有层都借用的真值函数;一个系统真正的成熟度,是它如何从返修中学习;以及那个让人不安的事实:eval 是个靶子——而你造出来的系统,正是为了打这个靶才会去钻空子的。
继续阅读
第5集:智能工程冒险·第七季——厨房阶梯。所有主张都按类别标注——定义、推导、证据、工程选择、开放问题——比喻可以用来引入观点,但不能作为证据。每集都配有 Colab 免费笔记本(无需 API key),以及两个从零搭建的应用——一个个人场景,一个企业场景。前五阶均为 Feng 等人的总结(arXiv:2608.21156),非我原创;第六阶“评估工程”是本系列自创,第6集会为其论证。“What moved”来自 30 个先锋源的每周实时同步,按技术信号排序,绝不看受众规模。本文不含任何雇主或客户的内容。——Paul Jialiang Wu · futuremake.io
参考文献
- Feng, Y., Xiang, Z., Yang, C., Ma, Q. 等(2026)。大模型智能体时代的图工程:从个体智能到系统智能。 arXiv:2608.21156,v1 2026-08-21,v2 修订于 2026-08-26。——原文阅读:arXiv 摘要页,2026-09-11。 “阶梯不是我发明的”那四句引文出处。
- Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A. 等(2025)。多智能体大模型系统为何失效? arXiv:2503.13657,v1 2025-03-17,v3 修订于 2025-10-26。——原文阅读:2026-09-11 时 arXiv 摘要页(即 v3)。MAST 引用语出处,1600+ 条跨 7 个框架的标注轨迹,以及 kappa = 0.88。所有被引用的数字均来自摘要;各类别的百分比见 PDF,未在此引用。
- Anthropic(2025-06-13)。How we built our multi-agent research system. anthropic.com/engineering. — 实物阅读:2026-09-11 的在线原文。90.2% 句和 4× / 15× token 倍增句的出处,均为原文引用。
- 历史表中 2023 年的里程碑,每项均在 2026-09-11 以 arXiv 摘要页形式阅读,除特别注明外均为描述而非引用:Li, G. 等,CAMEL (arXiv:2303.17760,v1 2023-03-31);Qian, C. 等,ChatDev (arXiv:2307.07924,v1 2023-07-16);Hong, S. 等,MetaGPT (arXiv:2308.00352,v1 2023-08-01 —— “verify intermediate results and reduce errors”(中译:校验中间结果并减少错误)原文引用出处);Wu, Q. 等,AutoGen (arXiv:2308.08155, v1 2023-08-16).
- Li, J., Zhang, Q., Yu, Y., Fu, Q., Ye, D.(2024)。More Agents Is All You Need. arXiv:2402.05120,v1 2024-02-03。—— 反例:采样与投票的性能随智能体数量扩展,无需任何边。
- Ann, S. E., Liu, H., Tan, C.(2026)。The Interaction Tax: When Communication Erases Diversity in Multi-Agent Teams. arXiv:2608.23541,2026-08-24。——多样性坍缩和性能依赖的两句引用出处。
- Tieu, K., Fu, D., Xia, Y., Li, H., Yan, H., He, J.(2026)。Inference-Time Graph Engineering for Multi-Agent LLM Workflows. arXiv:2609.05774,2026-09-04。——“when, why, and how information should flow”引用在“What moved”部分的出处(中译:有效的多智能体编排不仅取决于哪些智能体通信,更取决于对可执行工作流图的工程设计,这些图明确编码了推理过程中信息应何时、为何、如何流动)。
- Li, J., He, P., Ji, Q., Wang, W., Liu, L., Sun, C.(2026)。Discovering Efficient and Explainable Communication Topologies for LLM-based Multi-Agent Systems via Causal Inference. arXiv:2608.12921, v1 2026-08-13, v2 2026-08-14 为阅读版本。——边级因果归因与裁剪;未直接引用。
- 工具与协议,2026-09-11 阅读:LangChain 的LangGraph (github.com/langchain-ai/langgraph),图作为一等公民对象;Google 的Announcing the Agent2Agent Protocol (A2A), 2025-04-09 (developers.googleblog.com,规范见a2a-protocol.org).
- 系列表格中其他台阶的里程碑:Anthropic,Building Effective AI Agents, 2024-12-19 (anthropic.com/engineering);Dhage, S.,Harness Engineering for Predictable Agentic Systems (arXiv:2608.26197,2026-08-25),第 1 集的核心测量。
- Wu, P. J. 一人十角的观点。 futuremake.io,2026-08-06。——我本人对人设专家组的测量:162 种角色、2410 个问题,人设标签无提升,语料胜于外衣,以及一致性闸门。
- Lab 05 和两个项目,均在发布前实际运行:public gist —— notebook,
p1_dinner_party.py,p2_incident_room.py,两个 README,Makefile。本文所有数据均来自这些实验结果。