AI-Native 系列 · 智能体工程 · 循环工程实战
不会说谎的 AI PR 审查器
每条结论有证据,“unmeasured”必须明示,自动合并有路径包络。这是一份来自人类审查已成瓶颈仓库的构建报告,既写给提出需求的联合创始人,也写给任何准备把合并按钮交给模型的人。
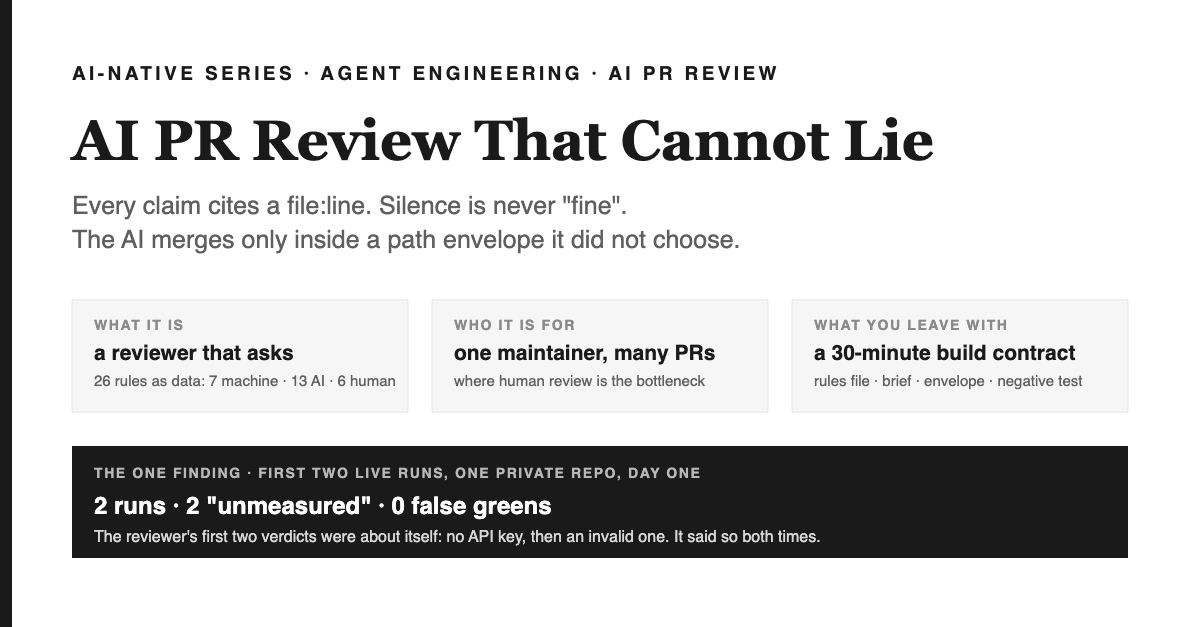
速览要点
这是什么 一份 AI PR 审查的构建报告,AI PR 审查 针对一个制造业质量管理代码库,这个库里每个 PR 都是同一个维护者合并,且从未有过任何审查。模型会读取每个拉取请求,并发布一份简报。它不能凭自己判断批准,不能在没有文件和行号的情况下下结论,也不能在无法运行时保持沉默。
为什么这件事值得关注。 对工程师来说,一个会凭空编造问题,或者失败时选择沉默的 AI 审查员,比没有审查员还糟糕——它只会让团队学会无视它。对创始人来说,「auto-merge」本质上是爆炸半径的决策,而不是模型质量的选择,这个设计把爆炸半径写进了模型无法编辑的数据文件里。对学生来说,这就是那个把闸门和装饰品区分开的关键习惯的实操案例:在信任它的绿灯之前,先要让它故意变红。
读完你可以怎么做。 只需 30 分钟即可复刻这个结构:一份三层(机器、AI、人类)的规则文件,一个带证据过滤器的八段式简报,一个带 deny-wins 语义的路径包络,五个 AND 条件的自动合并,以及上线前必须跑的负向测试。「30 分钟搭建指南」 是这份合约;而 day-one 那节展示了在坏 key 下合约如何成立。
本文讲了什么,以及为什么 AI PR 审查需要完全不同的设计
这是一周工作的小结。团队共建时,大家一致认为「人工 PR 审查」是迭代速度的唯一瓶颈,于是给了我两个当天要交的任务:在仓库上部署自动审查员,并写下它要执行的审查标准。这个仓库是工厂用的质量管理系统(QMS),每条记录日后都可能被客户审计时拉出来当证据。这让审查的风险点变得非常具体:合并进来的 bug 不再只是 bug,而是伪造记录。
设计的核心问题不是「模型能不能审查代码」——模型已经能审查得够用了。真正要问的是,AI PR 审查必须被禁止做哪些事,才能让团队在第十个 PR 之后还愿意信任它。我的答案是四条禁令加一个包络,整篇文章就是围绕这五条和它们的证据展开:
- 审查员不能在没有
file:linecitation 的情况下下结论。没有证据的结论会被丢弃,丢弃的数量会在简报里明示。 - 审查员不能选择沉默。没有 API key、模型拒绝、API 报错:每种情况都会发一条评论,写明「unmeasured」和「this is not 'no problem'」(中译:这不是“没问题”)。
- 脚本已经判定的内容,审查员不能再重新判断。租户隔离、密钥、迁移、外键、双语文档、测试和黄金用例库,这些都直接从计算它们的脚本原样附在简报里。
- 只需人工判断的列表不能留空,除非给出理由。「没有需要人工判断的项」必须带上原因,否则就等于「审查员根本没跑」。
- 审查员只能在自己无法选择的路径包络内触发合并,并且只能作为五个 AND 条件之一。
适用读者:一人维护多 agent 的 AI 工程师;需要决定「auto-merge」能影响哪些内容的创始人;想看闸门如何变得诚实而不是装饰的学生。比喻在问题之后,借用另一个领域的画面:餐厅厨房里,一道菜出门前要经过三道关。
瓶颈,先量后动
在提出审查员方案前,我先拉了仓库自己的数据,因为「审查慢」和「根本没审查」需要完全不同的解法。24 个已合并 PR,全部出自同一个人,23 个是作者自己合的。我抽查的 8 个 PR,审查记录为零。其他贡献者的 9 个未合并 PR,全都没人审查,最老的等了 16 天。历史上的合并中位时间是 6 分钟,这不是审查快,而是作者自合。
还有两点直接影响了设计。上个月 CI 静默挂了 11 天,每个 job 两秒就死、一步没跑,因为账户的 Actions 分钟用光了,但没人发现——远看「红但没步骤」和「红因为失败」长得一模一样。仓库又是免费私有计划,完全没有分支保护:任何绿 PR 或红 PR,任何人都能合,唯一的防线是记忆力。
Google 的一项内部实践研究,分析了 900 万次代码审查变更的日志[5];而一次都没跑过的流程,既没有日志,也学不到任何东西。实际情况是,审查流程一次都没跑过,马上要通过一个人接收 9 个外部 PR,仓库没有任何强制层。偶尔幻想出问题、偶尔静默失败的审查员,会落到一个根本没养成检查习惯的团队手里。这就是为什么先有禁令,后有 prompt。
思维模型:餐厅厨房的三道关
整个设计的底层逻辑,其实可以用厨房的三道工序来类比——这就是“开餐厅”的那一层分工。真正的厨房里,一道菜要经过三道关卡才能出门,这三关不是层层加码,而是各司其职,各有侧重。
| 厨房里的流程 | 代码仓库里的流程 |
|---|---|
| 秤、温度计、点菜单检查。秤没有主观意见。只要重量不达标,无论是谁做的,这道菜都不能出门。 | 机器闸门 G1–G7。已经存在的脚本:租户与权限 AST 检查、密钥格式扫描、模型与迁移配对、外键证据链、双语文档配对、测试、黄金用例库。在分支保护下,红色会让合并按钮变灰。 |
| 副厨尝酱料,写下便条:“第三勺盐偏多,今晚要不要出菜你定。” 这张便条指的是哪一勺,不是心情如何。 | AI 预审 R1–R13。每个 PR 一份简报。每条发现都必须有出处file:line。它只问人才能回答的问题,并给出一个自己无法执行的建议结论。 |
| 主厨读便条,尝那一口,然后决定这道菜能不能出。 | 仅人类可判定 H1–H6。业务场景、责任人、审批节点、关闭标准、KPI 定义、现在合并。代码所有者只需回答简报里提到的内容。 |
| 冷盘和酱料副厨尝过的可以直接出,不必主厨再过目,因为酱料错了顶多重做,不会赔钱。 | 一级自动合并。文档、方案、测试文件、黄金用例:按路径划分,爆炸半径小。只要再满足四个条件,机器人就会批准并开启自动合并。 |
| 热菜线永远等主厨。永远如此。副厨再有把握,也绝不会对牛排说“直接上”。 | 应用代码、迁移、CI、脚本、前端源码永远不在 envelope 里。AI 对它们的看法只是输入,不能直接触发合并。 |
厨房分三道工序,评审也是同理。只要副厨的便条变成了出菜的决定,厨师们就会开始“写给便条看”;只要 AI 的结论变成了合并条件,贡献者就会写出“讨好 AI”的 PR。让便条只做便条,让秤只做秤,这才是让两者都能保持诚实的关键。
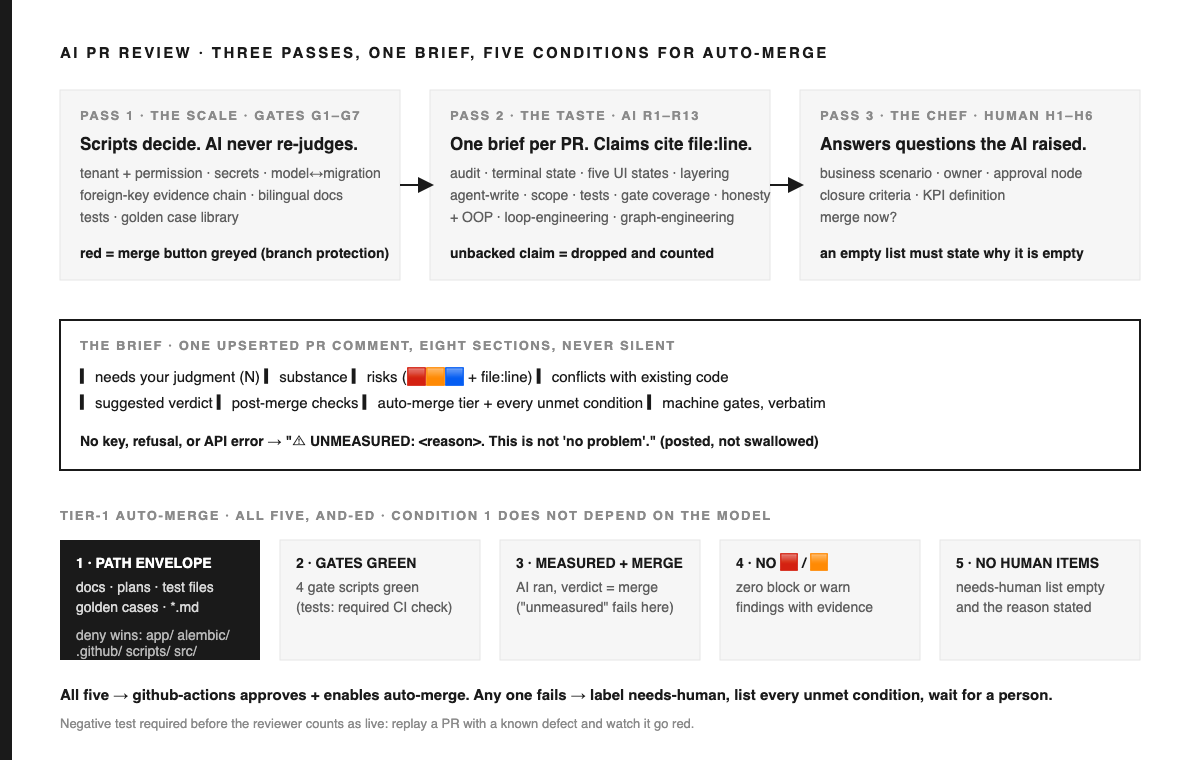
机制全览:审查员绝不能做的四件事
1. 没有文件:行号的结论,一律不许说
模型输出是受JSON schema约束的结构化对象[4]:每条发现都包含规则ID、严重性、结论,以及一个evidence数组。渲染前,过滤器会遍历所有发现,只保留证据字符串匹配path:line的项,且路径要么在PR变更文件中,要么在该commit的仓库里存在。没有任何有效证据的发现会被移除,计数器加一。简报最后会写明:“N条没有file:line证据的结论已被丢弃”。
有两个细节很关键。路径可以指向PR没动过的文件,因为“这与现有代码冲突”恰恰是那种证据只在旧文件里的发现;如果只允许diff里的证据,反而会删掉最有价值的那类问题。还有,丢弃的数量是明明白白打印出来的,不是藏起来——一个悄悄扔掉一半输出的审查员,其实是在告诉你它的校准情况,这你肯定想看到。
系统提示词一句话说清:没有证据的结论会被系统丢弃,所以宁可少说,绝不编造。过滤器让这句话不是空头承诺,而是真正落地。
2. 未测量必须明示,绝不能默不作声
最初版本的简报,在没有API key时,只打印了machine gate的结果,其他什么都没有。看起来像是“没有异议”的审查员。这其实是审查员能输出的最危险结果,因为从外部看,“我没发现问题”和“我根本没跑”是同一句话。
修正方法是加一个绝对不会被跳过的分支。如果没有凭证、模型返回拒绝、API报错、结构化输出解析失败,简报就会渲染一个“unmeasured”区块,写明具体原因,接着一句“this is not 'no problem'”,再接machine gates和一条说明:所有human-only项现在都需要人来判断。工作流依然会把它发出去。每个关键短语都有单元测试钉死,重构时绝不可能悄悄恢复成静默版。
3. 机器闸门只挂结果,不许复判
一共七道闸门,G1到G7:AST遍历路由器做租户过滤和权限依赖检查;新增行的secret-shape扫描器(只报位置,绝不回显值);模型-迁移配对;每个*_id字段的外键检查;双语文档配对;测试套件;还有一个黄金用例库,要求确定性模块必须复现标准输出。审查员自己跑决定其中六项的四个脚本,因为提交闸门脚本一次性覆盖了secrets、迁移配对和双语文档;第七项测试套件在独立CI任务里跑,审查员不重复。简报里“machine gates”下会有四行脚本输出,覆盖G1-G5和G7。审查员记录最后六行输出的通过/失败,并把结果和指令一起交给模型:这些都已定论,别再复判。
原因不是模型会判错,而是确定性检查的“第二意见”纯属噪音,简报里的噪音只会让人不想读。微软那份现代代码评审的田野研究最常被引用,发现评审员主要精力花在理解上而不是找缺陷,摘要里这样说:
"Our study reveals that while finding defects remains the main motivation for review, reviews are less about defects than expected and instead provide additional benefits such as knowledge transfer, increased team awareness, and creation of alternative solutions to problems."(中译:我们的研究表明,虽然发现缺陷仍是评审的主要动机,但实际评审比预期更少关注缺陷,反而带来了知识传递、团队认知提升和问题替代方案等额外价值。)
—— Bacchelli and Bird,ICSE 2013,作者自存稿[6]
如果人类评审员大多是在建立理解,那么AI简报里重复一遍秤的读数,就是在浪费读者注意力在脚本早已定论的事上。模型的注意力应该用在脚本够不到的地方:比如收尾动作有没有写审计记录,创建端点能不能走到终态,路由器是不是在做业务逻辑,PR描述里的结论有没有贴证据。
4. human-only列表为空必须说明原因
简报第一节叫“needs your judgment”,是code owner唯一必须读的部分。如果它是空的,模型必须填一个原因字段,渲染时打印“empty; reason: …”。否则,空列表和模型根本没考虑这个问题是一样的。这其实就是第二条禁令在更细粒度上的应用:缺席绝不能承载任何含义。
规则即数据,以及三条变成规则的原则
26条规则全都写在一个JSON文件里,不在提示词也不在文档里。每条规则有id、层级、标题、检查内容、由哪个gate或人决定、以及溯源。文档页的表格由这个文件通过--render-rules命令生成,CI里还有一个--check-docCI 里有专门的命令校验:只要文档里的表格和文件渲染出的内容有一个字符不同,直接判失败。提示工程收到的也是同一份渲染表格。三方共用一个源头,完全无漂移。
七条规则属于机器层,每条都明确指定由哪个脚本决定;有测试确保这些脚本真实存在——毕竟这个仓库之前就有“文档写了密钥扫描器,代码却没写”的前科。六条属于人工层,直接取自项目自己的 15 项模块检查清单:比如“这个改动到底解决了哪个工厂里的实际问题”,这种问题光看 diff 是答不出来的。剩下十三条属于 AI 层。其中十条是项目工程规范里可以被自动检查的部分:关键动作的审计记录、创建端点无法直接到达终止状态、五个 UI 状态、路由器只做编排、每个 AI 可达写操作都要人工签字、单一职责、实现日志、变更纯逻辑的测试、闸门覆盖率、描述和证据一致。
最后三条是因为我的联合创始人要求“按我们的 OOP、循环工程和图工程原则来审查”,而只存在于聊天里的原则不算规则。所以:
| 规则 | 审查员检查的内容 |
|---|---|
| R11 OOP | 每个新类或函数只承担一个职责;优先复用已有的领域层和闭环层,避免复制粘贴;业务规则写成纯函数,可以脱离数据库测试;路由器只负责编排。 |
| R12 循环工程 | 每个新闸门、规则或自动化都必须有办法“故意让它变红”;状态机要有终止状态和回滚机制;任何判断都能用一条命令重跑;“unmeasured”要单独统计,不能和“passed”混在一起。 |
| R13 图工程 | 每个新*_id都要声明外键;跨模块的影响(比如投诉到供应商纠正、SPC 违规到工艺问题、退货到根因)必须通过闭环钩子流转,不能直接写在代码里;任何记录都能追溯到原始文档和负责人。 |
R12 就是本文自身的规则,所以后面两节专门讲它怎么落地。
边界归路径,不归信心分
团队的诉求是:只要 PR 达标,就能自动合并,不需要人卡点。早期设计则坚持 AI 绝不能成为合并条件。两边都各有道理,但解决方案不是折中,而是换了个变量。问“AI 的结论能不能直接触发合并”——无论答是或否都不对。问“哪里合并错了只是重做,不会出事故”——这是个数据问题。
边界由规则文件里的两组路径前缀列表决定。允许:文档、方案、黄金用例文件、测试目录,以及所有以.md结尾的文件。禁止(且禁止优先生效):workflow 目录、scripts 目录、应用包、migrations、前端源码、Makefile、两份 agent-guide 文件。workflow 目录下的 Markdown 文件也禁止。应用包下的测试文件也禁止。模型完全无权决定这份列表——它只在模型回答后被应用。
Tier-1 需要五个条件同时成立:所有变更路径都在 envelope 内;所有闸门脚本全绿(brief 里的四行;G6 测试套件是 GitHub auto-merge 自己等的必需状态检查);AI 审查已测且结论为 merge;block 或 warn 级别的 finding 为零(info 级别只展示不影响合并);human-only 列表为空。五项全中,workflow 就以 Actions 身份批准 PR,并启用 GitHub auto-merge,等所有必需检查过了自动合并。只要有一项不满足,PR 就会被打上“needs human”标签,brief 会列出所有未达标的原因,不止第一个。这个细节来自单元测试:最初实现遇到第一个失败就提前返回,导致贡献者修完“路径不在 envelope”后重跑,才发现还有 warn 级别的问题。三条原因就该打印三条。
有两个 GitHub 设置让 bot 的批准生效:仓库必须允许 Actions 批准 pull request[3],且分支保护[1]不能要求批准者必须是 code owner,因为 Actions 身份不是。Auto-merge 本身是 GitHub 的功能[2],workflow 只是启用它。code-owners 文件依然负责把审查请求分配给人。保护脚本默认只要求一次批准且不强制 code owner,应用后会把两个仓库设置都打印出来,因为免费计划会悄悄忽略 auto-merge 设置,而不读回的脚本就是在说谎。
上线第一天:审查员的前两次判决都是关于自己
workflow 以 PR 形式上线,那就是它审查的第一个对象。此时仓库还没配置 API key。brief 明确写着:“unmeasured: ANTHROPIC_API_KEY 缺失(仓库密钥未配置)。这不是‘没问题’。”下面是四个闸门脚本,全绿,tier 行写着 needs human,因为变更路径里有 workflow 和 scripts 目录,也因为 AI 审查未测。
我的联合创始人补上了密钥。下一个 PR,也就是加 envelope 的那次,是它审查的第二单。简报里写着:「unmeasured: AuthenticationError 401, invalid x-api-key.」分级行和前两个原因都一样,又多了第三条:平台拿到的密钥不是平台认可的密钥。
我把这作为 day-one 的结果记录下来,不觉得丢人,因为这正是设计在真实压力下的表现。如果 reviewer 两次都选择沉默,就会出现两个“看似已审、实则未审”的 PR。实际情况是,这两次都明确写明了 AI 没有运行、原因是什么、对人类意味着什么。机制没有自动合并任何一个;两次都在 envelope 之外,第二个条件也没通过。零假绿,这就是数字;范围是两次运行、一个仓库、一天。
同一天还出现了第二次静默失败,发生在更底层。分支保护是私有仓库的付费功能,已经升级购买。API 对付费升级连续十分钟轮询都返回 403,auto-merge 设置被打回为 false。保护脚本遇到这种情况会带着升级 URL 非零退出;绝不装作无事发生。账户层面的原因写这篇时还在排查,这就是最后一个条件的真实状态,之所以写在正文而不是脚注,和简报贴出「unmeasured」是同一个道理。
模式、反模式与第一性原理
成立的模式: 证据作为 schema 字段,按存在性过滤,并打印被丢弃的数量。失败状态单独渲染为小节,绝不以缺席表达。确定性检查直接附上脚本输出,不让模型复议。所有规则都集中在一个数据文件里,由同一个函数渲染进 prompt 和文档,CI 里做漂移校验。爆炸半径用路径前缀表达,deny-wins,模型回答后再应用。所有未满足条件都列出来,不止第一个。
被替换掉的反模式: 一个会自己批准的 reviewer。用省略某节来表达「没问题」的简报。用置信分数代替证据。规则既写在 prompt 又写在文档里各一份。缺凭证时静默跳过。遇到多个原因只报第一个的早返回。这些做法看似合理,但每一条都会让 reviewer 到第十个 PR 时更容易被忽略。
一句话的第一性原理: 一个 review 信号,只有在它的缺席和失败都可见、结论可以查证而不是单纯信任时,才值得读;本文剩下的内容,都是把这句话落实到 merge 按钮上。
30 分钟造出来
这是合约,不是代码。代码和仓库绑定,合约可以迁移。三十分钟是合约为复制表格到新仓库的读者设定的预算,不是我实际测的时间。这里的壳是一口气写完的,测试、两份文档和 day-one 跑完花了剩下的时间。
| 要素 | 规范 |
|---|---|
| 输入 | PR 相对于 merge base 的 diff,按风险排序(应用代码优先),字符数有上限,所有被省略的文件都在简报里按名列出。PR 的标题和正文。每个已有 machine gate 的通过/失败和最后六行输出。从规则文件渲染出来的规则表。 |
| 输出 | 一个结构化对象:needs_human[] 包含 rule、question、why;needs_human_empty_reason; substance; risks[] 以及conflicts[] 包含 rule、severity(block、warn、info 三选一)、claim、evidence[];verdict 属于 {merge, hold, request_changes} 之一;verdict_reason; post_merge_checks[]; global_notes[]。渲染为一条 Markdown 评论,分八个小节(needs your judgment、substance、risks、conflicts、verdict、post-merge checks、auto-merge tier、machine gates),带隐藏标记,方便重跑时编辑而不是追加。 |
| 不变量 | 每一条被渲染出来的发现,至少要有一条符合 path:line 的证据字符串,且路径必须真实存在。每次运行(包括失败)都要发布简报。机器闸门的结果原样附上。人类专属列表为空时,必须写明原因。 |
| 终止规则 | 每个 PR 事件只调用一次模型。遇到拒绝或解析失败不会重试,这些情况会直接变成“unmeasured”。即使出错,流程也会继续,这样审查器宕机时能被看见,但永远不会阻塞合并。 |
| 最小 schema | 一份规则文件:{id, level ∈ {block, ai, human}, title, check, gate, source}(机器层在文件里写作 block,紧跟它对合并按钮的作用)加上 auto_merge: {allow_prefixes, allow_suffixes, deny_prefixes}。这就是全部配置面。 |
| CI 阈值 | 只有五个条件全部满足时才会自动合并。文档漂移检查(--check-doc)是必需的静态闸门。审查器自己的 job 不是必需检查项。 |
| 有意缺省 | 没有重试,没有第二个模型做裁判,没有置信分(发现要么有证据要么被丢弃),没有按规则加权,没有从历史 PR 学习。这些都是第一版可以变得更聪明、但会失去可审计性的地方。 |
| 负向测试 | 上线前:重放一个已知有缺陷的 PR。在本仓库里,候选是修复“create endpoint 能直接接受 closed 状态”的那次;把那三个代码文件回滚,必须能产出一条指向 router 的 block 级别 R2 发现。不能红的审查器不算上线。这一步等有效 key。 |
# The whole loop, from a PR event
diff, omitted   = collect_diff(merge_base, changed_files)      # risk-ordered, capped, omissions listed
gates           = run_machine_gates(base)                       # scripts decide; last 6 lines kept
review          = call_model(meta, files, diff, gates, rules)   # structured output, one call, no retry
review, dropped = filter_findings(review, files)                # path:line or it is gone; count kept
tier, reasons   = classify_tier(brief, envelope)                # five conditions, all reasons listed
brief           = render_brief(...)                             # never silent; unmeasured is a section
post_comment(pr, brief); apply_tier(pr, tier)                   # upsert; approve + auto-merge only on tier-1
同一故事,五种出口
| 读者 | 唯一的决策 | 唯一的行动 |
|---|---|---|
| 学生 | 只有你见过它变红,闸门才算是闸门。 | 把你依赖的任何检查器,故意让它检查的东西出错,确认它能报错。如果不能,那只是个摆设。 |
| 工程师 | 证据是结构约束,不是提示工程里的请求。 | 给你的 reviewer 输出加一个 evidence[] 字段,按 path:line 是否存在过滤,并打印被丢弃的数量。 |
| 创始人 | 自动合并其实是爆炸半径的决策;把半径写进数据文件。 | 先写允许和拒绝的路径列表,再写 prompt,并让拒绝优先生效。 |
| 管理者 | “有评审”和“评审已执行”是两回事;要量化后者。 | 要求统计零评审记录的 PR 数量,以及 reviewer 报告“unmeasured”的次数。 |
| 投资人 | 能给你看 reviewer 在埋雷缺陷上变红的团队,才有评审流程;只给你看绿灯截图的团队,只有截图。 | 要求看负向测试。 |
哪些已经被测,哪些还没测
- 已测。 14 个单元测试锚定了证据过滤器、unmeasured 渲染、envelope 的 deny-wins 语义、五条件分层逻辑及其累计原因、还有文档漂移检查。两次真实 PR 的线上运行产出了两份“unmeasured”简报,零静默输出。两次都因列出的原因被判定为 needs-human。
- 未测。 负向测试(埋雷缺陷应产出 block 级发现)已作为 PR 打开,待有有效 key 后运行;在它变红前,reviewer 只是装好了,按自身规则还不算“上线”。Tier-1 正向路径(仅文档 PR 被 bot 审批并合并)卡在分支保护,分支保护又卡在账号套餐问题。AI 在真实代码上的发现精度还没有数据;证据过滤器只是下限,不是测量。
- 举例。 厨房。它是一一映射的模型,不是数据。
延伸阅读
属于AI-Native 系列 · 智能体工程。本文所有数字仅在文中出现的范围内有效;厨房只是一个比喻,不是实际测量。规则文件、评审器、工作流、保护脚本和测试都在一个私有仓库里;上文已完整复现其结构,无需访问原仓库。
参考文献
- GitHub Docs.About protected branches. docs.github.com——受保护分支的必需状态检查、必需评审,以及私有仓库保护功能的可用性。
- GitHub Docs.Automatically merging a pull request. docs.github.com——Tier-1 所依赖的 auto-merge 行为。
- GitHub Docs.Managing GitHub Actions settings for a repository. docs.github.com——允许工作流批准拉取请求的相关设置。
- Anthropic.Structured outputs. docs.anthropic.com——证据过滤器所处理的 schema 约束响应。
- Sadowski, C., Söderberg, E., Church, L., Sipko, M., Bacchelli, A. (2018)。Modern Code Review: A Case Study at Google. ICSE-SEIP, DOI 10.1145/3183519.3183525. research.google · author's copy (PDF) ——文中为描述,非引用:12 次访谈、44 人问卷,以及 900 万次代码评审日志分析。
- Bacchelli, A., Bird, C. (2013). Expectations, Outcomes, and Challenges of Modern Code Review. ICSE 2013. author's copy (PDF) ——上文引用摘自该版本摘要,已逐字核对 PDF 原文;IEEE 正式发表版排版可能略有不同。