AIネイティブ・シリーズ · エージェント工学 · ループエンジニアリング実践編
嘘をつかないAI PRレビュー
主張ごとの証拠、「unmeasured(未計測)」は沈黙より優先、自動マージ用のパス制約。人間レビューがボトルネックだったリポジトリの構築レポート。依頼した共同創業者と、これからモデルにマージボタンを渡そうとしているすべての人に向けて書いた。
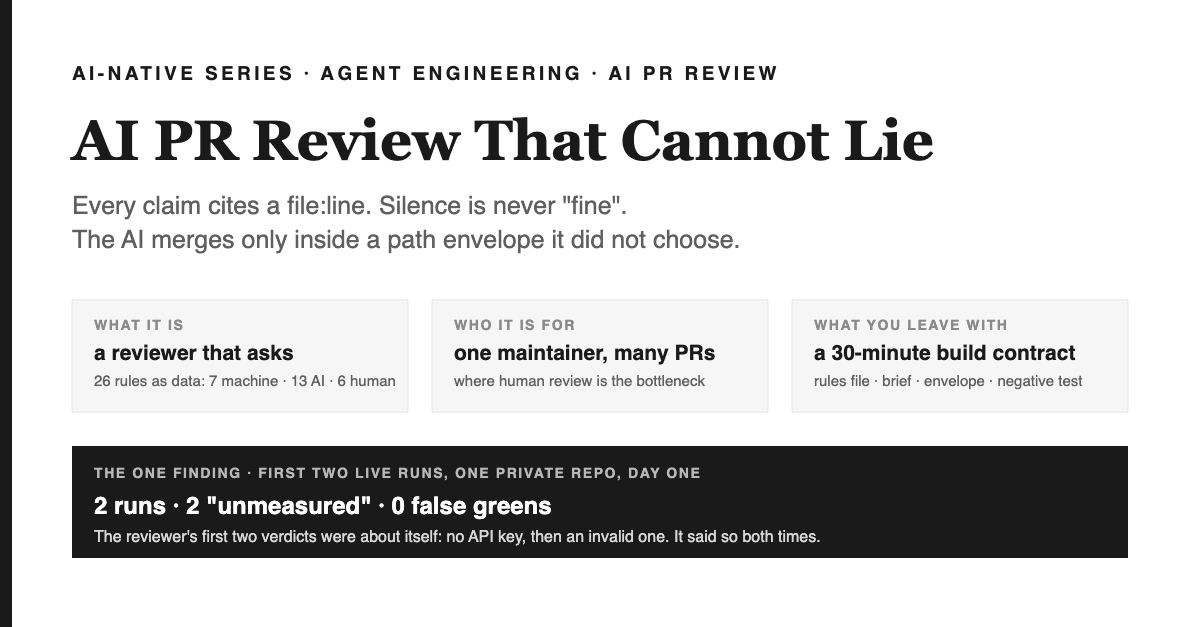
1分でわかる要点 —— 読後に持ち帰れるもの
これは何か。 製造業向け品質管理コードベースに導入した AI PRレビュー の構築レポート。すべてのPRを1人のメンテナーがマージし、レビューは一度も行われていなかった。モデルは各プルリクエストを読み、1件のブリーフを投稿する。自分の判断で承認することは禁止、fileとline番号なしで主張することは禁止、実行できなかったときに何も出さないことも禁止。
なぜこれが重要か。 エンジニアにとって、AIレビューアが根拠のない指摘を作り出したり、失敗したときに何も言わなかったりするのは、レビューアがいないよりも有害である。そうなると、チームはAIを無視するようになる。創業者にとって「自動マージ」はモデルの品質評価ではなく、被害範囲(blast radius)のコントロールであり、この設計ではその範囲をモデルが編集できないデータファイルとして明示している。学生にとっては、ゲートと飾りの違いを分ける唯一の習慣――信頼する前に意図的に赤を出す――の実例となる。
この記事を読んでできること。 30分でこの仕組みを再現できる:3層(マシン・AI・人間)のルールファイル、エビデンスフィルター付き8セクションのブリーフ、deny-wins方式のパスエンベロープ、自動マージのための5つのAND条件、そして本番前に必ず実行するネガティブテスト。「30分で作る」が契約であり、day-oneのセクションは「無効な鍵」でも契約が守られた場合の実際の出力例である。
このレポートの範囲と、なぜAI PRレビューには別の設計が必要なのか
これは1週間分の作業報告である。私が共同開発しているチームは「人間によるPRレビュー」がイテレーション速度の唯一のボトルネックだと特定し、同日に2つのタスク――自動レビューアの導入と、そのレビュー基準の明文化――を私に割り当てた。このリポジトリは工場向けの品質管理システム(QMS)で、すべての記録が後に顧客監査の証拠として引き出されうる。つまり、レビューの重みが特有の形で増す。マージされたバグは単なるバグではなく、虚偽記録となる。
設計上の論点は「モデルがコードレビューできるか」ではない。モデルは十分に実用的なレベルでコードレビューできる。問題は、AI PRレビューが10件目のPR以降もチームに信頼され続けるために、何を禁じるべきか、である。私の答えは「4つの禁止事項と1つのエンベロープ」であり、この記事全体はその5つとその根拠で構成されている:
- レビューアは、
file:line根拠(file:line)がなければ主張してはならない。根拠のない主張は破棄され、その件数がブリーフに明記される。 - レビューアは何も出さない状態を許されない。キー未設定、モデルの拒否、APIエラー――いずれも「unmeasured(未計測)」と「これは『問題なし』ではない」と明記したコメントを必ず投稿する。
- レビューアは、スクリプトが既に判定した内容を再評価してはならない。テナント分離、シークレット、マイグレーション、外部キー、多言語ドキュメント、テスト、ゴールデンケースライブラリは、それぞれを判定したスクリプトの出力をブリーフにそのまま添付する。
- レビューアは、人間専用リストを理由なしに空にしてはならない。「人間が判断すべきことはない」とする場合は必ず理由を明記しなければならず、なければ「レビューアが実行されなかった」と受け取られる。
- レビューアは、自分で選んでいないパスエンベロープ内で、かつ5つのAND条件すべてを満たした場合のみマージをトリガーできる。
想定読者:1人のメンテナーと多数のエージェントを運用するAIエンジニア、「自動マージ」の適用範囲を決める創業者、そしてゲートが単なる設置物でなく誠実に機能する様子を見たい学生。たとえ話は問題の説明の後に登場し、1つの領域――レストラン厨房で皿が出るまでの3段階――を例にしている。
構築前に測ったボトルネック
レビューアを提案する前に、私はリポジトリ自身の数字を調べた。「レビューが遅い」と「レビューが存在しない」では対策が異なるからだ。マージ済みPRは24件、すべて同じ人物が作成。23件はその本人がマージ。私がサンプルした8件のPRにはレビュー記録ゼロ。他のコントリビューターによるオープンPRが9件あり、すべてレビューなし、最古は16日放置。履歴上のマージ中央値6分は「速いレビュー」ではなく、単に本人が自分でマージしていただけだった。
さらに2つの事実が設計に影響した。先月、CIが11日間何も言わずに失敗し続けていた。すべてのジョブが2秒で終了し、ステップゼロ――アカウントのActions分が尽きていたためだが、外から見ると「ステップなしの赤」と「失敗した赤」は区別がつかず、誰も気づかなかった。そしてリポジトリは無料のプライベートプランで、ブランチ保護が一切なかった。つまり、緑でも赤でも誰でもマージでき、唯一の抑止力は記憶だけだった。
Googleが自社の実践を分析した研究では、900万件のレビュー済み変更のログが解析された[5]。一度も実行されていない運用には、そうしたログも学びも生まれない。実際の状況は、レビューが一度も走ったことのないプロセスが、9件の外部PRを1人経由で受け入れようとしている状態であり、強制力の層もなかった。たまにでっち上げをする、あるいはたまに黙って失敗するレビューアは、「確認する習慣のない」チームに着地する。だからこそ、禁止事項がプロンプトより先に来る。
頭の中のモデル:レストラン厨房の三段階パス
この設計を一枚の絵で表すなら、それは「レストランの厨房」だ。プロの厨房では、皿は三つの異なる工程を経て外に出る。その三工程は、厳しさの順ではなく、役割がまったく異なる。
| 厨房での流れ | リポジトリでの流れ |
|---|---|
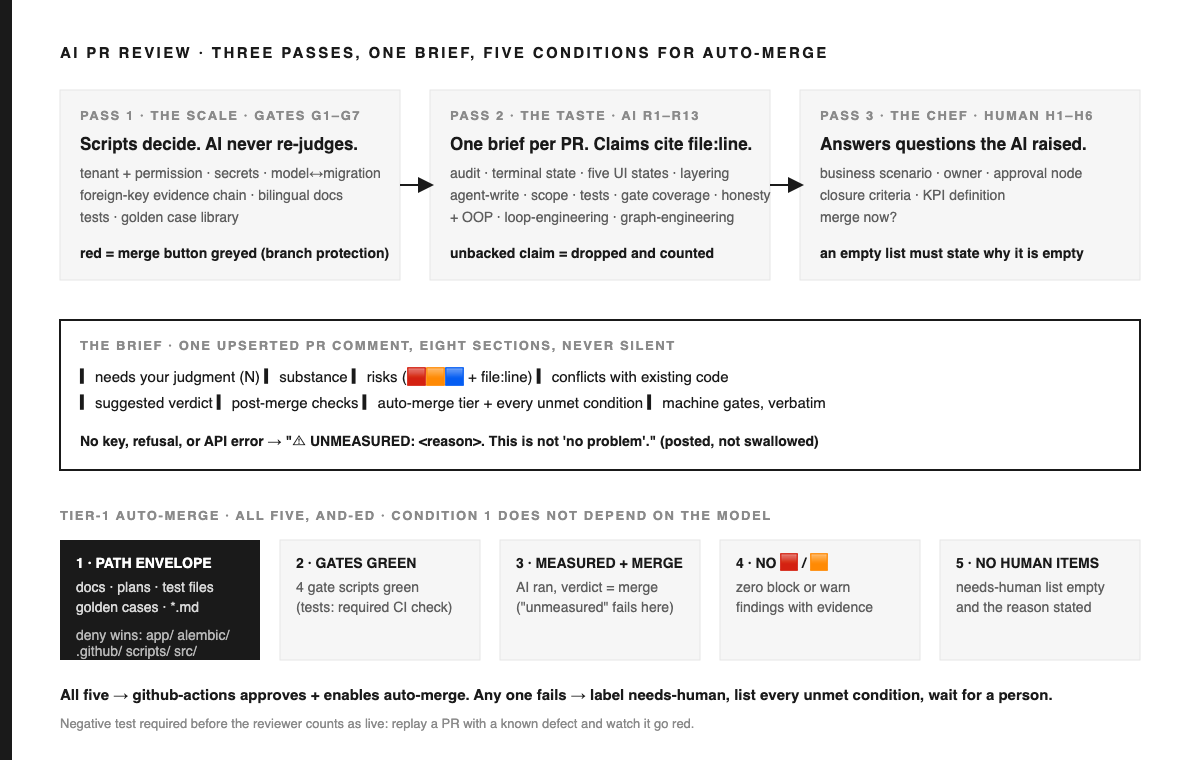
| はかり、温度計、伝票チェック。はかりは主観を持たない。重さが基準に達していなければ、誰が作った料理でも外には出せない。 | マシンゲート G1〜G7。既存スクリプト群:テナント・権限のASTチェック、シークレット形状スキャン、モデルとマイグレーションの対応付け、外部キーの証拠チェーン、多言語ドキュメントの対応付け、テスト、ゴールデンケースライブラリ。ブランチ保護下では、赤ならマージボタンがグレーアウトされる。 |
| 副料理長がソースを味見し、メモを残す:「三杯目のおたまは塩分が強い。今夜出すかどうかはあなたの判断。」このメモは気分ではなく、おたまという具体的な箇所を指している。 | AIによる事前レビュー R1〜R13。PRごとに1つのブリーフ。すべての指摘はfile:line根拠を明示する。人間にしか判断できない問いを投げ、AI自身が決定できない結論を提案する。 |
| 料理長がメモを読み、その一口を味見して、出すかどうかを決める。 | 人間専用 H1〜H6。ビジネスシナリオ、責任者、承認ノード、完了基準、KPI定義、即時マージ。コードオーナーはブリーフで挙げられた項目だけに答える。 |
| 冷菜やドレッシングは副料理長が味見したものは料理長を通さずに出せる。なぜなら、ドレッシングの失敗は作り直せば済み、返金にはならないからだ。 | 一次自動マージ。ドキュメント、計画、テストファイル、ゴールデンケースなど、パス単位でブラスト半径が小さいものに限る。さらに4つの条件が揃えば、ボットが承認し自動マージを有効化する。 |
| メインディッシュは必ず料理長の判断を待つ。例外はない。副料理長はいくら自信があっても、ステーキを「出していい」とは決して言わない。 | アプリケーションコード、マイグレーション、CI、スクリプト、フロントエンドのソースは自動マージの対象外。AIの意見は参考情報であり、トリガーにはならない。 |
厨房がこう動く理由は、レビューアーも同じだ。副料理長のメモがそのまま皿を出す条件になれば、料理人はメモのために料理を作り始める。AIの判定がマージ条件になれば、コントリビューターはAIを満たすPRを書くようになる。メモはあくまでメモ、はかりはあくまではかりとして扱うこと――それが両者の誠実さを守る唯一の方法だ。
仕組み:レビュアーが絶対にやってはいけない4つのこと
1. ファイルと行番号のない主張は却下
モデルはJSONスキーマで制約された構造化出力を返す。[4]各ファインディングは、ルールID、重大度、主張、そしてevidence配列を持つ。何かを表示する前に、すべてのファインディングをフィルターで走査し、path:lineに合致する証拠文字列だけを残す。ここでパスは、PRで変更されたファイル、またはそのコミット時点でリポジトリに存在するファイルでなければならない。証拠が一つも残らなかったファインディングは削除され、カウンターが増える。ブリーフの末尾には「ファイル:行証拠のないN件の主張は削除された」と明記される。
ここで重要なのは2点ある。パスはPRで触れていないファイルを指す場合がある。なぜなら「既存コードと競合している」という主張こそ、古いファイルに証拠が残る典型だからだ。証拠をdiffのみに限定すると、最も価値のあるカテゴリが消えてしまう。そして、削除数は隠さず明示する。なぜなら、レビュアーが自分の出力の半分を黙って捨てているなら、そのキャリブレーションの状態を知るべきだからだ。
システムプロンプトはこれを一文で伝える:「証拠のない主張はシステム側で捨てられるので、無理にひねり出すより控えめに述べよ」。このフィルターこそが、その宣言を希望的観測ではなく事実にしている。
2. 「未計測」は明示的に投稿される状態で、決して黙って済ませない
最初のブリーフ(APIキー未設定時)は、マシンゲートの結果だけを表示し、それ以外は何も出さなかった。まるで「異議なし」のレビュアーのように見えた。これはレビュアーが出しうる中で最も危険な出力だ。なぜなら、外から見れば「何も見つからなかった」と「実行されていない」は同じコメントに見えるからだ。
この問題の解決は、絶対にスキップできない分岐を設けることだった。認証情報がなければ、モデルがrefusal stop reasonを返せば、APIが例外を投げれば、あるいは構造化出力のパースに失敗すれば、ブリーフは「unmeasured」という見出しで正確な理由を記載し、「this is not 'no problem'」という一文を続け、マシンゲートの結果と「すべてのhuman-only項目は人間が必要」と注記する。ワークフローはそれでも投稿する。各フレーズはユニットテストで固定されており、リファクタで黙って元の沈黙バージョンに戻ることはない。
3. マシンゲートはスクリプトの出力をそのまま添付し、再判定はしない
ゲートは7つ(G1〜G7)存在する。ルーターのテナントフィルタ・権限依存のASTパス、追加行のシークレット形状スキャナ(値は絶対に出さず位置のみ報告)、モデルとマイグレーションのペアリング、各*_idカラムの外部キーゲート、バイリンガルドキュメントのペアリング、テストスイート、そして決定論的モジュールが標準出力を再現できるゴールデンケースライブラリ。レビュアー自身が6つの判定用スクリプト(シークレット・マイグレーション・バイリンガルドキュメントは一括)を実行し、7つ目のテストスイートはCIジョブで個別に走るのでレビュアーは再実行しない。したがって、ブリーフには「machine gates」下に4行のスクリプト結果が並び、これがG1〜G5とG7をカバーする。レビュアーは最後の6行の出力でpass/failを記録し、「これらは既に決定済み、再判定するな」とモデルに指示する。
理由は、モデルが間違えるからではない。決定論的なチェックに対する「もう一つの意見」はノイズであり、ノイズがブリーフに混じると人は読むのをやめる。Microsoftによる現代コードレビューの最も引用されたフィールドスタディは、レビュアーがバグ探しよりも理解構築に労力を割いていることを明らかにし、要旨でこう述べている:
"Our study reveals that while finding defects remains the main motivation for review, reviews are less about defects than expected and instead provide additional benefits such as knowledge transfer, increased team awareness, and creation of alternative solutions to problems."(訳:本研究は、欠陥発見がレビューの主な動機である一方で、実際には期待されたほど欠陥中心ではなく、知識移転やチーム認識の向上、問題への代替解決策の創出といった追加的な利点をもたらしていることを明らかにした。)
— Bacchelli and Bird, ICSE 2013, author's copy[6]
もし人間のレビュアーの主目的が理解構築であるなら、スケールの読み直しを繰り返すAIブリーフは、スクリプトが既に決着をつけた一点に読者の注意を浪費していることになる。モデルの注意はスクリプトが届かない領域、たとえばクロージングアクションが監査記録を書くか、createエンドポイントが終端状態に到達できるか、ルーターがビジネスロジックを担っていないか、PR説明の主張が証拠として貼り付けられているか、などに向けられるべきだ。
4. ヒューマン専用リストが空の場合は必ず理由を明記する
ブリーフの最初のセクションは「needs your judgment」であり、コードオーナーが読むべき唯一のセクションだ。これが空の場合、モデルは理由を補助フィールドに記入し、レンダラーは「empty; reason: …」と表示する。これがなければ、空欄は「モデルがそもそも検討しなかった」と区別できない。これは禁止事項2の原則をより細かく適用したものであり、「不在」に意味を持たせることは絶対に許されない。
ルールはデータとして管理し、3つの原則がルール化された
26個のルールはすべて1つのJSONファイルにあり、プロンプトやドキュメントには直接書かれていない。各ルールはID、ティア、タイトル、チェック内容、判定するゲートまたは担当者、そして由来元を持つ。ドキュメントページの表はこのファイルから--render-rulesコマンドで生成され、--check-docCIでこのコマンドを実行し、ドキュメント内のテーブルがファイルからレンダリングされたものと1文字でも違えば失敗する。プロンプトにも同じレンダリング済みテーブルを渡す。利用者は三者、情報源は一つ、ドリフトは起きない。
7つのルールがマシン層で、それぞれ判定用スクリプトを明記している。テストではそのスクリプトの実在も検証する。なぜなら、このリポジトリにはかつて「ドキュメントだけ存在し実装されていなかったシークレットスキャナ」があったからだ。6つはヒューマン層で、プロジェクト独自の15項目モジュールチェックリストから抽出した。「この変更は実際にどんな工場課題を解決するのか」といった問いはdiffだけでは答えられない。13個がAI層で、そのうち10個はプロジェクトのエンジニアリング原則から抽出した検証可能な残りかすだ。たとえば、重要アクションの監査記録、createエンドポイントから到達できない終端状態、5つのUI状態、ルーターはオーケストレーションのみ、AIが到達できる書き込みには必ず人間の署名、単一責任、実装ログの有無、純粋ロジックの変更にはテスト、ゲートカバレッジ、説明と証拠の一致、などがある。
最後の3つは、共同創業者から「OOP、ループエンジニアリング、グラフエンジニアリングの原則に従ってレビューしてほしい」とリクエストされたため追加した。会話の中だけに存在する原則はルールではない。だからこうした:
| ルール | レビュアーが確認する内容 |
|---|---|
| R11 OOP | 新しいクラスや関数には一つの責任だけを持たせる。既存ドメインやクローズドループ層を再利用し、コピーは作らない。ビジネスルールはデータベース不要でテスト可能な純粋関数で書く。ルーターはオーケストレーションのみを担う。 |
| R12 ループエンジニアリング | 新しいゲート・ルール・自動化には、意図的に赤にできる仕組みを必ず同梱する。状態機械には終端状態とロールバックを持たせる。どんな判定も1コマンドで再実行できる。「unmeasured」は「passed」とは別にカウントする。 |
| R13 グラフエンジニアリング | すべての新しい*_idは外部キーを宣言する。モジュール横断の効果(例:クレーム→サプライヤー是正処置、SPC違反→工程課題、返品→根本原因)はインライン記述せずクローズドループフック経由で処理する。どの記録も元ドキュメントと責任者まで遡れる。 |
R12は本記事自身が自分に課したルールであり、次の2セクションがその実践例である。
エンベロープ:パスで決める、信頼度は使わない
チームの要望は「基準を満たすPRは人を介さずマージしたい」だった。従来設計では「AIがマージ条件になるのは絶対NG」としていた。どちらも一理あるが、解決策はその中間ではなく、別の変数を立てることだった。「AIの判定でマージすべきか?」はどちらに振っても悪い答えになる。「どこなら誤マージしてもリメイクで済み、返金にならないか?」にはデータで答えられる。
エンベロープはルールファイル内の2つのパスプレフィックスリストで定義する。許可:ドキュメント、計画書、ゴールデンケースファイル、テストディレクトリ、そして.mdで終わるもの。拒否(deny)はallowより優先:ワークフローディレクトリ、スクリプトディレクトリ、アプリケーションパッケージ、マイグレーション、フロントエンドソース、Makefile、2つのagent-guideファイル。ワークフローディレクトリ配下のMarkdownファイルも拒否。アプリケーションパッケージ配下のテストファイルも拒否。モデルはこのリストを選択肢としては見ず、回答後に適用される。
Tier-1では5条件すべて同時に満たす必要がある:変更された全パスがエンベロープ内であること、すべてのゲートスクリプトがグリーン(ブリーフの4行。G6=テストスイートはGitHubのauto-mergeが自身で待つ必須ステータスチェック)、AIレビューが「merge」判定で測定済み、block/warnレベルの指摘ゼロ(infoは表示のみでtierには影響しない)、ヒューマン専用リストが空。5つすべて満たせば、ワークフローがActionsのIDでPRを承認し、GitHubのauto-mergeを有効化。必須チェック完了時に自動マージされる。1つでも欠ければ「needs human」ラベルが付き、ブリーフには未達成条件すべてが列挙される(最初の1つだけで止めない)。この仕様はユニットテスト由来:初期実装は最初の失敗で早期リターンしていたため、たとえば「パスがエンベロープ外」を直して再実行して初めてwarnレベルの指摘に気づく、という事態になった。理由が3つなら3つとも出すべきだ。
GitHubの2つの設定がボットの承認を有効にする:リポジトリがActionsによるプルリクエスト承認を許可していること[3]、およびブランチ保護[1]で承認者がコードオーナーである必要がないこと(ActionsのIDはコードオーナーではないため)。auto-merge自体はGitHubの機能[2]であり、ワークフローはそれを有効化するだけ。code-ownersファイルは引き続き人間へのレビューリクエストを振り分ける。保護スクリプトはデフォルトで「コードオーナー不要・1件の承認必須」とし、適用後に両方のリポジトリ設定を出力する。なぜなら無料プランではauto-merge設定が黙って無視されるため、設定を読み返さないスクリプトは嘘をつくことになるからだ。
初日:レビュアーの最初の2件の判定は自分自身へのレビューだった
ワークフローはPRで導入され、そのPRが最初のレビュー対象となった。まだAPIキーはリポジトリに設定されていなかった。ブリーフにはこう書かれていた:「unmeasured: ANTHROPIC_API_KEY missing(リポジトリシークレット未設定)。This is not 'no problem'.(訳:これは「問題なし」ではない。)」。その下に4つのゲートスクリプト(すべてグリーン)、tier行は「needs human」。なぜなら変更パスにワークフローとスクリプトディレクトリが含まれており、AIレビューも未測定だったからだ。
共同創業者がシークレットを追加した。次のPR――エンベロープ追加のPR――が、レビューアにとって2件目のレビュー対象となった。ブリーフには「unmeasured: AuthenticationError 401, invalid x-api-key.」と記載されていた。ティアの行と2つの理由は前回と同じだが、今回は「プラットフォームに渡したキーが受け入れられなかった」という3つ目の理由が加わった。
これは「失敗談」ではなく、設計が本来想定した負荷下でどう動くかを示す初日の結果として記録している。もし両方の実行でレビューアが何も出さなければ、見かけ上レビュー済みだが実際には未レビューのPRが2件生まれていたはずだ。実際には、2件とも「AIが動かなかった理由」と「それが人間にとってどういう意味か」を明示したコメントが残った。仕組みはどちらも自動マージしなかった。両方ともエンベロープ外で、2件目はさらに別の条件も満たしていなかった。偽グリーン(誤った合格)はゼロ。範囲は2回の実行、1リポジトリ、1日――「正直な」ブランチの数字である。
同じ日に、もう一段下のレイヤーでも2回目のサイレントな失敗が発生した。ブランチプロテクションはプライベートリポジトリでは有料機能で、アップグレードは購入済みだったが、APIは有料アップグレードに対して10分間連続で403を返し、auto-merge設定はfalseに戻された。プロテクションスクリプトはこの場合アップグレードURLを出して非ゼロ終了する。ごまかしはしない。アカウントレベルの原因は執筆時点でまだ調査中であり、これが最後の条件の「正直な」状態として本文に記載されている。これは、ブリーフが「unmeasured」を投稿するのと同じ理由で脚注ではなく本文に載せている。
パターン・アンチパターン・第一原則
機能したパターン エビデンスをスキーマフィールドとして持ち、存在でフィルタし、ドロップ数を明示する。失敗状態は「何も出さない」のではなく、必ずセクションとして表示する。決定的なチェックはスクリプトの出力をそのまま添付し、モデルで再判定しない。ルールは1つのデータファイルに集約し、同じ関数でプロンプトとドキュメントにレンダリング、CIでドリフトチェックをかける。ブラスト半径はパスプレフィックス+deny-winsで表現し、モデルの回答後に適用。満たされなかった条件はすべて列挙し、最初の1つだけで止めない。
置き換えたアンチパターン 勝手に承認するレビューア。「問題なし」を意味してセクションを省略するブリーフ。根拠の代わりに信頼度スコアを使う。プロンプトとドキュメントで二重管理されるルール。資格情報がないときに黙ってスキップする。3つ理由があるのに1つだけ報告して早期リターンする。どれも最初は合理的に見えるが、10件目のPRでレビューアを無視しやすくする要因になる。
第一原則を一文で レビュー信号は「不在」と「失敗」の両方が見えるときだけ読む価値があり、主張は信頼せずに検証できなければならない。本記事の他すべては、この一文をマージボタンに適用したものだ。
30分で作る
これはコードではなく「契約」だ。コードはリポジトリ固有だが、契約は持ち運べる。30分というのは、この表を新しいリポジトリにコピーする読者のために契約が設定する予算であり、私が計測した時間ではない。ここに示すシェルは一気に書き上げ、テスト・2つのドキュメント・初日の実行で残りの時間を使った。
| 要素 | 仕様 |
|---|---|
| 入力 | PRのマージベースとの差分(リスク順、アプリケーションコード優先、文字数上限あり)、省略されたファイルはすべて名前付きでブリーフに記載。PRのタイトルと本文。各既存マシンゲートの合否と直近6行の出力。ルールファイルからレンダリングされたルール表。 |
| 出力 | 構造化オブジェクト:needs_human[] ルール・質問・理由を含むもの;needs_human_empty_reason; substance; risks[] およびconflicts[] ルール・重大度(block, warn, info)・主張・evidence[]を含むもの;verdict {merge, hold, request_changes} のいずれか;verdict_reason; post_merge_checks[]; global_notes[]。8つのセクション(needs your judgment, substance, risks, conflicts, verdict, post-merge checks, auto-merge tier, machine gates)で1つのMarkdownコメントとしてレンダリングし、再実行時は追記でなく編集となるよう隠しマーカーを付与。 |
| 不変条件 | すべての出力ファインディングには、少なくとも1つ、path:line に一致し、そのパスが実際に存在するエビデンス文字列が含まれている。ブリーフは失敗時も含めて毎回投稿される。マシンゲートの結果はスクリプト出力をそのまま添付する。ヒューマンリストが空の場合は必ず理由を明記する。 |
| 停止ルール | モデルはPRイベントごとに一度だけ呼び出す。拒否やパース失敗時のリトライはなく、それらは「unmeasured(未計測)」として扱う。エラーが起きてもジョブは継続し、レビュワーが落ちていてもマージを止めず、必ず可視化される。 |
| 最小スキーマ | ルールファイル:{id, level ∈ {block, ai, human}, title, check, gate, source}(machine tierはファイル内でblockと記載され、マージボタンへの影響の後に置かれる)およびauto_merge: {allow_prefixes, allow_suffixes, deny_prefixes}。これが設定の全体だ。 |
| CIの閾値 | オートマージは5つの条件がすべて揃ったときだけ発動する。ドキュメントドリフトチェック(--check-doc)は必須の静的ゲート。レビュワー自身のジョブは必須チェックに含めない。 |
| 意図的に省いたもの | リトライなし、判定役としてのセカンドモデルなし、信頼度スコアなし(ファインディングはエビデンス付きか却下されるかのどちらか)、ルールごとの重み付けなし、過去PRからの学習なし。これらはどれも、初期バージョンが「賢く」なる代わりに監査性を失うポイントだ。 |
| ネガティブテスト | 本番運用前に:既知の欠陥を含むPRをリプレイする。このリポジトリの場合、createエンドポイントがclosedステータスを直接受け入れるのを止めた修正が候補で、その3つのコードファイルを元に戻すと、ルーターを指すblockレベルのR2ファインディングが出るはずだ。これで赤にならないレビュワーは「ライブ」とは呼べない。この実行は有効なキー待ち。 |
# The whole loop, from a PR event
diff, omitted   = collect_diff(merge_base, changed_files)      # risk-ordered, capped, omissions listed
gates           = run_machine_gates(base)                       # scripts decide; last 6 lines kept
review          = call_model(meta, files, diff, gates, rules)   # structured output, one call, no retry
review, dropped = filter_findings(review, files)                # path:line or it is gone; count kept
tier, reasons   = classify_tier(brief, envelope)                # five conditions, all reasons listed
brief           = render_brief(...)                             # never silent; unmeasured is a section
post_comment(pr, brief); apply_tier(pr, tier)                   # upsert; approve + auto-merge only on tier-1
同じ話、5つの出口
| 読者 | 唯一の判断 | 唯一のアクション |
|---|---|---|
| 学生 | ゲートは、自分で赤くなったのを見て初めてゲートになる。 | 自分が頼っているチェッカーを何でもいいので、わざとチェック対象を壊してみて、ちゃんと失敗するか確かめよ。失敗しなければ、それはただの飾りだ。 |
| エンジニア | エビデンスはプロンプトでお願いするものではなく、スキーマで強制する制約である。 | をレビュアーの出力に加え、evidence[] でフィルタし、path:line の有無でドロップ数を表示せよ。 |
| Founder | 自動マージは「被害範囲(blast radius)」の判断だ。その範囲はデータファイルで管理せよ。 | プロンプトを書く前に、許可パス・拒否パスのリストを用意し、拒否リスト優先(deny wins)にせよ。 |
| Executive | 「レビューがある」と「レビューが実際に走った」は別物だ。後者を必ず計測せよ。 | レビュー記録ゼロのPR数と、「unmeasured」と報告したレビュアー実行回数を尋ねよ。 |
| Investor | 植え込んだ欠陥でレビュアーが赤を出すチームにはレビュー工程がある。緑しか見せないチームはスクリーンショットしか持たない。 | ネガティブテストを見せてもらえ。 |
何が測定されていて、何がまだか
- 測定済み。 エビデンスフィルタ、unmeasuredのレンダリング、envelopeのdeny-wins動作、5条件ティアロジックとその累積理由、doc-driftチェックを14本のユニットテストで固定している。実PRで2回ライブ実行し、2つの「unmeasured」ブリーフとサイレント出力ゼロを確認した。どちらのPRも理由付きでneeds-humanに分類された。
- 未測定。 ネガティブテスト(植え込んだ欠陥でblockレベルの指摘が出る)はPRとしてオープンで、有効なキーが入り次第実行予定。赤が出るまで、レビュアーはインストール済みでも自分のルール上「ライブ」ではない。Tier-1の正パス(ドキュメントのみのPRがbotで承認・マージ)はブランチ保護で止まっており、その保護自体がアカウントプランの問題でブロックされている。AIの指摘精度については、実コードでの数値はまだない。エビデンスフィルタは最低限の基準であり、測定値ではない。
- 図解。 キッチン。仕組みの対応関係を示すだけで、データではない。
次に読む
シリーズ:AI-Nativeシリーズ・エージェントエンジニアリング。この記事の数値は、それぞれ記載箇所ごとに限定している。キッチンの例はあくまでモデルであり、実測値ではない。ここで説明したルールファイル、レビュアー、ワークフロー、保護スクリプト、テストはすべてプライベートリポジトリ内に実在するが、形や仕組みはすべて本文中に完全再現しているため、アクセス権の有無に左右されない。
参考文献
- GitHub Docs. 保護ブランチについて。 docs.github.com — 必須ステータスチェック、必須レビュー、プライベートリポジトリでの保護機能のプランごとの可用性。
- GitHub Docs. プルリクエストの自動マージ。 docs.github.com — Tier-1が前提とする自動マージの挙動。
- GitHub Docs. リポジトリのGitHub Actions設定の管理。 docs.github.com — ワークフローがプルリクエストを承認できるようにする設定。
- Anthropic. 構造化出力。 docs.anthropic.com — 証拠フィルターが作用するスキーマ制約付きレスポンス。
- Sadowski, C., Söderberg, E., Church, L., Sipko, M., Bacchelli, A. (2018). Modern Code Review: A Case Study at Google. ICSE-SEIP, DOI 10.1145/3183519.3183525. research.google · author's copy (PDF) — 本文では引用せず内容のみ記述:12件のインタビュー、44名のアンケート、900万件のレビュー済み変更ログを分析。
- Bacchelli, A., Bird, C. (2013). Expectations, Outcomes, and Challenges of Modern Code Review. ICSE 2013. author's copy (PDF) — 上記の引用はこの著者版PDFの要旨からのものであり、PDFと一語一句照合済み。IEEEの正式版とは書式が異なる場合がある。