AI-Native 系列 · 智能体系统的控制
点单小票
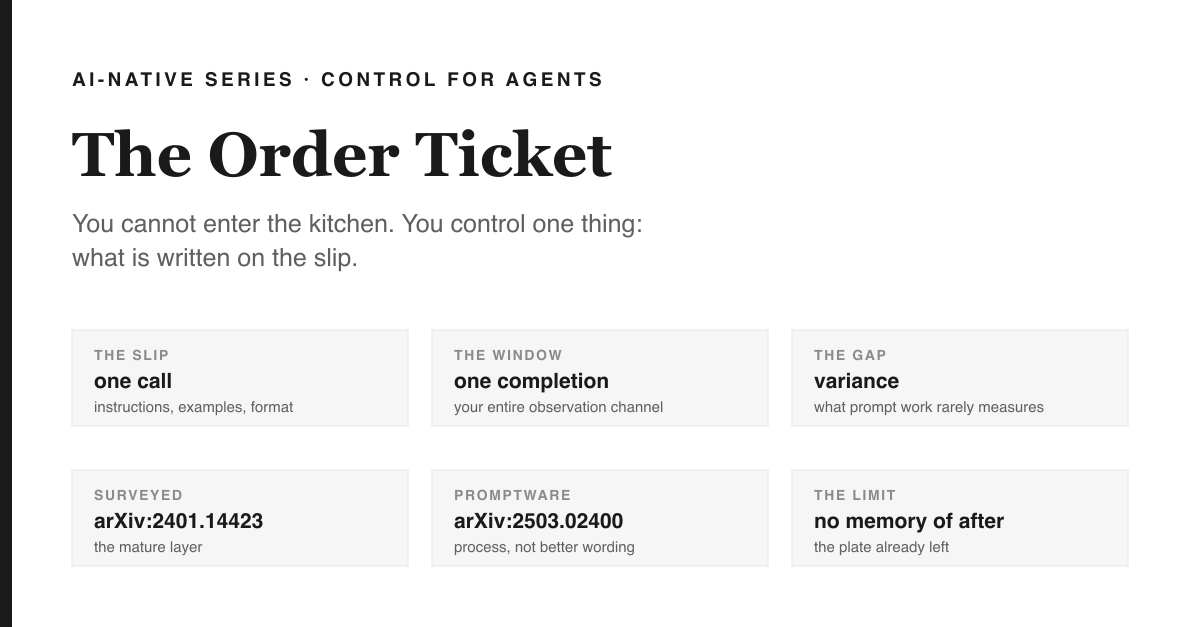
1 分钟速览——你将带走的核心观点
提示工程是四层中唯一有系统综述的一层,这一季从它开篇,算是对它的公允。它的工作单位就是一次模型调用,这也是它的天花板:无论怎么改写,提示都无法得知答案返回后发生了什么。提示工程文献里最有价值的发现,其实不是某个技巧,而是 Promptware Engineering 提出的观点:提示需要版本管理、测试和责任人。这不是在教你怎么润色措辞,而是在强调提示背后的工程流程——这正是下一集的主题。
冷开场
一间忙得不可开交的厨房。你进不去,碰不到锅,尝不到酱,也不能让厨师重做。你唯一的控制手段,就是一张写好内容、从窗口递进去的小纸条。
7号桌。鸡肉。不要花生。中辣。二十分钟。
你能施加的所有影响,都必须浓缩在这张纸条上。这就是提示工程,而这个限制不是比喻——它就是接口本身。一次模型调用,对应一张纸条。
本集之所以排在最前、而且很短,是因为这就是整个体系里最成熟的一层。它有真正的文献、系统的综述和成熟的方法。后面的内容,讲的都是当纸条不再够用时,会发生什么。
设定世界
这间厨房有一条规则,贯穿整个季:你始终只能在门外。你无法干预厨师的流程,只能决定写在纸上的内容,以及窗口递回来的结果。后续每一集,都是在不能进厨房的前提下,想办法争取更多控制权——先是重建厨房(第二集),再是盯着盘子回来后重发纸条(第三集),最后是同时开好几间厨房(第四集)。
一一对应的技术映射
| 厨房 | 技术术语 | 你真正能控制的部分 |
|---|---|---|
| 那张纸条 | prompt | 指令、示例、输出格式、角色设定 |
| “不要花生” | 一个约束 | 在内容中直接声明的硬性要求 |
| “中辣” | 一个未充分指定的字段 | 最主要的方差来源 |
| 窗口上摆着的两盘示例菜 | 少量示例 | 上下文学习 |
| “二十分钟” | 时间预算 | 这一层唯一能设定的终止条件 |
| 菜品端回来的窗口 | 一次生成 | 你能看到的全部反馈 |
主张类型
[DEF]提示工程指的是为一次模型调用或一次简短交互(arXiv:2401.14423,Prompt Design and Engineering)设计指令、示例、输出格式和角色设定。其基本工作单元就是一次调用。
[EVIDENCE]这是目前唯一有系统综述的环节。Prompt Design and Engineering(arXiv:2401.14423)不仅梳理了核心方法,还覆盖了 ReAct、ReWOO、DERA 等智能体相关技术——值得注意的是,这说明“agent loop”类方法在被单独命名前,已经被纳入提示工程的研究范畴。
[DESIGN] Promptware Engineering(arXiv:2503.02400)为本季提出了关键观点:提示也应配备软件工程的标准流程——需求、测试、版本管理、维护。请注意这个论证的重点:它并不是说提示需要更好的措辞,而是说提示需要围绕它们的流程规范。这已经是走出厨房、迈向 harness 的第一步。
[OPEN]我们通常认为 prompt 质量带来的提升,其实有多少其实归因于 harness 的能力——比如检索、上下文组装、工具可用性——在实际从业者文献中并没有被清晰区分。当“更好的 prompt”与上下文窗口调整同时上线时,归因就变得模糊。
预测闸门
继续往下读前,先写下你的答案。写下来,重点是它可以错。
有个团队把一个 agent 的任务成功率从 61% 提升到 78%。他们在同一周做了两件事:重写了系统 prompt,并加了一个仓库文件检索步骤。
下注:到底是哪一项带来了主要提升?做什么实验能一锤定音?
大多数人会押 prompt,因为 prompt 是他们能直接读到的。唯一能定论的实验是消融实验——用旧 prompt 上线检索功能——而这个实验很少有人做,因为没人愿意花一周时间证明自己的文案其实没啥用。
失效间
故意让它出错:去掉输出契约,其他都保留。
拿一个能稳定返回结果的 prompt,{"status": ..., "retryable": ...},把 schema 那一行删掉,只留任务描述。模型依然能完成任务,文字描述也还在。真正出问题的是所有下游——解析器、重试逻辑、负责读取的评估器retryable.
诊断比故障本身更关键:在这一层,格式错误和能力不足的故障,在下游读取输出前是无法区分的。这正是本季要讲的那个缺失层的第一个症状。小票没问题,厨房没问题,但没有任何仪器在窗口盯着。
实验室——15 分钟
把一个 prompt 当作待测的规范来对待。
- 挑一个你常用的提示,把它的输出要求写成断言——需要有哪些字段、类型、枚举值、长度限制。
- 在 temperature 设为 0 时跑 20 次,统计断言失败的次数。然后用你线上环境的 temperature 再跑 20 次。
- 现在只改动 instruction 里的一个词(不是 schema),再重复实验。
你在测量大多数提示工程从未关注的指标:方差,而不是质量。均值更高但方差更大的提示,对需要解析输出的系统来说,往往反而更糟。
现实任务
找出你系统里访问量最高的提示,给它加上版本号、测试文件和负责人。这就是 Promptware Engineering(arXiv:2503.02400)整篇的核心建议,半天就能落地,也是这个层面最划算、最持久的提升。
研究挑战
用 agent 去做那场没人愿意做的归因实验。选一个公开的 agent 基准 harness,先固定提示,去掉上下文组装步骤;再固定上下文,去掉提示。把两组差值并排展示。要验证的观点是:在有检索和工具的系统里,提示的改动对方差的解释力,其实比从业者想象的小。 这个问题目前仍是 [OPEN],而且可以量化。
离场测试
能不看答案答出这三题,你就可以毕业本集:
- 这个层面的工作单元是什么?(一次模型调用)
- 无论 slip 写得多好,这一层唯一做不到的是什么?(观察盘子离开窗口后发生了什么)
- 《Promptware Engineering》真正主张的是什么Promptware Engineering,究竟是在追求更精妙的措辞,还是强调配套的流程?
悬念留到下集
这张小票已经做到尽善尽美:schema 已经强制,约束写得清楚,预算也标明了。但厨师还是看不到你指定的文件,跑不了你关心的测试,也说不出这道菜为什么端回来不对。
于是你不再纠结怎么写更好的小票,而是开始重塑厨房。就在这里,术语也开始变得模糊——因为接下来大家都会提到的词是harness,而它最常被引用的定义,正悄悄打破我们习惯画的那张整齐分层图。
继续阅读
第六季第一集:Intelligence Engineering Adventures, Season 6 — The Governor Engine。本系列所有论断均按类别标注——定义、推导、证据、工程选择、开放问题——比喻可以引出观点,但永远不能作为证据。全季都严肃对照四分图和一手资料,结果发现并不成立:Anthropic 的定义把 harness 归为 loop,而不是更高一层。每条论断都明示类别,唯一真正开放的问题也明确标注为 open——目前还没有人发表过 LLM 控制回路的稳定性判据。本文不含任何雇主或客户的内容。——Paul Jialiang Wu · futuremake.io
参考文献
- Prompt Design and Engineering: Introduction and Advanced Methods——arXiv:2401.14423。系统梳理提示工程方法,包括 ReAct、ReWOO 和 DERA。2026-08-24 经 arXiv 验证。
- Promptware Engineering: Software Engineering for Prompt-Enabled Systems—— arXiv:2503.02400。注意:本季策划时引用为“Software Engineering for LLM Prompt Development”;编号无误,标题以此为准,已核查。
- Anthropic,Building Effective AI Agents——明确区分了预设编排(“workflows”)和模型自主调度流程与工具(“agents”)的系统。https://www.anthropic.com/engineering/building-effective-agents